Claude Fable 5.1: обзор модели для долгой автономной работы
Anthropic обновила старшую модель Claude 5. Разбираю, что нового в Fable 5.1, почему подешевевший кэш важнее бенчмарков и стоит ли переходить с Opus 5.
TL;DR: Anthropic выпустила Claude Fable 5.1 — обновление старшей модели Claude 5, заточенное под долгие автономные задачи. Ставка за токены не изменилась ($10 за миллион входных, $50 за выходных), но чтение из кэша подешевело вчетверо, и типичная нагрузка выходит примерно на 25% дешевле Fable 5, а сильно агентная — до 45%. Модель доступна с 1 сентября 2026 как claude-fable-5-1.Главная цифра анонса не бенчмарк, а прайс на чтение кэша. Он упал с $1 до $0,25 за миллион токенов. Для агентного цикла, где один и тот же контекст перечитывается на каждом шаге, это и есть основная статья расходов. Fable-класс наконец стал экономически осмысленным для того, что раньше держали на Opus.
Что нового в Claude Fable 5.1 против Fable 5
Под капотом Fable 5.1 и Mythos 5.1 — снова одна модель с разными фильтрами, схема та же, что была у Fable 5 в июне. Изменения такие.
Модель стала заметно сильнее на верхних уровнях усилий и заметно дешевле на нижних. Anthropic пишет, что на low и medium Fable 5.1 выдаёт результат уровня Fable 5, но за меньшие деньги. Уровней теперь пять: low, med, high, xhigh, max.
Она меньше срезает углы. Формулировка из анонса: «умеет чинить причину, а не симптом».
Общение стало суше. Fable 5.1 пишет меньше статусных сообщений между вызовами инструментов, а её саммари по агентному кодингу короче. Если твой интерфейс их показывает, гайд по миграции советует выставить thinking.display в "updates" и просить обновления явно.
Контекст остался прежним: 1 млн токенов на вход, 128k на выход. Надёжный срез знаний датирован июнем 2026.
Долгая автономная работа
Anthropic собрала 22 отзыва от партнёров раннего доступа, и почти все они про одно: модель дольше держит нитку задачи.
Инженер Ramp Дуайт Темпл описывает 38-часовой прогон без присмотра: модель нашла, что прошлый результат был артефактом разметки, исправила его, запустила шесть параллельных экспериментов на ночь и вернулась с итогом и планом дальше. Отдельно он отмечает открытый промпт в духе «найди самую полезную проблему, которой никто не занимается» — модель вытащила бесхозный алерт, связанный с падением прода, подтянула логи и предложила фикс.
Рон Санзоне из MongoDB рассказывает про прототип за три дня: сначала исследование по всему коду сервисов и документации, потом часы автономной работы с верификацией, и каждое утро — готовая фаза с визуальным разбором сделанного. Бен Лафферти из Shopify формулирует то же короче: workflow крутится долго и не теряет сюжет, модель ведёт свои записи и подхватывает с места, где остановилась.
Самая конкретная история у Millennium. Портфельный управляющий по имени Дэмиен говорит, что редкий краш, примерно один на миллион запусков, никто в команде не мог объяснить четыре-пять лет. Fable 5 его не нашла. Fable 5.1 дизассемблировала стороннюю библиотеку, сопоставила с core dump и вывела баг внутри этой библиотеки.
Джош Бойер из Red Hat пишет, что через Claude Code модель верно определила причину каждого сломанного билда из тестового набора, на всех уровнях усилий.
Кто тестировал модель до релиза
Отзывы в анонсе оставили 22 компании: Jane Street, Cognition, Millennium, MongoDB, Every, IMC, Red Hat, Rakuten, Block, Ramp, Canva, Hebbia, Plaid, Glean, iGent, Browserbase, Rogo, Shopify, Crosby, Datadog, SpaceX AI и Samaya.
Скидку на маркетинг тут делай сам: это подборка от вендора, неудачные прогоны в неё не попали. Но набор историй однотипный, и все они про одно свойство — выносливость на длинной дистанции.
Бенчмарки: Fable 5.1 против Fable 5, Opus 5 и GPT-5.6 Sol
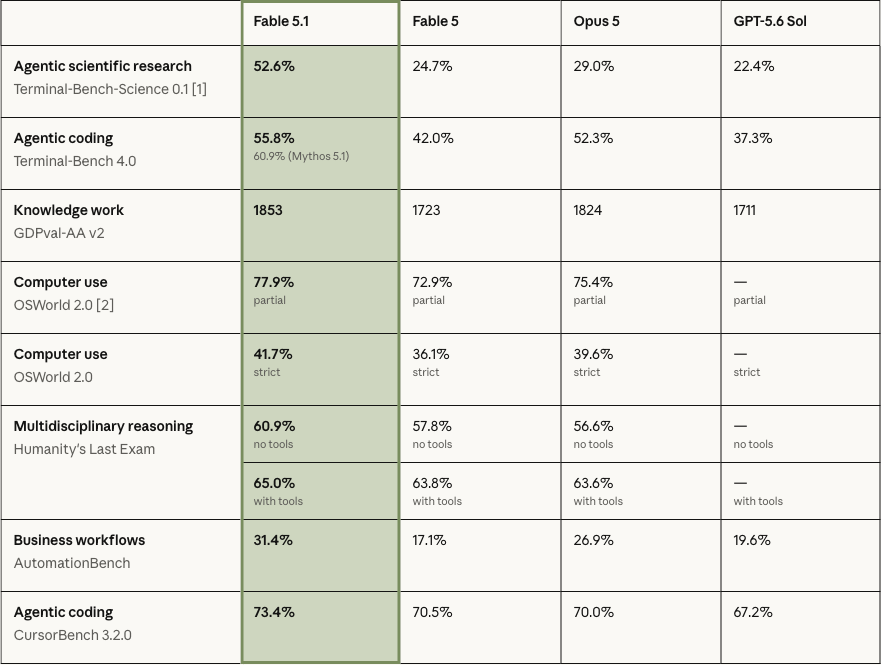
Самый крупный отрыв в агентных исследовательских задачах: 52,6% на Terminal-Bench-Science 0.1 против 24,7% у Fable 5 и 29,0% у Opus 5.
В агентном кодинге на Terminal-Bench 4.0 у Fable 5.1 получилось 55,8%, у Mythos 5.1 — 60,9%. Разрыв между ними Anthropic объясняет старыми киберфильтрами, которые срабатывали на части задач, и обещает, что после сегодняшнего обновления фильтров он сильно сократится.
По остальным направлениям картина ровная: 31,4% на AutomationBench против 17,1% у Fable 5, 1853 на GDPval-AA v2 против 1824 у Opus 5, 73,4% на CursorBench 3.2.0. Все цифры из анонса от 1 сентября 2026, замеры делала сама Anthropic, независимых прогонов пока нет.
Независимая цифра всё же есть одна. Мигель Гонсалес из Browserbase говорит, что на их самом сложном браузерном бенчмарке Fable 5.1 закрыла 82% задач примерно за 10 минут каждую, против 74% у Opus 5 и 57% у Fable 5, потратив при этом меньше токенов.
Быстрый старт: как включить Fable 5.1
- В API поменяй идентификатор модели на
claude-fable-5-1. Тот же ID работает на Amazon Bedrock, Google Cloud и Microsoft Foundry. - В Claude Code выбери модель через
/model. Уровень усилий по умолчанию — high, менять его отдельно не нужно, если задача обычная. - Если проект переезжает с Fable 5 или Opus 5, запусти в Claude Code встроенный скилл миграции:
/claude-api migrate this project to claude-fable-5-1. Он поменяет ID, поправит сломанные параметры и отдаст чеклист того, что надо проверить руками. - На подписках Pro, Max, Team и Enterprise модель доступна сразу, отдельного включения не требуется.
Что сломается при переезде с Fable 5
Переезд почти drop-in, но три вещи стоит проверить до прода.
Первое: форсированный выбор инструмента больше не работает. tool_choice со значением {type: "any"} или {type: "tool", name: "..."} возвращает 400. Осталось только auto и none. Anthropic советует оставить auto, назвать нужный инструмент прямо в инструкции и выставить strict: true, чтобы вызов лёг в схему.
Второе: блоки размышлений теперь привязаны к модели. Fable 5.1 читает thinking-блоки от Opus 5, Fable 5, Mythos 5 и более ранних моделей, но обратной совместимости нет: старые модели её блоки прочитать не могут. Если разговор откатится на модель постарше через роутер или fallback, API молча выкинет нечитаемые блоки, и первый ход после переключения обойдётся дороже.
Третье: редактирование прошлых ходов ломает эти блоки. Каждый thinking-блок валиден только против того системного промпта, набора инструментов и истории, которые ему предшествовали. Если ты сам собираешь массив messages и делаешь клиентскую компакцию, запрос упадёт с 400. Лечится либо серверной компакцией, либо заголовком thinking-binding-controls-2026-08-01 с prefix_mismatch_behavior: "drop_block". Если историю ведёт Claude Code, claude.ai или Agent SDK, тебя это не касается.
Из приятного: уровень усилий теперь можно менять посреди разговора системным сообщением с одним output_config, не сбивая кэш промпта. Раньше смена effort роняла кэшированные префиксы предыдущих ходов, и это било по цене ровно там, где длинная сессия.
Ещё две поведенческие мелочи. В длинных агентных циклах Fable 5.1 чаще делает один вызов инструмента за ход вместо пачки параллельных, лечится односложной инструкцией про батчинг. И на low effort она чаще отвечает по памяти, вместо того чтобы дёрнуть поиск, так что если продукт завязан на retrieval — поднимай усилия для таких запросов.
Цена: почему кэш важнее ставки за токены
| Модель | Вход | Чтение кэша | Выход |
|---|---|---|---|
| Fable 5.1 | $10 | $0,25 | $50 |
| Fable 5 | $10 | $1,00 | $50 |
| Opus 5 | $5 | $0,50 | $25 |
| Sonnet 5 | $2 | $0,20 | $10 |
Цены за миллион токенов, по странице модели. Batch API режет вход и выход вдвое, до $5 и $25.
Смотри на второй столбец. В агентной сессии один и тот же системный промпт, набор инструментов и накопленная история перечитываются на каждом шаге цикла, и уходят они именно в чтение кэша. Отсюда и обещанные 45% экономии на сильно агентных нагрузках против 25% на обычных.
Уолден Ян из Cognition говорит так: они переводят трафик Opus 5 в Devin на Fable 5.1 в день запуска, начиная с code review, потому что с новой ценой на кэш модель Fable-класса впервые окупается на задачах, которые до этого держали на Opus.
Отдельная строка мелким шрифтом: если нагрузка обязана крутиться в США, инференс только в американских регионах стоит 1,1x от базовой цены на вход и выход.
Safeguards и Mythos 5.1
Схема осталась прежней. Fable 5.1 доступна всем, но с фильтрами. Mythos 5.1 — та же модель со снятыми ограничениями, её дают только проверенным организациям. Что поменялось.
Киберфильтры стали на 60% реже ловить безобидное. Причина в том, что Fable 5.1 теперь разрешено искать уязвимости в софте, но не писать под них эксплойты. Пентест, генерация эксплойтов и поиск уязвимостей в бинарниках по-прежнему уходят на Opus. В биологии ложных срабатываний на элементарных вопросах стало меньше на 85%, а серьёзный R&D открывают через новую программу проверки для наук о жизни, сделанную вместе с правительством США. Заявка на киберпрограмму — через портал программ Anthropic.
Появилась невидимая текстовая водяная метка, это требование EU AI Act для моделей, выпущенных после 2 августа 2026. API для её детекта пока в приватном превью, доступ дают регуляторам, медиа, фактчекерам и исследователям.
Кому стоит переходить
Если ты гоняешь длинные агентные сессии в Claude Code или в своих пайплайнах, переходи. Связка «дешевле кэш плюс выносливость на многочасовых задачах» бьёт ровно в ту статью расходов, которая в агентных сценариях главная. Дэн Шиппер из Every описал это формулой «интеллект Fable, цена Opus, скорость Sonnet». Судя по цифрам от Browserbase и Cognition, преувеличение тут умеренное.
Если у тебя короткие синхронные запросы, картина другая. Вход и выход стоят вдвое дороже Opus 5, кэш при коротких сессиях не спасает, а на простых задачах разрыв в качестве ты не заметишь. Opus 5 остаётся разумным дефолтом, и документация Anthropic сама это говорит: начинай с Opus 5, бери Fable 5.1, когда твои прогоны на Opus с поднятыми усилиями всё ещё не дотягивают.
Что ещё почитать
- Claude Fable 5: что умеет, цена и доступ к Claude 5 — разбор предыдущей версии, от которой считается вся экономия
- Claude Opus 5: обзор модели и что меняется в API — модель, с которой Fable 5.1 конкурирует за роль дефолта
- Модель и effort level в Claude Code: как это работает — про уровни усилий, которых в Fable 5.1 теперь пять
- Claude Code /goal: автономная работа Claude до результата — режим для тех самых многочасовых прогонов без присмотра
Частые вопросы
Сколько стоит Claude Fable 5.1? $10 за миллион входных токенов и $50 за миллион выходных, как у Fable 5. Подешевело чтение кэша: $0,25 вместо $1. Для типичных нагрузок это около 25% экономии, для сильно агентных — до 45%.
Чем Fable 5.1 отличается от Mythos 5.1? Это одна модель с разными фильтрами. Fable 5.1 доступна всем, Mythos 5.1 — только проверенным организациям через программы доступа в кибербезопасности и науках о жизни.
Что сломается при переходе с Fable 5? Три вещи: форсированный tool_choice возвращает 400, блоки размышлений привязаны к модели и к неизменной истории разговора, а поведение в агентных циклах поменялось. Автоматическую миграцию делает команда /claude-api migrate в Claude Code.
Стоит ли брать Fable 5.1 вместо Opus 5? Для длинных автономных задач — да. Для коротких синхронных запросов Opus 5 вдвое дешевле по токенам, и разницы в качестве ты, скорее всего, не увидишь.