GLM-5.3 от Z.ai: обзор модели, бенчмарки и цены
Открытая модель Z.ai для кода и кибербеза: что показали бенчмарки и NIST, где скачать веса, сколько стоит подписка и как подключить её к Claude Code.
· обновлено · 12 мин
По замеру Z.ai GLM-5.3 на уровне high решает больше задач, чем Claude Opus 4.8, и тратит в 2,4 раза меньше токенов. Независимый замер Artificial Analysis этого не подтвердил: 135 млн выходных токенов при медиане 104 млн у сопоставимых моделей. GLM-5.3 — открытая модель Z.ai (бывшая Zhipu AI) для кодинга и агентных задач. В бенчмарках по коду она держится рядом с закрытыми флагманами прошлого поколения, а попробовать её проще всего через GLM Coding Plan за $18 в месяц прямо в Claude Code.
С этой моделью так почти везде: у вендора одна цифра, у независимой проверки другая. Z.ai пишет, что GLM-5.3 нашла 2436 уязвимостей в 269 проектах с открытым кодом. Американский институт NIST в сентябре назвал её самой сильной в кибербезе открытой моделью, но по его же оценке она отстаёт от лучших американских примерно на четыре месяца.
Я написал обзор в день выхода, 17 августа, и с тех пор многое поменялось: веса открыли, лицензия оказалась не MIT, появились независимые замеры. В ноябре я обновил текст и сверил каждую цифру с первоисточниками.
В статье разберём:
- что такое GLM-5.3 и чем она отличается от GLM-5.2;
- что показывают бенчмарки и независимые замеры;
- как модель нашла 2436 уязвимостей и что о них известно сейчас;
- что выяснил NIST, когда её проверил;
- как скачать веса и на чём их запускать;
- как подключить GLM-5.3 к Claude Code;
- сколько стоит подписка и доступ по API;
- кому она подойдёт, а кому нет.
Что такое GLM-5.3 и чем она отличается от GLM-5.2
В основе GLM-5.3 лежит та же базовая модель, что и у GLM-5.2, только дообучали её гораздо дольше. Нового претрейна не было, Z.ai прямо пишет: «scaling post-training is all we did». Весь прирост дало обучение с подкреплением на длинных задачах.
По карточке на Hugging Face у модели 753 млрд параметров. Это смесь экспертов (MoE): на каждый токен работают около 40 млрд из них, такую цифру даёт Artificial Analysis. Контекстное окно 1 млн токенов, ответ до 128 тысяч токенов.
Интересно, как Z.ai собирает задачи для обучения. Агенты-исследователи вытаскивают паттерны из реальной работы и превращают их в запускаемые окружения с многошаговыми зависимостями. Агент-судья проверяет, что задача вообще решаема. Проверку результата пишут без доступа к эталонному решению: иначе модель научится обходить награду, а не решать задачу.
Некоторые окружения тянут на несколько дней работы опытного инженера. Например, найти узкое место в ML-инфраструктуре, имея доступ к кластеру, хранилищу и внутренней документации, и ускорить обучение, ничего не сломав.
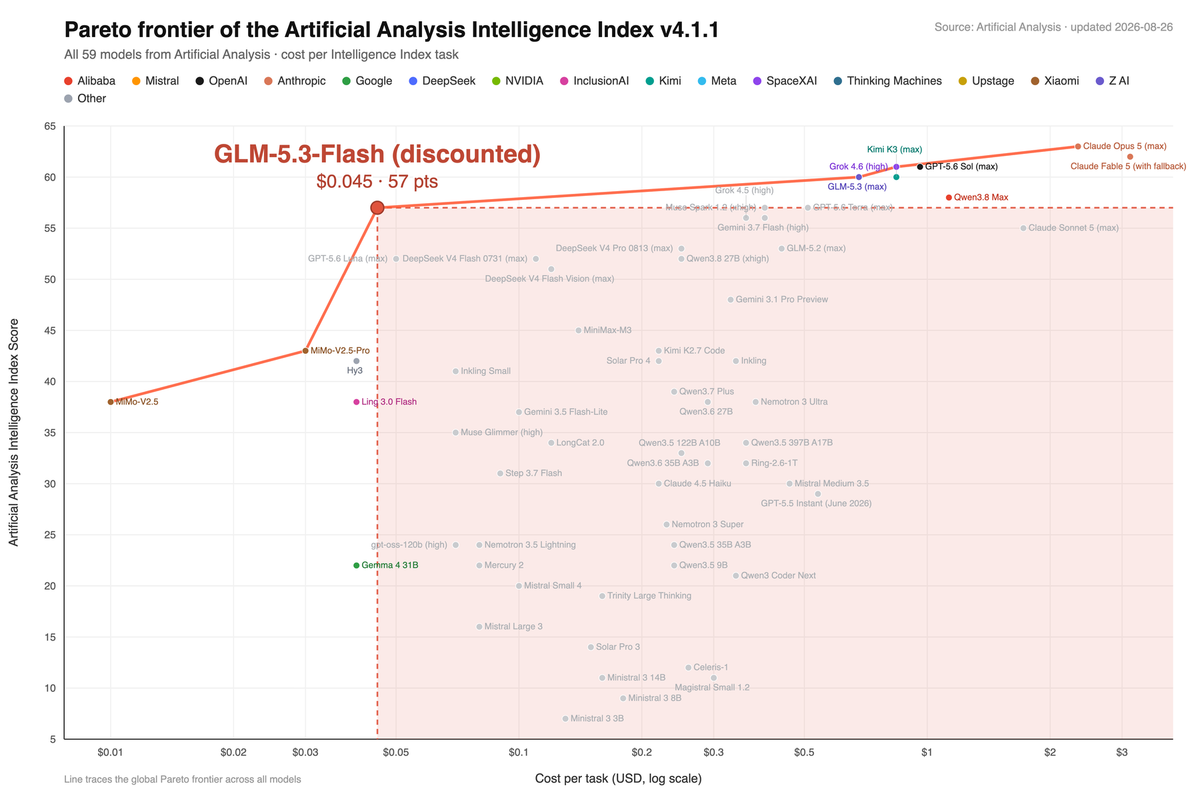
У модели есть младшая сестра. 26 августа вышла GLM-5.3-Flash: 320 млрд параметров, из них 18 млрд активных, с поддержкой картинок и под лицензией MIT. В подписке Z.ai она работает как быстрая модель для простых задач.
Что показывают бенчмарки GLM-5.3
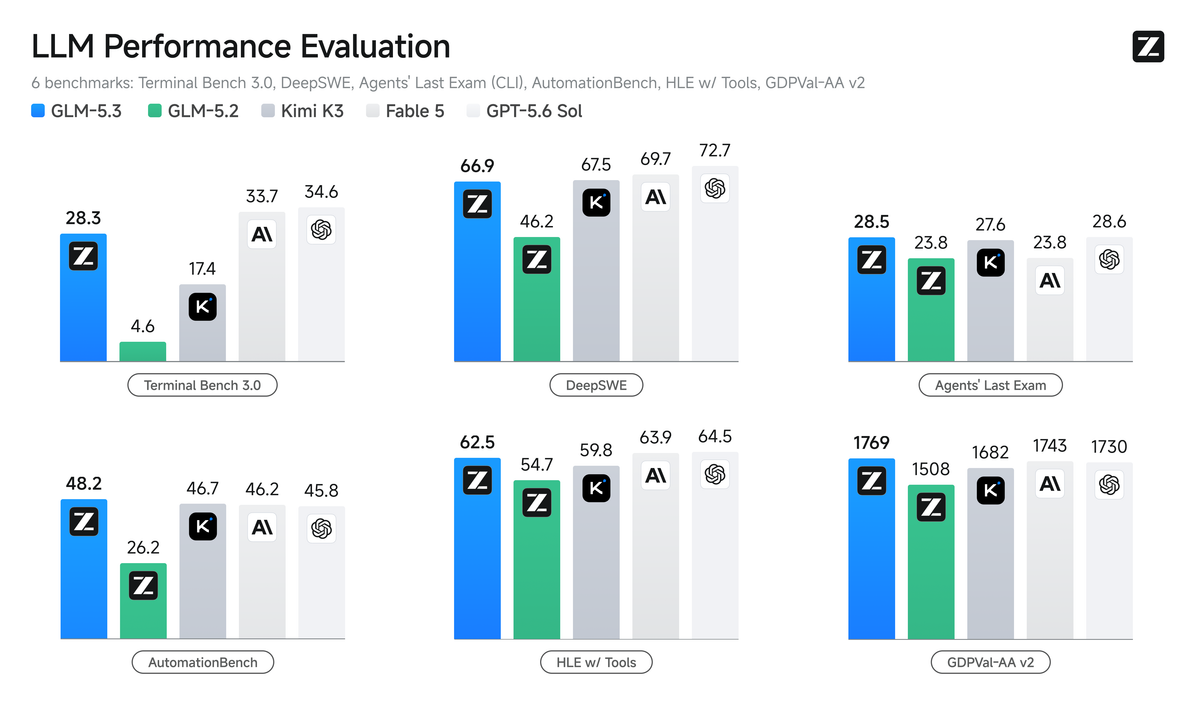
В анонсе Z.ai называет GLM-5.3 лучшей открытой моделью для кода. На внутреннем Z.ai Code Bench прирост к GLM-5.2 составил 50%. Вот публичные бенчмарки из того же анонса.
| Бенчмарк | GLM-5.3 | GLM-5.2 | Kimi K3 | Opus 4.8 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 88,2 | 81,0 | 88,3 | 85,0 | 88,0 | 88,8 |
| Terminal-Bench 3.0 | 28,3 | 4,6 | 17,4 | 21,1 | 33,7 | 34,6 |
| DeepSWE v1.1 | 66,9 | 46,2 | 67,5 | 58,0 | 69,7 | 72,7 |
| FrontierSWE | 78,1 | 67,5 | — | 66,5 | 88,2 | — |
| SWE-Marathon v1.1 | 42,5 | 19,4 | 48,1 | 48,8 | 33,1 | 42,5 |
| Agents' Last Exam | 28,5 | 23,8 | 27,6 | 25,7 | 23,8 | 28,6 |
Самый заметный скачок на Terminal-Bench 3.0: с 4,6 до 28,3. На FrontierSWE GLM-5.3 набирает 78,1 против 66,5 у Opus 4.8. Но есть и провалы: на SWE-Marathon её обходят Kimi K3 и Opus 4.8, на DeepSWE закрытые модели впереди.
Учти дату таблицы. Z.ai сравнивала себя с моделями лета 2026 года. С тех пор Anthropic выпустила Claude Fable 5.1 и Opus 5.5, OpenAI выпустила GPT-6 Astra. С ними GLM-5.3 никто из вендоров не сравнивал.

Сколько токенов тратит GLM-5.3
На эти цифры я смотрел в августе первым делом. По данным Z.ai, на максимальном уровне рассуждений модель решает 34,5% задач Z.ai Code Bench и тратит около 75 тысяч выходных токенов на задачу. GLM-5.2 решала 23,4% при 96 тысячах.
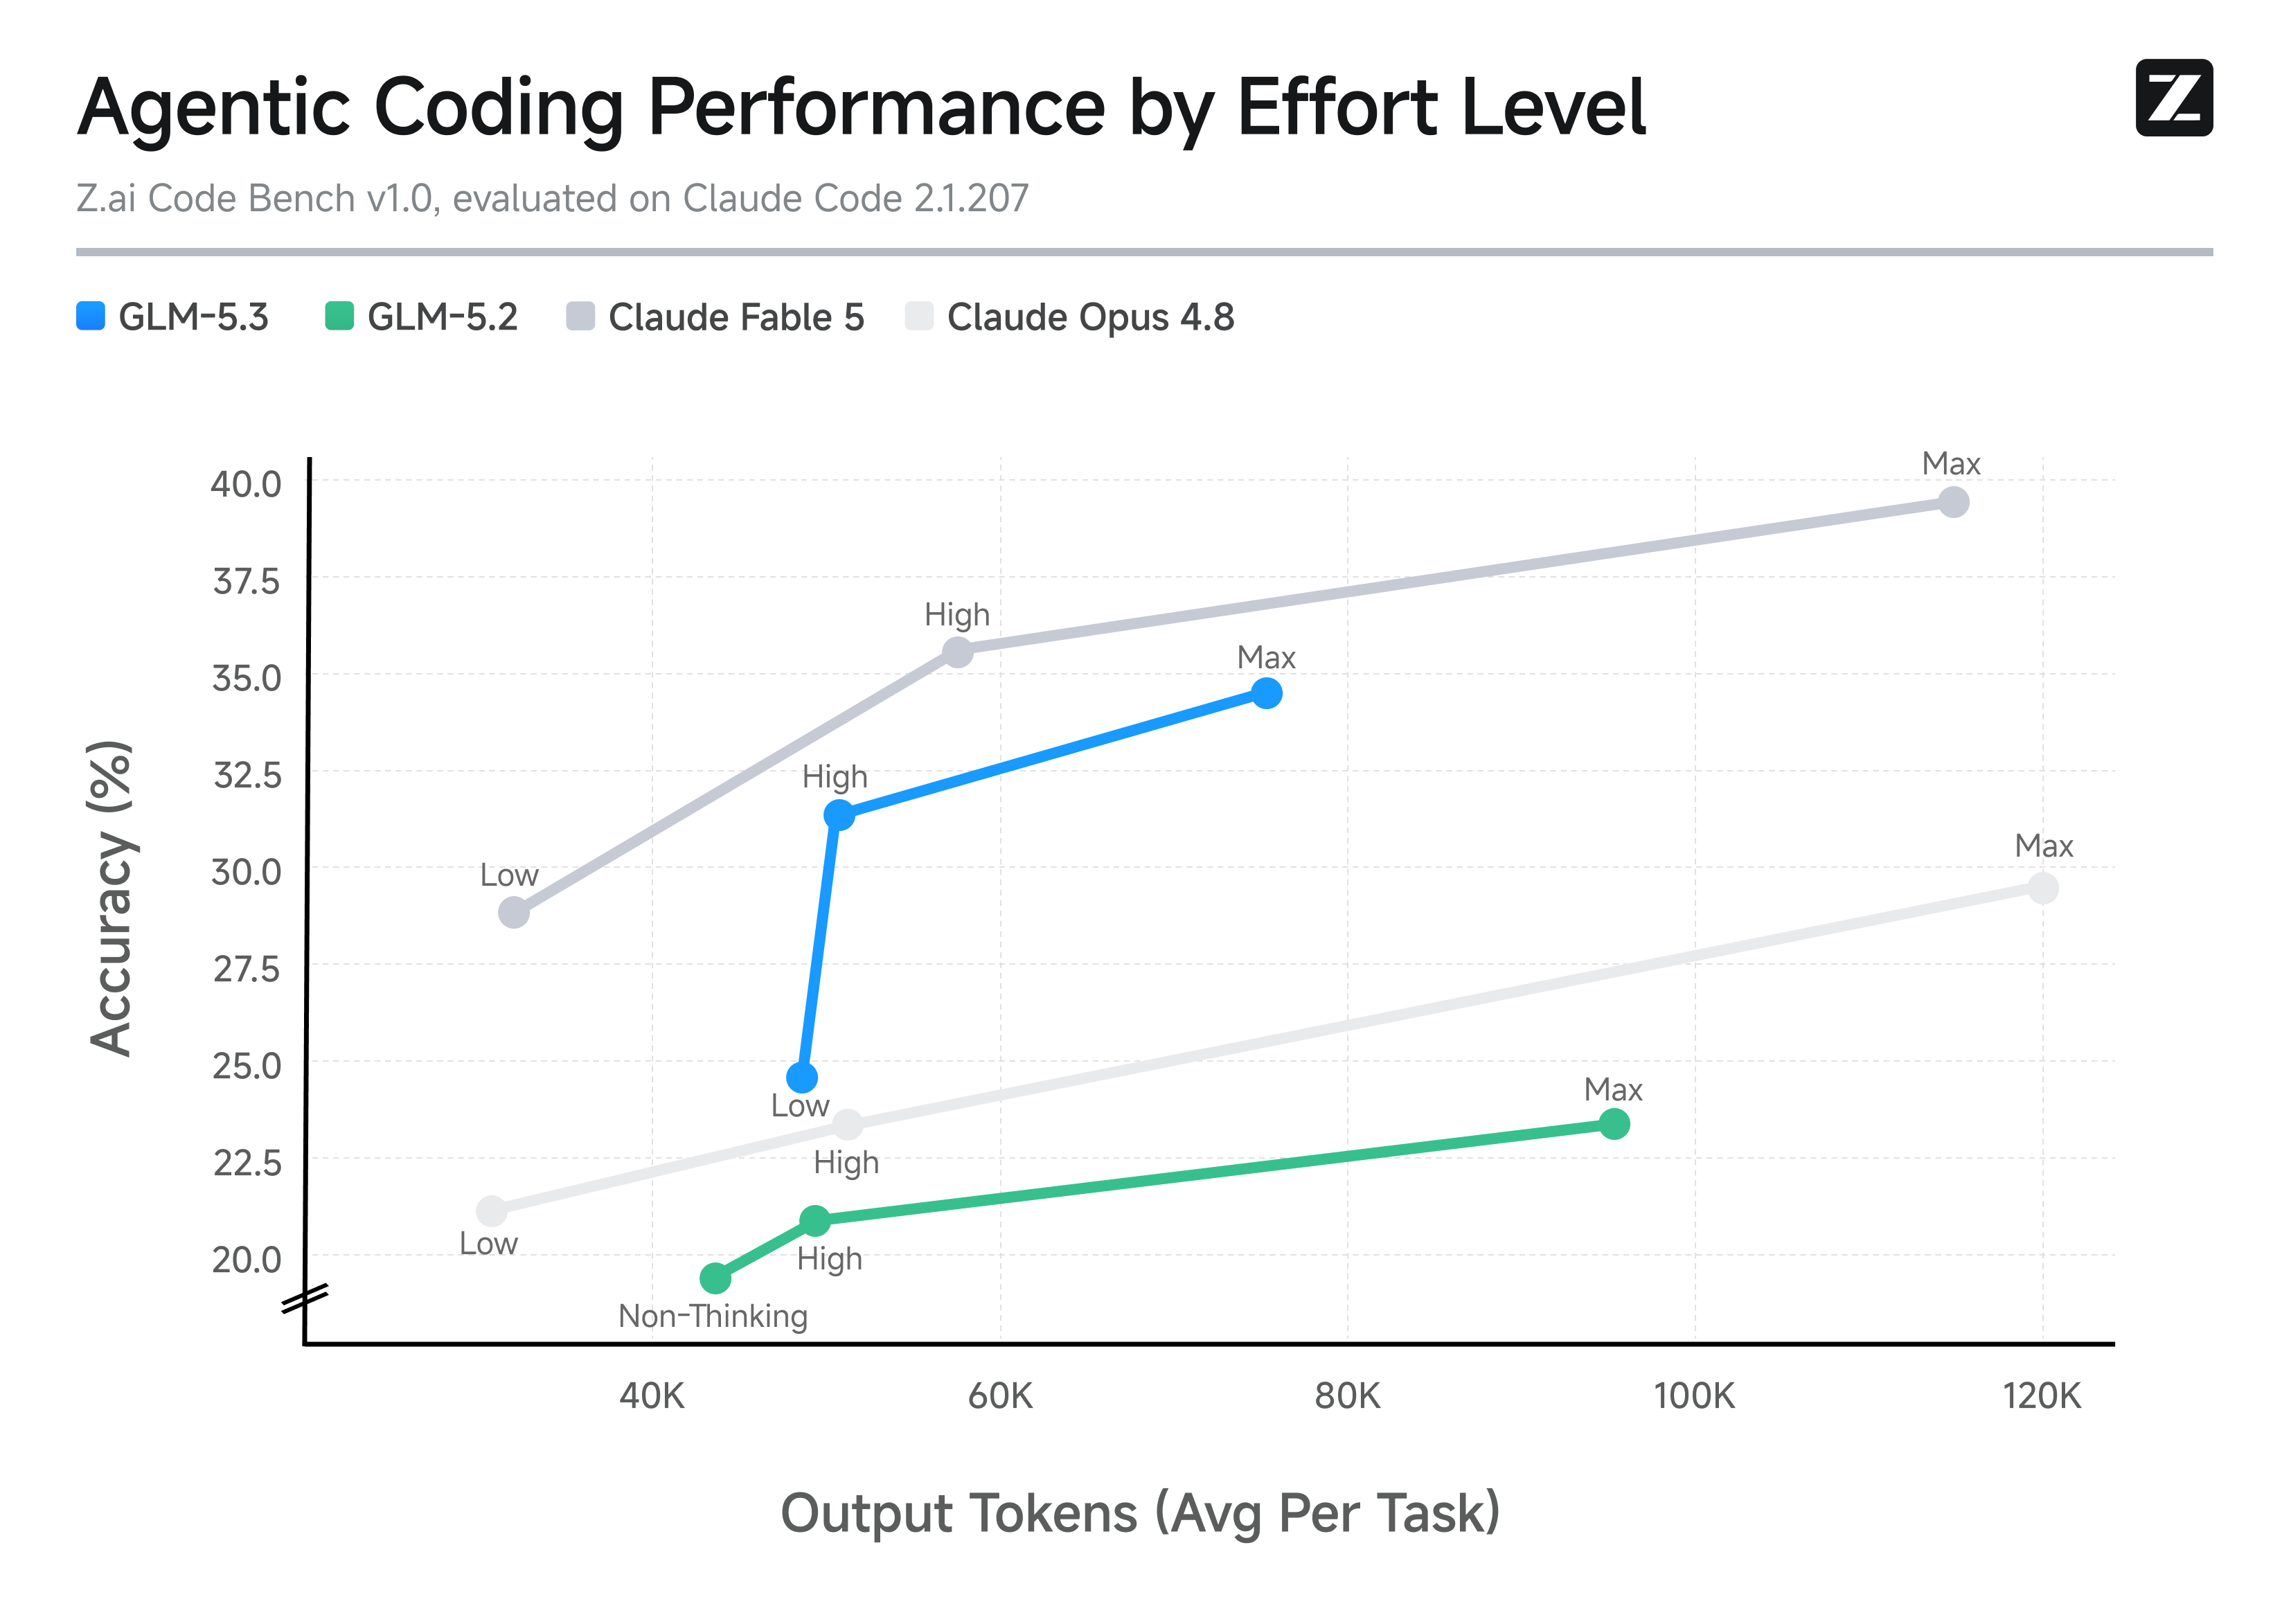
С закрытыми моделями сравнение ещё нагляднее. На уровне high GLM-5.3 даёт 31,4% при 50 тысячах токенов, а Claude Opus 4.8 — 29,5% при 120 тысячах. Fable 5 сильнее по качеству (39,5% на максимуме), но и тратит больше.
Что говорят независимые замеры
Все цифры выше опубликовала сама Z.ai, причём Z.ai Code Bench закрытый. После открытия весов модель прогнали сторонние лаборатории, и картина вышла менее радужной.
Artificial Analysis по своему индексу версии 5 ставит GLM-5.3 (max) 32 балла при медиане 23 у моделей сопоставимого размера. Это высокий результат. Но на их наборе задач модель оказалась многословной: 135 млн выходных токенов против медианы 104 млн. Ещё она медленная, 31,7 минуты на задачу при медиане 13,6.
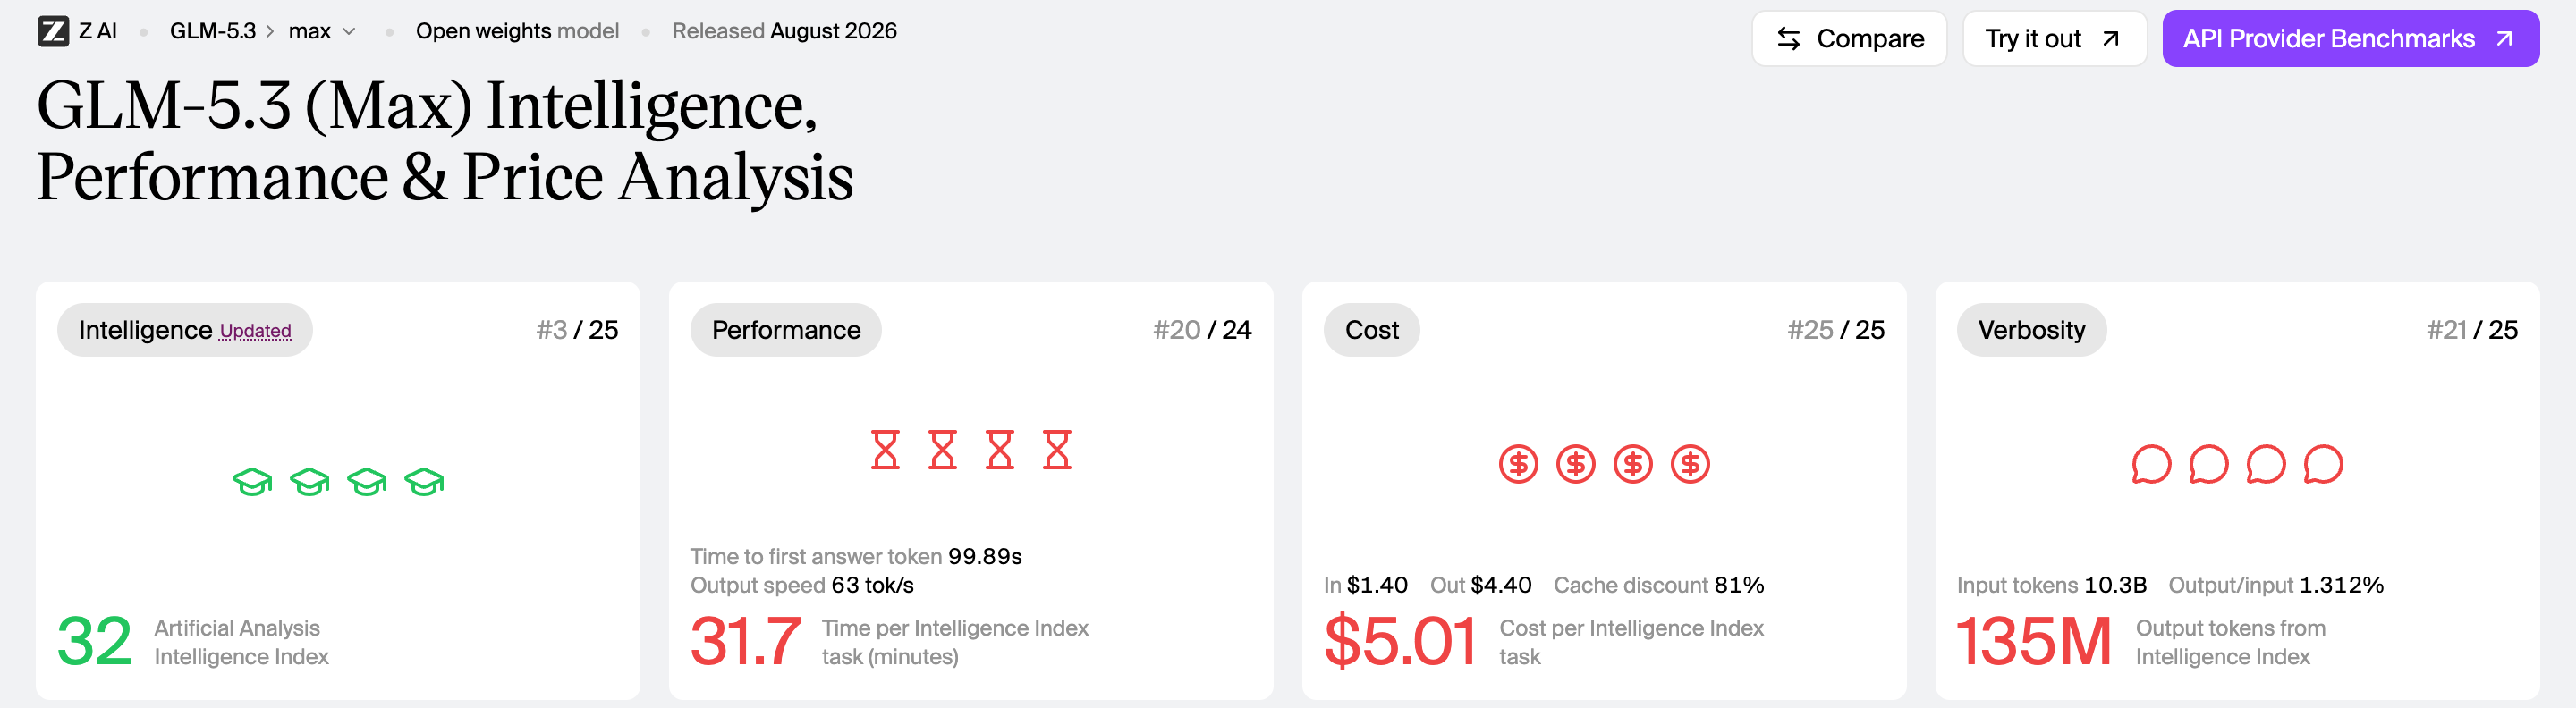
Тезис про экономию токенов этот замер не подтвердил. Думаю, дело в разнице задач: Z.ai мерила агентный кодинг на своём бенчмарке, а Artificial Analysis гоняет смесь из девяти тестов, от терминала до научных задач. Если считаешь деньги, прогони неделю своих задач и посмотри расход в дашборде Z.ai. Как его снизить, я разбирал в гайде про экономию токенов в Claude Code.
Как модель нашла 2436 уязвимостей
Ради этого раздела стоило читать анонс. Z.ai добавила в обучение данные по поиску уязвимостей, и способность росла быстрее, чем ждала команда. Модель перестала находить отдельные баги и начала строить цепочки эксплуатации целиком.
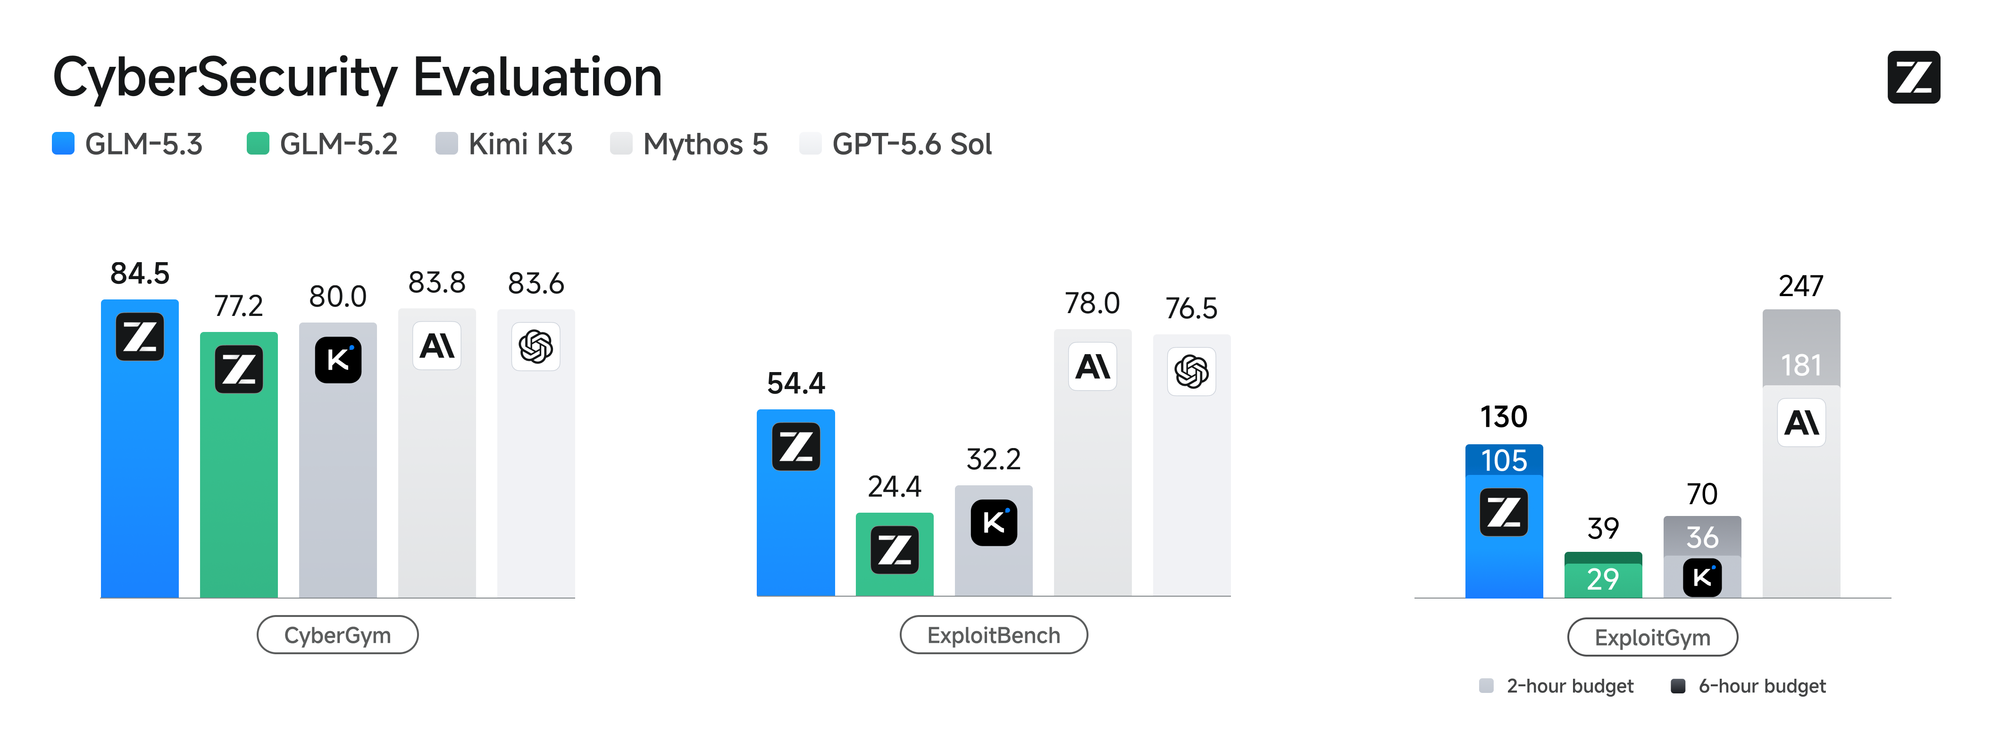
Цифры по трём бенчмаркам из анонса:
| Бенчмарк | GLM-5.3 | GLM-5.2 | Opus 4.8 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| CyberGym | 84,5 | 77,2 | 78,1 | 83,8 | 83,6 |
| ExploitBench | 54,4 | 24,4 | 40,0 | 78,0 | 76,5 |
| ExploitGym, 2 ч / 6 ч | 105 / 130 | 29 / 39 | 80 / 120 | 181 / 247 | 216 / 293 |
На CyberGym модель ищет и подтверждает уязвимость по исходникам. Тут GLM-5.3 лучшая: 84,5% против 83,8% у Fable 5. На ExploitBench нужно довести баг до рабочего эксплойта, и здесь результат вырос вдвое, но до закрытых моделей ещё далеко: 54,4% против 78%. Z.ai сама формулирует закономерность так: чем ближе задача к готовой атаке, тем больше прирост и тем шире оставшийся разрыв.
Что известно про найденные уязвимости
С GLM-5.2 компания работает с несколькими командами безопасности в Китае и гоняет модели по реальному коду. После экспертной проверки и чистки дублей получилось 2436 уязвимостей в 269 проектах, из них 1097 средней и высокой критичности.
| Критичность | Количество |
|---|---|
| Critical | 107 |
| High | 990 |
| Medium | 1286 |
| Low | 53 |
Находки разбросаны по ядрам ОС, браузерным движкам, инфраструктурному опенсорсу и сетевым протоколам. Старейшая уязвимость появилась в коде в 1981 году, а в среднем дыра жила 26,6 лет до обнаружения. По данным Axios, среди проектов есть ядро Linux, продукты VMware и проекты фонда Apache.
На момент анонса публично раскрыли 53 находки, остальные были под эмбарго. Для них Z.ai завела публичный реестр cvd.z.ai с проектом, критичностью и номером CVE. Сейчас реестр закрыт: на странице висит объявление, что новые уязвимости будут публиковать в китайских государственных базах CNVD, CNNVD и NVDB.
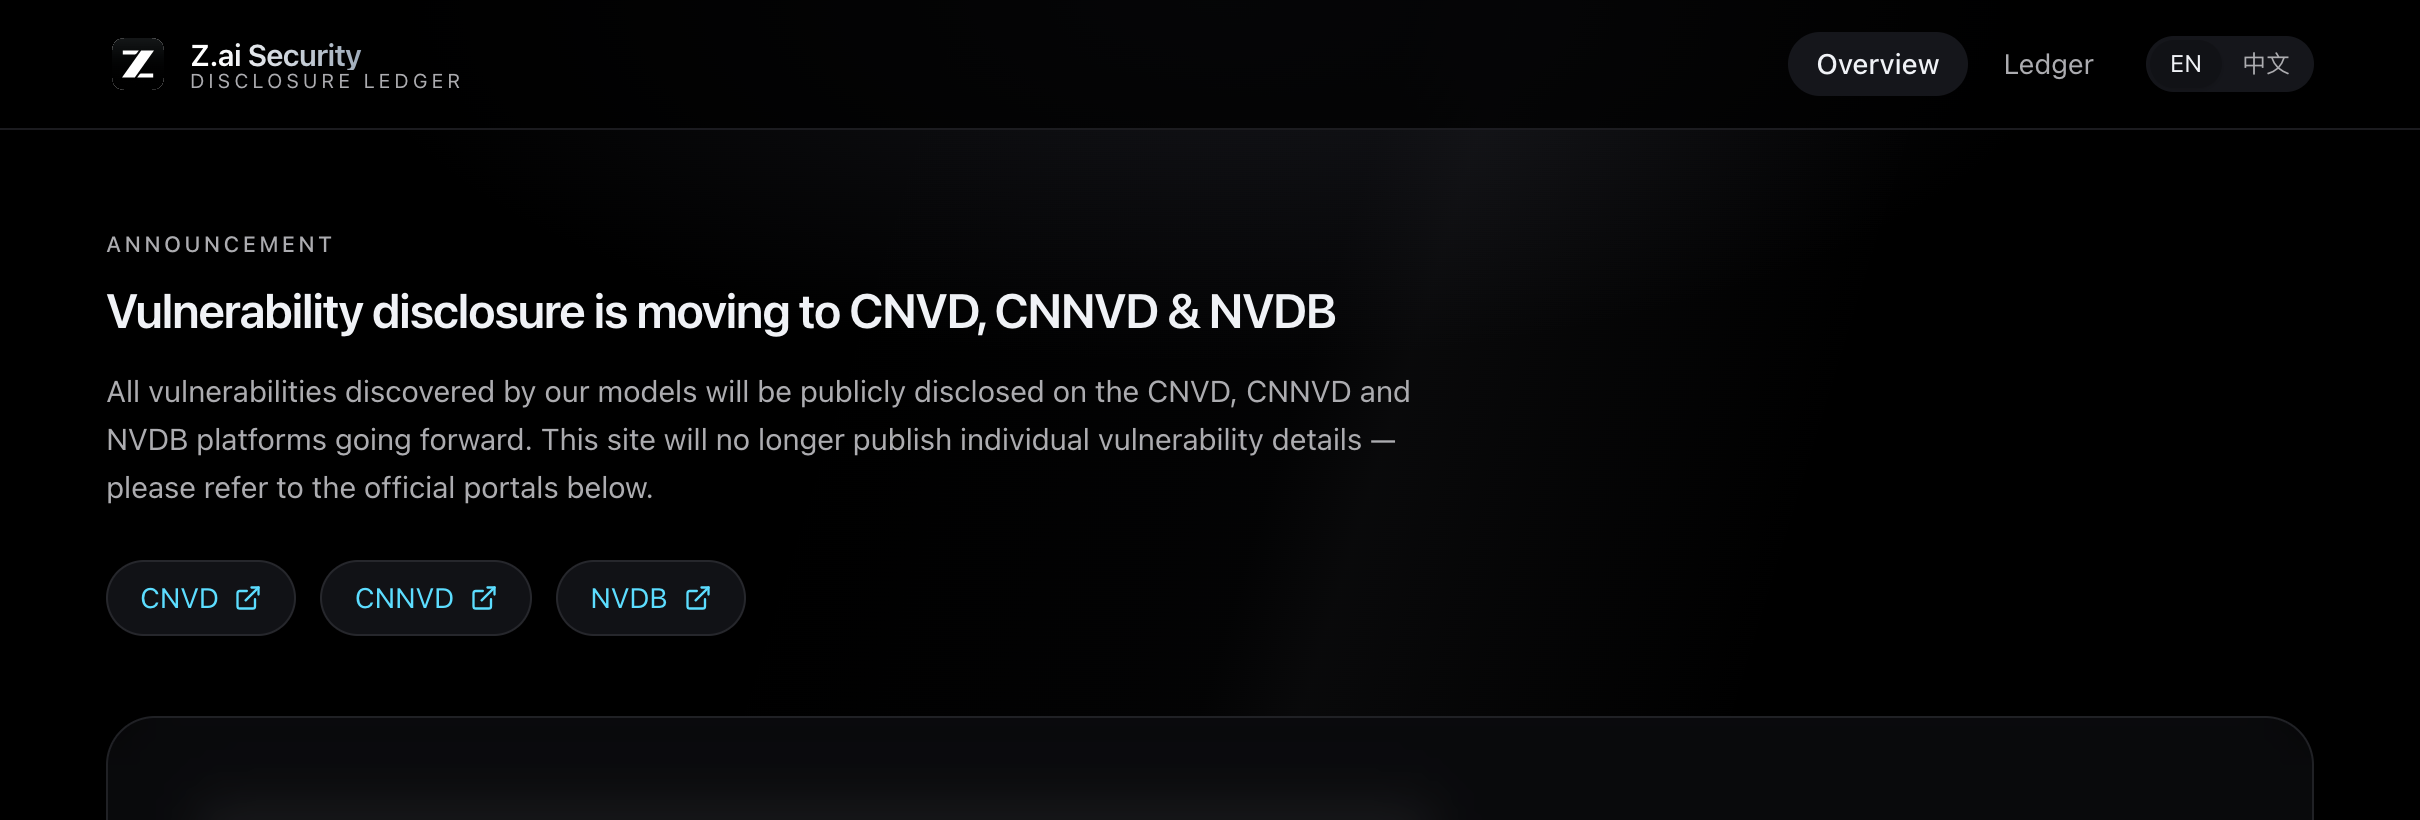
Для читателя это шаг назад. В августе я хвалил Z.ai за проверяемость: номера CVE и сроки жизни каждой дыры лежали на виду. Теперь сверить список придётся по китайским порталам, а они не так удобны для поиска.
Самая громкая находка случилась уже после анонса. Как писал VentureBeat, модель нашла «потенциально серьёзную уязвимость» в Cursor, и Z.ai передала её команде редактора приватно. На начало ноября я не нашёл ни публичного CVE, ни разбора от Cursor, так что детали пока неизвестны.
Ещё Z.ai запустила OpenVuln: мейнтейнер открытого проекта может попросить прогнать GLM по своему репозиторию. Если у тебя есть свой опенсорс, это самый дешёвый способ пощупать модель на реальной задаче.
Что выяснил NIST, когда проверил модель
Цифры по кибербезу в анонсе тоже вендорские. Независимую проверку провёл CAISI, центр оценки ИИ при американском институте стандартов NIST. Отчёт вышел 17 сентября 2026 года, то есть уже по открытым весам.
Вывод двойной. Из всех открытых моделей, что проверял CAISI, GLM-5.3 сильнее всех в кибербезе. Но до лучших американских моделей ей далеко: по сводной оценке она отстаёт примерно на четыре месяца.
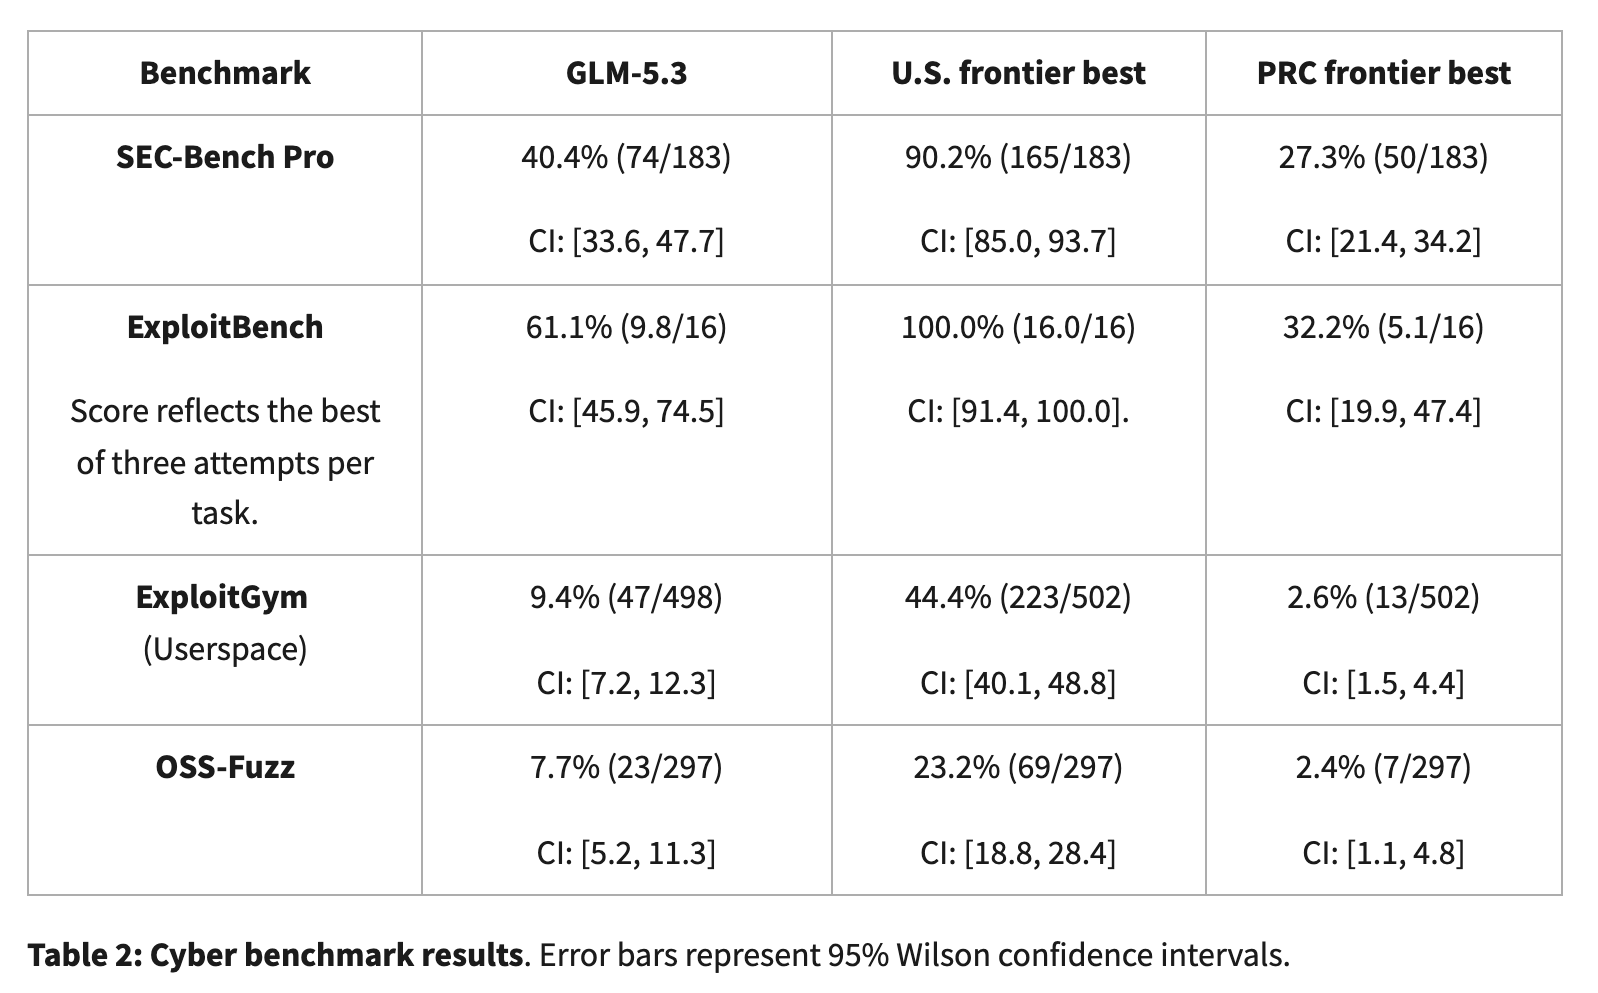
| Тест CAISI | GLM-5.3 | Лучшая модель США | Лучшая модель Китая до GLM-5.3 |
|---|---|---|---|
| SEC-Bench Pro: найти баг в V8 или SpiderMonkey | 40,4% | 90,2% | 27,3% |
| ExploitBench: довести баг V8 до эксплойта | 61,1% | 100% | 32,2% |
| ExploitGym: эксплойт по известному багу | 9,4% | 44,4% | 2,6% |
| OSS-Fuzz: найти и использовать неописанный дефект | 7,7% | 23,2% | 2,4% |
Есть оговорка. Американские модели CAISI тестировал с отключёнными защитными фильтрами по кибербезу, то есть мерил потолок их возможностей. Обычный пользователь с включёнными фильтрами получит меньше, и для безопасников это важная разница. Об этом ниже.
Почему безопасники выбирают открытую модель
Западные флагманы часто отказываются работать с задачами по безопасности. Фильтры срабатывают на слова «эксплойт» и «red team», и модель вежливо уходит от ответа. Для пентестера или разработчика, который чинит свой же баг, это стена на ровном месте.
Показательный случай был в июле 2026 года. Hugging Face расследовала утечку данных и взяла для анализа GLM-5.2, потому что американские модели помогать отказались. В обсуждении на Hacker News в августе та же тема всплыла первым комментарием. Разработчик купил Lite, прогнал полноценный red team сценарий с RCE и адаптацией эксплойта под ядро и сразу перешёл на тариф за $80.
Насколько это здоровая ситуация, вопрос отдельный. Американские лаборатории тормозят релизы из-за киберрисков, а китайские команды целенаправленно учат открытые модели ломать код. Z.ai сама признаёт, что после открытия весов уже не сможет контролировать, кто и как дообучит модель. Я честно не знаю, как к этому относиться: аудит своего кода стал доступнее всем, но и атакующая сторона получила тот же инструмент.
Как скачать веса и на чём их запускать
Веса лежат в репозитории zai-org/GLM-5.3, там же версия в BF16. По данным NIST, Z.ai открыла их через две недели после анонса, как и обещала. Лицензия называется glm-5.3, это не чистый MIT, как было у GLM-5.2.
Разница в одном пункте. В остальном это MIT: можно использовать, дообучать, перепродавать и встраивать в свои продукты. Но если компания продаёт доступ к модели как сервис и её выручка за 12 месяцев больше $10 млрд, перед коммерческим использованием она должна пройти проверку безопасности у Z.ai. Тебя и почти любой бизнес это не касается: текст лицензии нацелен на крупных облачных провайдеров.
Теперь трезво про «запущу локально». Я проверил размер репозитория командой hf download с флагом --dry-run: она ничего не качает, только считает.
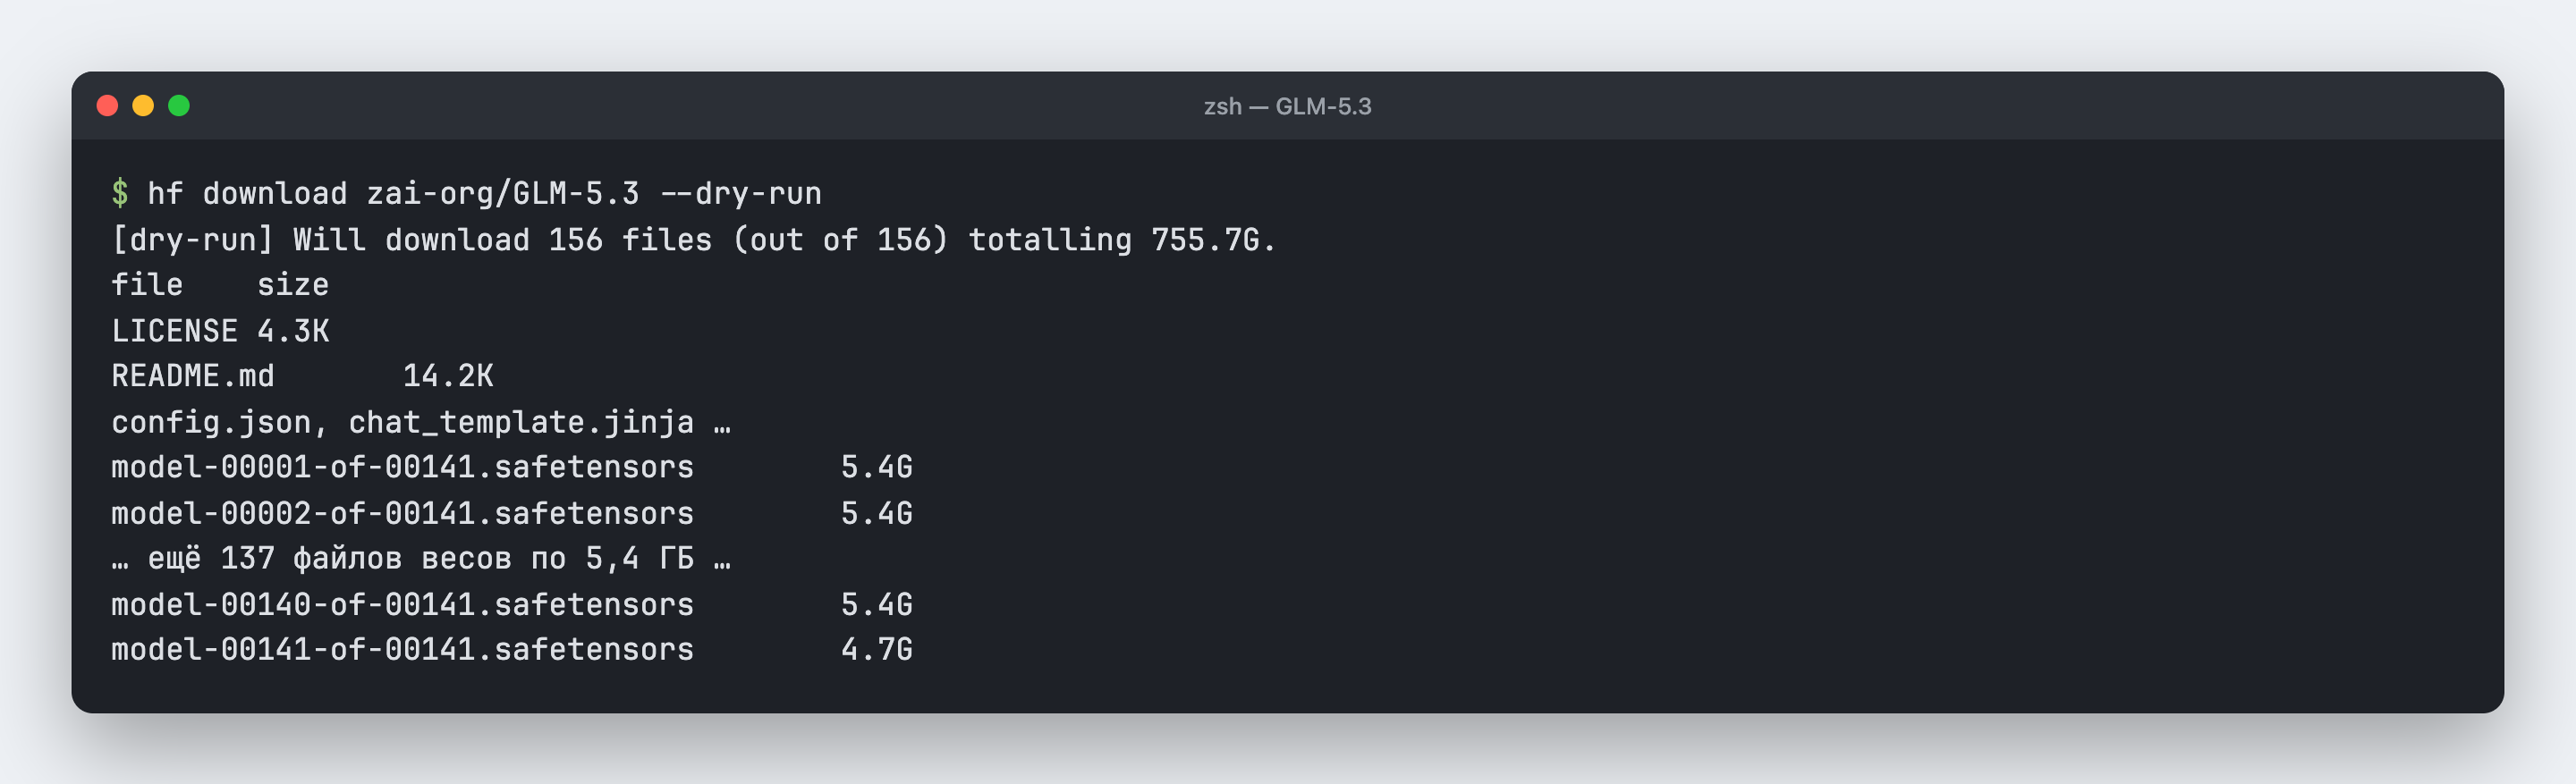
Три четверти терабайта не влезут ни в одну домашнюю видеокарту. Рецепт vLLM рассчитан на сервер с восемью ускорителями B300 или H200. Для разработчика это значит API или чужое облако. Модель уже раздают Together AI, Fireworks, Novita и ещё несколько провайдеров, они перечислены на её странице на Hugging Face.
Как подключить GLM-5.3 к Claude Code
Проще всего подключить модель через подписку GLM Coding Plan. Отдельный ключ API для этого не нужен, модель доступна всем подписчикам в Claude Code, Codex, OpenCode, Cline и собственной IDE Z.ai под названием ZCode. Подробный разбор с ошибками и проверкой есть в гайде по настройке Z.ai в Claude Code, здесь коротко.
- Оформи подписку на z.ai/subscribe и создай ключ в разделе Coding Plan.
- Установи Claude Code, если его ещё нет.
- Запусти официальный конфигуратор
npx @z_ai/coding-helper: он сам пропишет ключ и адрес Z.ai в настройки Claude Code. - Запусти
claudeв папке проекта и на вопрос про ключ API ответь «Yes».
Если хочешь настроить руками, документация Z.ai предлагает такой блок для ~/.claude/settings.json. Что ещё можно положить в этот файл, я разбирал в статье про settings.json в Claude Code.
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "твой_ключ_zai",
    "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "API_TIMEOUT_MS": "3000000"
  }
}
После правки открой новое окно терминала, иначе переменные не подхватятся. Запросы к GLM-5.2 и GLM-5.1 теперь сами уходят на GLM-5.3, а запросы к GLM-4.7 попадают на GLM-5.3-Flash. Откатиться на старую версию не получится.
Что сломается в API при переходе на GLM-5.3
Если ты вызываешь модель из своего кода, учти одну несовместимость. В GLM-5.3 нельзя отключить рассуждения: параметр thinking.type: "disabled" больше не поддерживается. Вместо него три уровня: low, high и max, по умолчанию max.
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "low"
}
Z.ai советует порядок действий: сначала поменять disabled на enabled с reasoning_effort: low, а уже потом менять идентификатор модели. Иначе запрос упадёт с ошибкой.
Сколько стоит подписка и доступ по API
Цены с августа не изменились. Сверил их со страницей подписки 6 ноября 2026 года: три тарифа, при оплате за квартал скидка 20%, за год 30%.
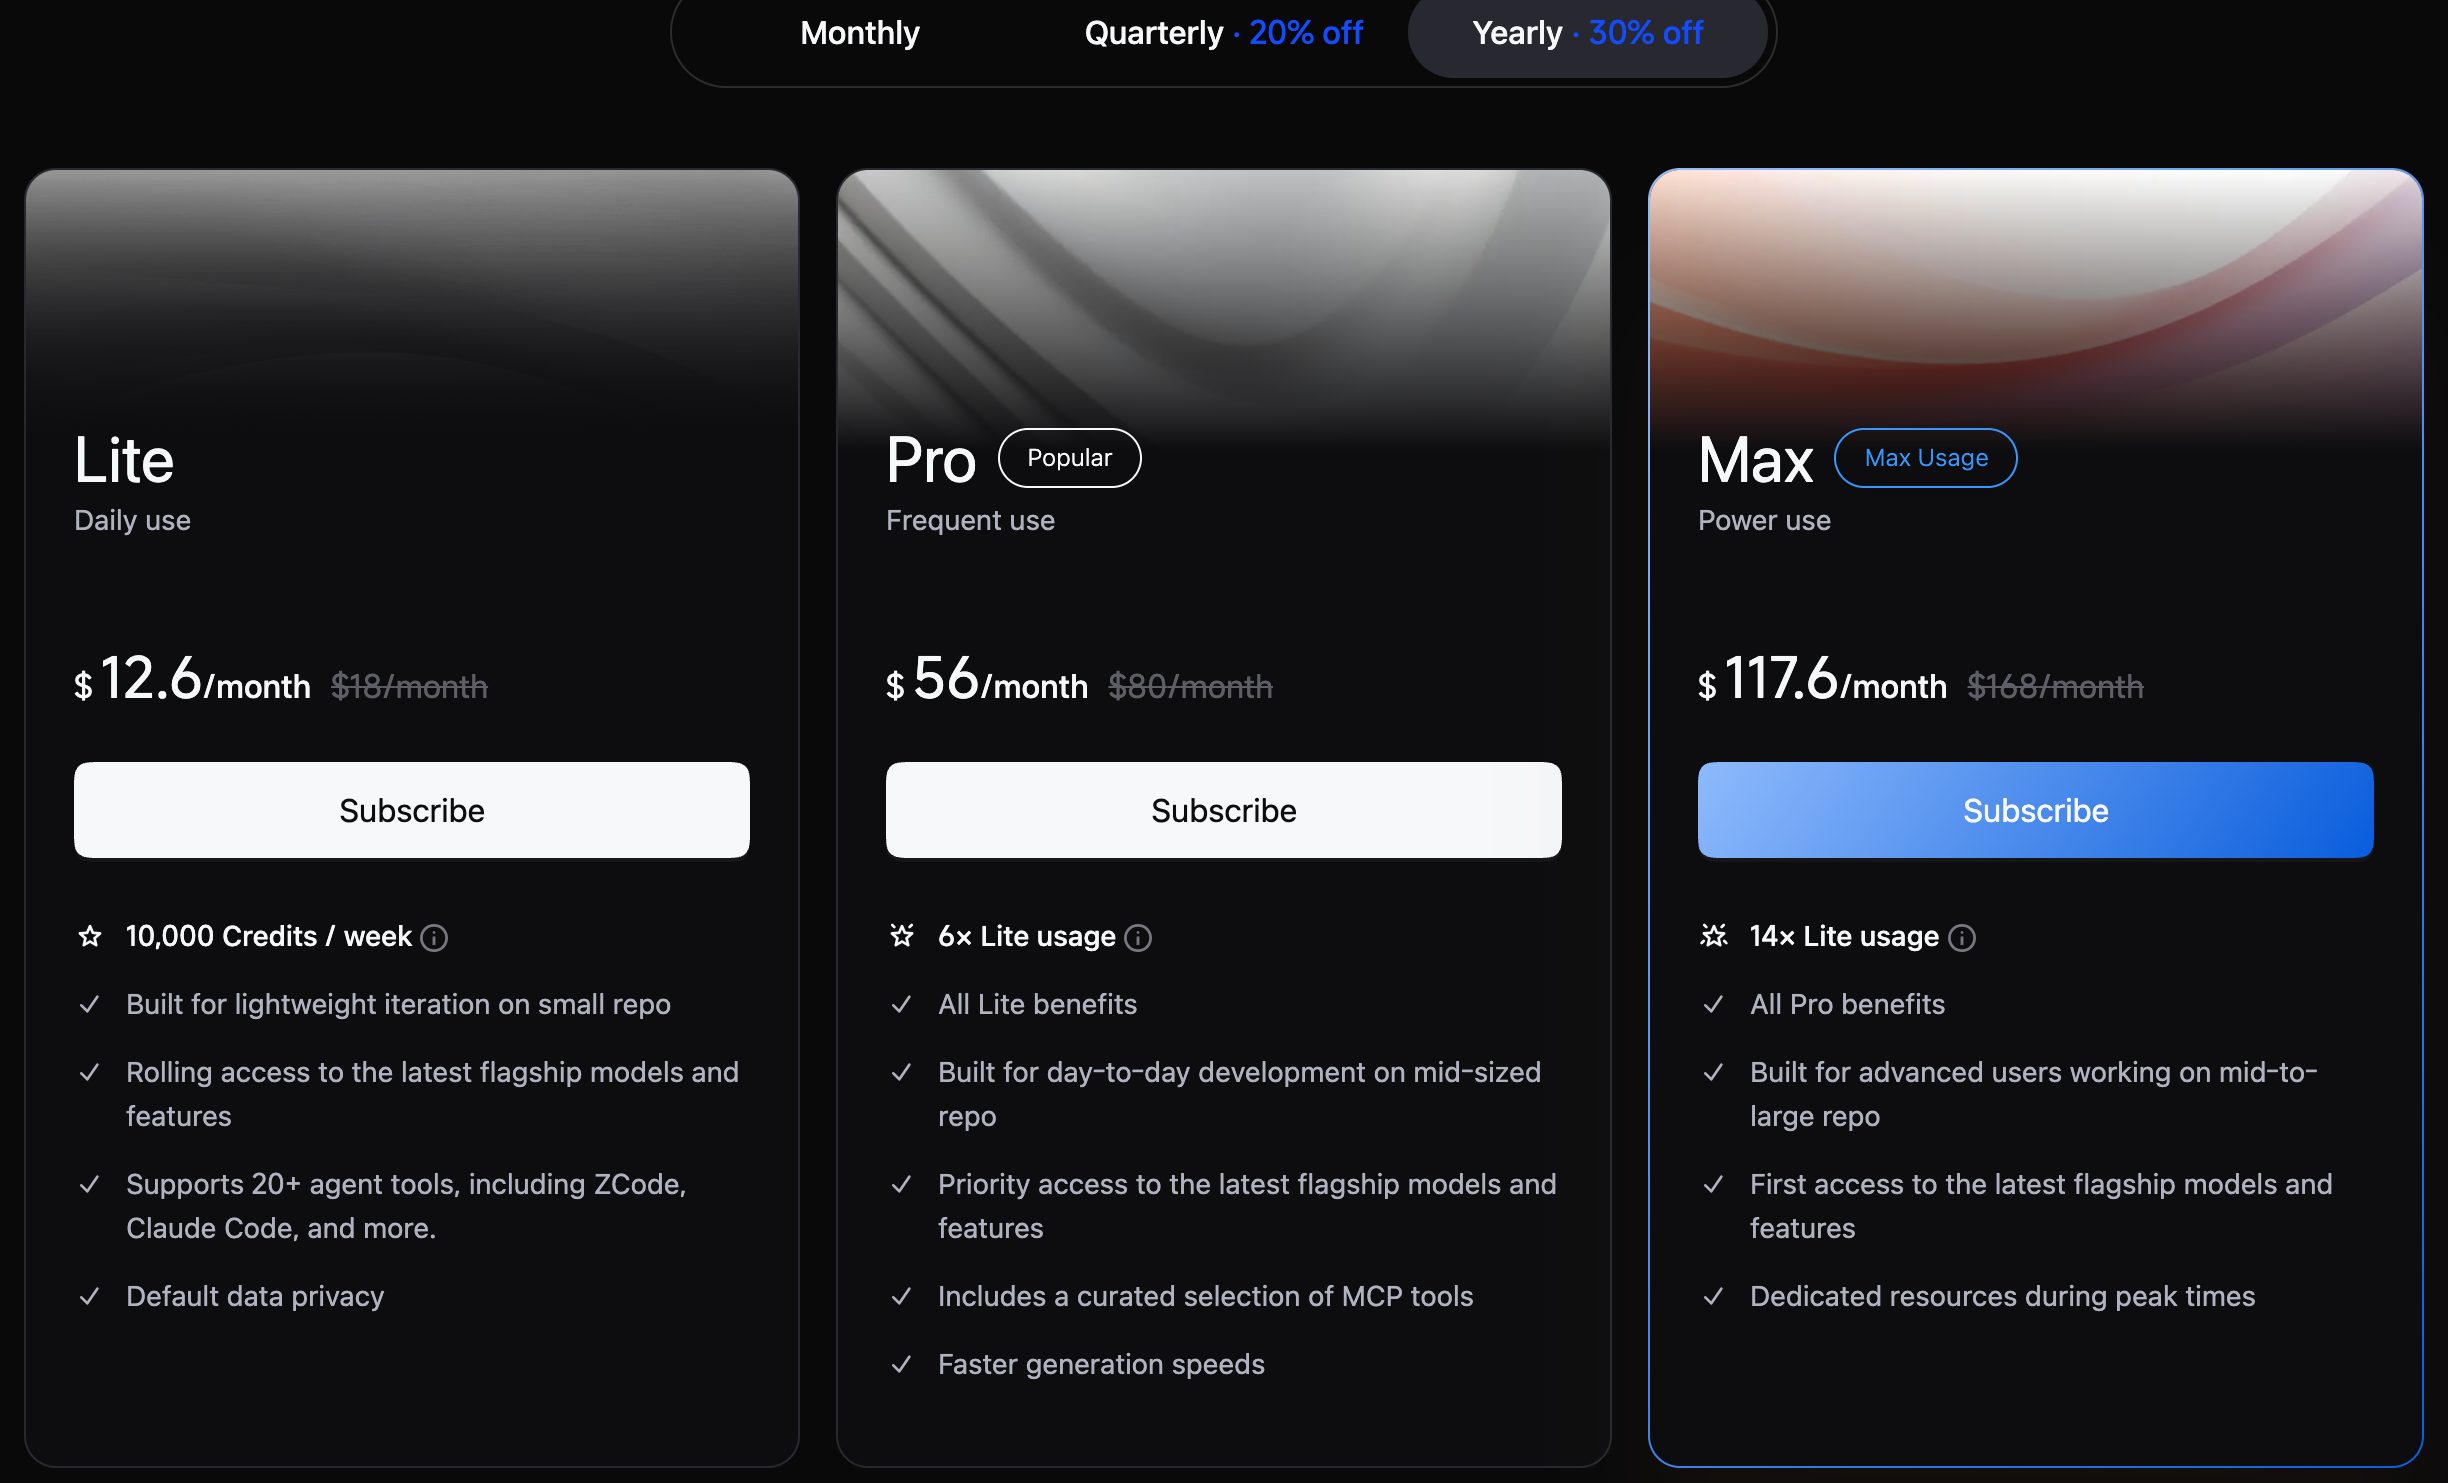
| Тариф | В месяц | При оплате за год | Кредиты за 5 часов | Кредиты в неделю | Токенов GLM-5.3 в неделю |
|---|---|---|---|---|---|
| Lite | $18 | $12,6 | 2 000 | 10 000 | 48–97 млн |
| Pro | $80 | $56 | 12 000 | 60 000 | 290–580 млн |
| Max | $168 | $117,6 | 28 000 | 140 000 | 676–1352 млн |
Расход считается в кредитах. Вход, кешированный вход и выход идут с разными коэффициентами. По документации Coding Plan у GLM-5.3 это 6,9 за вход, 1,7 за кеш и 24 за выход на 10 тысяч токенов. GLM-5.3-Flash примерно втрое дешевле.
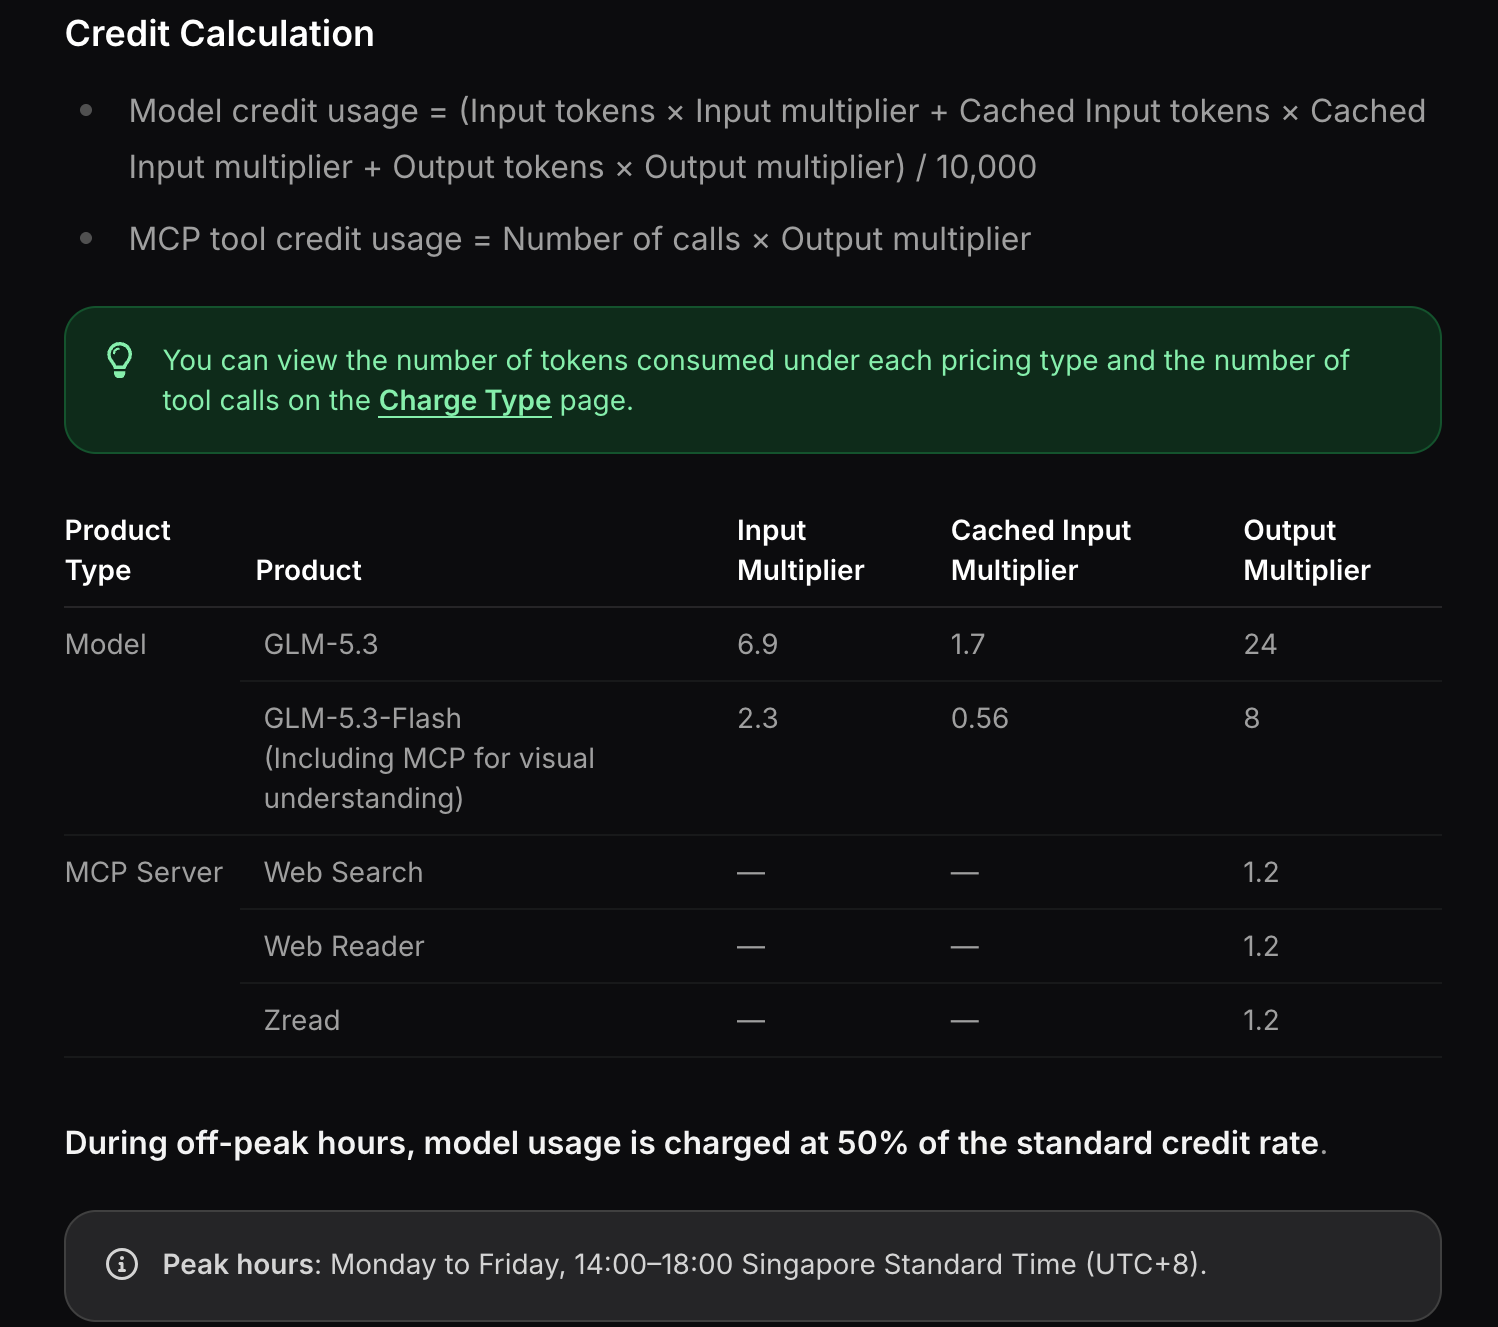
Вилка в последней колонке таблицы тарифов объясняется часами пик. С 14:00 до 18:00 по UTC+8 в будни кредиты списываются полностью, в остальное время за полцены. В Москве это 9:00–13:00, так что вторая половина рабочего дня и вечер идут по льготной ставке. Оценки токенов Z.ai даёт для доли кеша 95%, при 98% они чуть выше.
Без подписки GLM-5.3 доступна по API Z.ai: $1,40 за миллион входных токенов, $0,26 за кешированный вход и $4,40 за выход. Это дороже большинства открытых моделей. По подсчёту Artificial Analysis медиана у сопоставимых моделей $0,47 на входе.
Кому модель подойдёт, а кому нет
Больше всего в релизе мне нравится открытость там, где её не ждёшь. Z.ai выложила веса крупной модели с почти свободной лицензией, хотя могла их придержать. Она сама показала, где отстаёт от закрытых моделей. Ещё модель работает в привычном Claude Code без смены инструментов.
Претензий за три месяца стало больше. Независимые замеры не подтвердили экономию токенов. Реестр уязвимостей, за который я хвалил Z.ai в августе, закрыли. Разрыв с американскими моделями в кибербезе NIST оценил в четыре месяца, а после его отчёта Anthropic выпустила ещё и Opus 5.5.
Если ты платишь за подписку Anthropic ради агентного кодинга и упираешься в лимиты, GLM-5.3 по-прежнему стоит попробовать. Lite за $18 даёт тот же Claude Code и десятки миллионов токенов в неделю. Безопасникам модель интересна тем, что её можно поднять у себя и не отправлять исходники в чужое облако. Правда, для этого нужен сервер с восемью ускорителями.
Кому точно мимо: тем, кто работает с чувствительными данными и не готов гнать их через китайские серверы Z.ai. Качество модели здесь ни при чём, всё решает юрисдикция. Вариант с открытыми весами снимает эту проблему, но только если у тебя есть своё железо.
Другие обзоры открытых и закрытых моделей собраны в разделе Модели.
Читайте также
- Z.ai и Claude Code: подключаем GLM-5.3 за 5 минут: пошаговая настройка Coding Plan, маппинг моделей и разбор ошибки 1113
- Kimi K3: открытая модель на 2,8 трлн параметров: главный китайский конкурент GLM-5.3, он же в таблицах выше.
- DeepSeek V4 Pro: обзор открытой модели для кодинга: ещё одна открытая модель для кода, полезно сравнить по цене API.
- 5 провайдеров с Anthropic API для Claude Code: где ещё взять дешёвую модель для Claude Code, если Z.ai не подходит.