Как запустить OpenAI Privacy Filter локально
Ставим OpenAI Privacy Filter с нуля, чистим лог и .env от личных данных и проверяем модель на русских текстах. Где она ошибается и как поднять полноту без переобучения.
· обновлено · 12 мин
Представь: тебе нужно отдать нейросети лог с почтами и телефонами клиентов, а выносить их за пределы своей машины нельзя. Запустить OpenAI Privacy Filter локально можно минут за десять: git clone, pip install -e . и opf --device cpu "текст". Модель заменит имена, почты, телефоны, номера карт и ключи плейсхолдерами вроде <PRIVATE_EMAIL>, и ни один байт не уйдёт в интернет.
Я прошёл гайд заново 6 ноября 2026 года на Mac с M4 Pro: поставил всё с нуля, прогнал лог, тикет, .env и шесть русских текстов, замерил скорость. Сама модель с июля не менялась: последний коммит в репозитории openai/privacy-filter и последняя версия весов на Hugging Face датированы 22 апреля 2026 года. Зато у неё уже 54 дообученные версии от сообщества, а для пайплайна на transformers нашёлся параметр, с которым сущности больше не режутся пополам.
В статье разберём:
- что нужно для запуска;
- установку и первый запуск на Mac и Linux;
- как читать JSON-вывод;
- чистку логов и файлов;
- вызов из Python;
- как модель справляется с русским;
- калибровку полноты и дообучение;
- частые ошибки.
Что нужно, чтобы запустить OpenAI Privacy Filter локально
OpenAI Privacy Filter — открытая модель для поиска персональных данных (PII, personally identifiable information) в тексте. Она размечает восемь категорий: имена, адреса, почты, телефоны, ссылки, даты, номера счетов и секреты. Лицензия Apache 2.0, так что модель можно встраивать и в коммерческие продукты. Что это за модель и как она устроена, я разбирал в обзоре OpenAI Privacy Filter, здесь только практика.
Для запуска понадобятся:
- Python 3.10 или новее (так прописано в
pyproject.tomlпакета); gitиpipилиuv;- около 3,5 ГБ на диске: 2,8 ГБ весов и ещё ~730 МБ зависимостей на Mac (основной вес у PyTorch, на Linux со сборкой под CUDA выйдет больше);
- видеокарта не нужна, всё считается на процессоре.
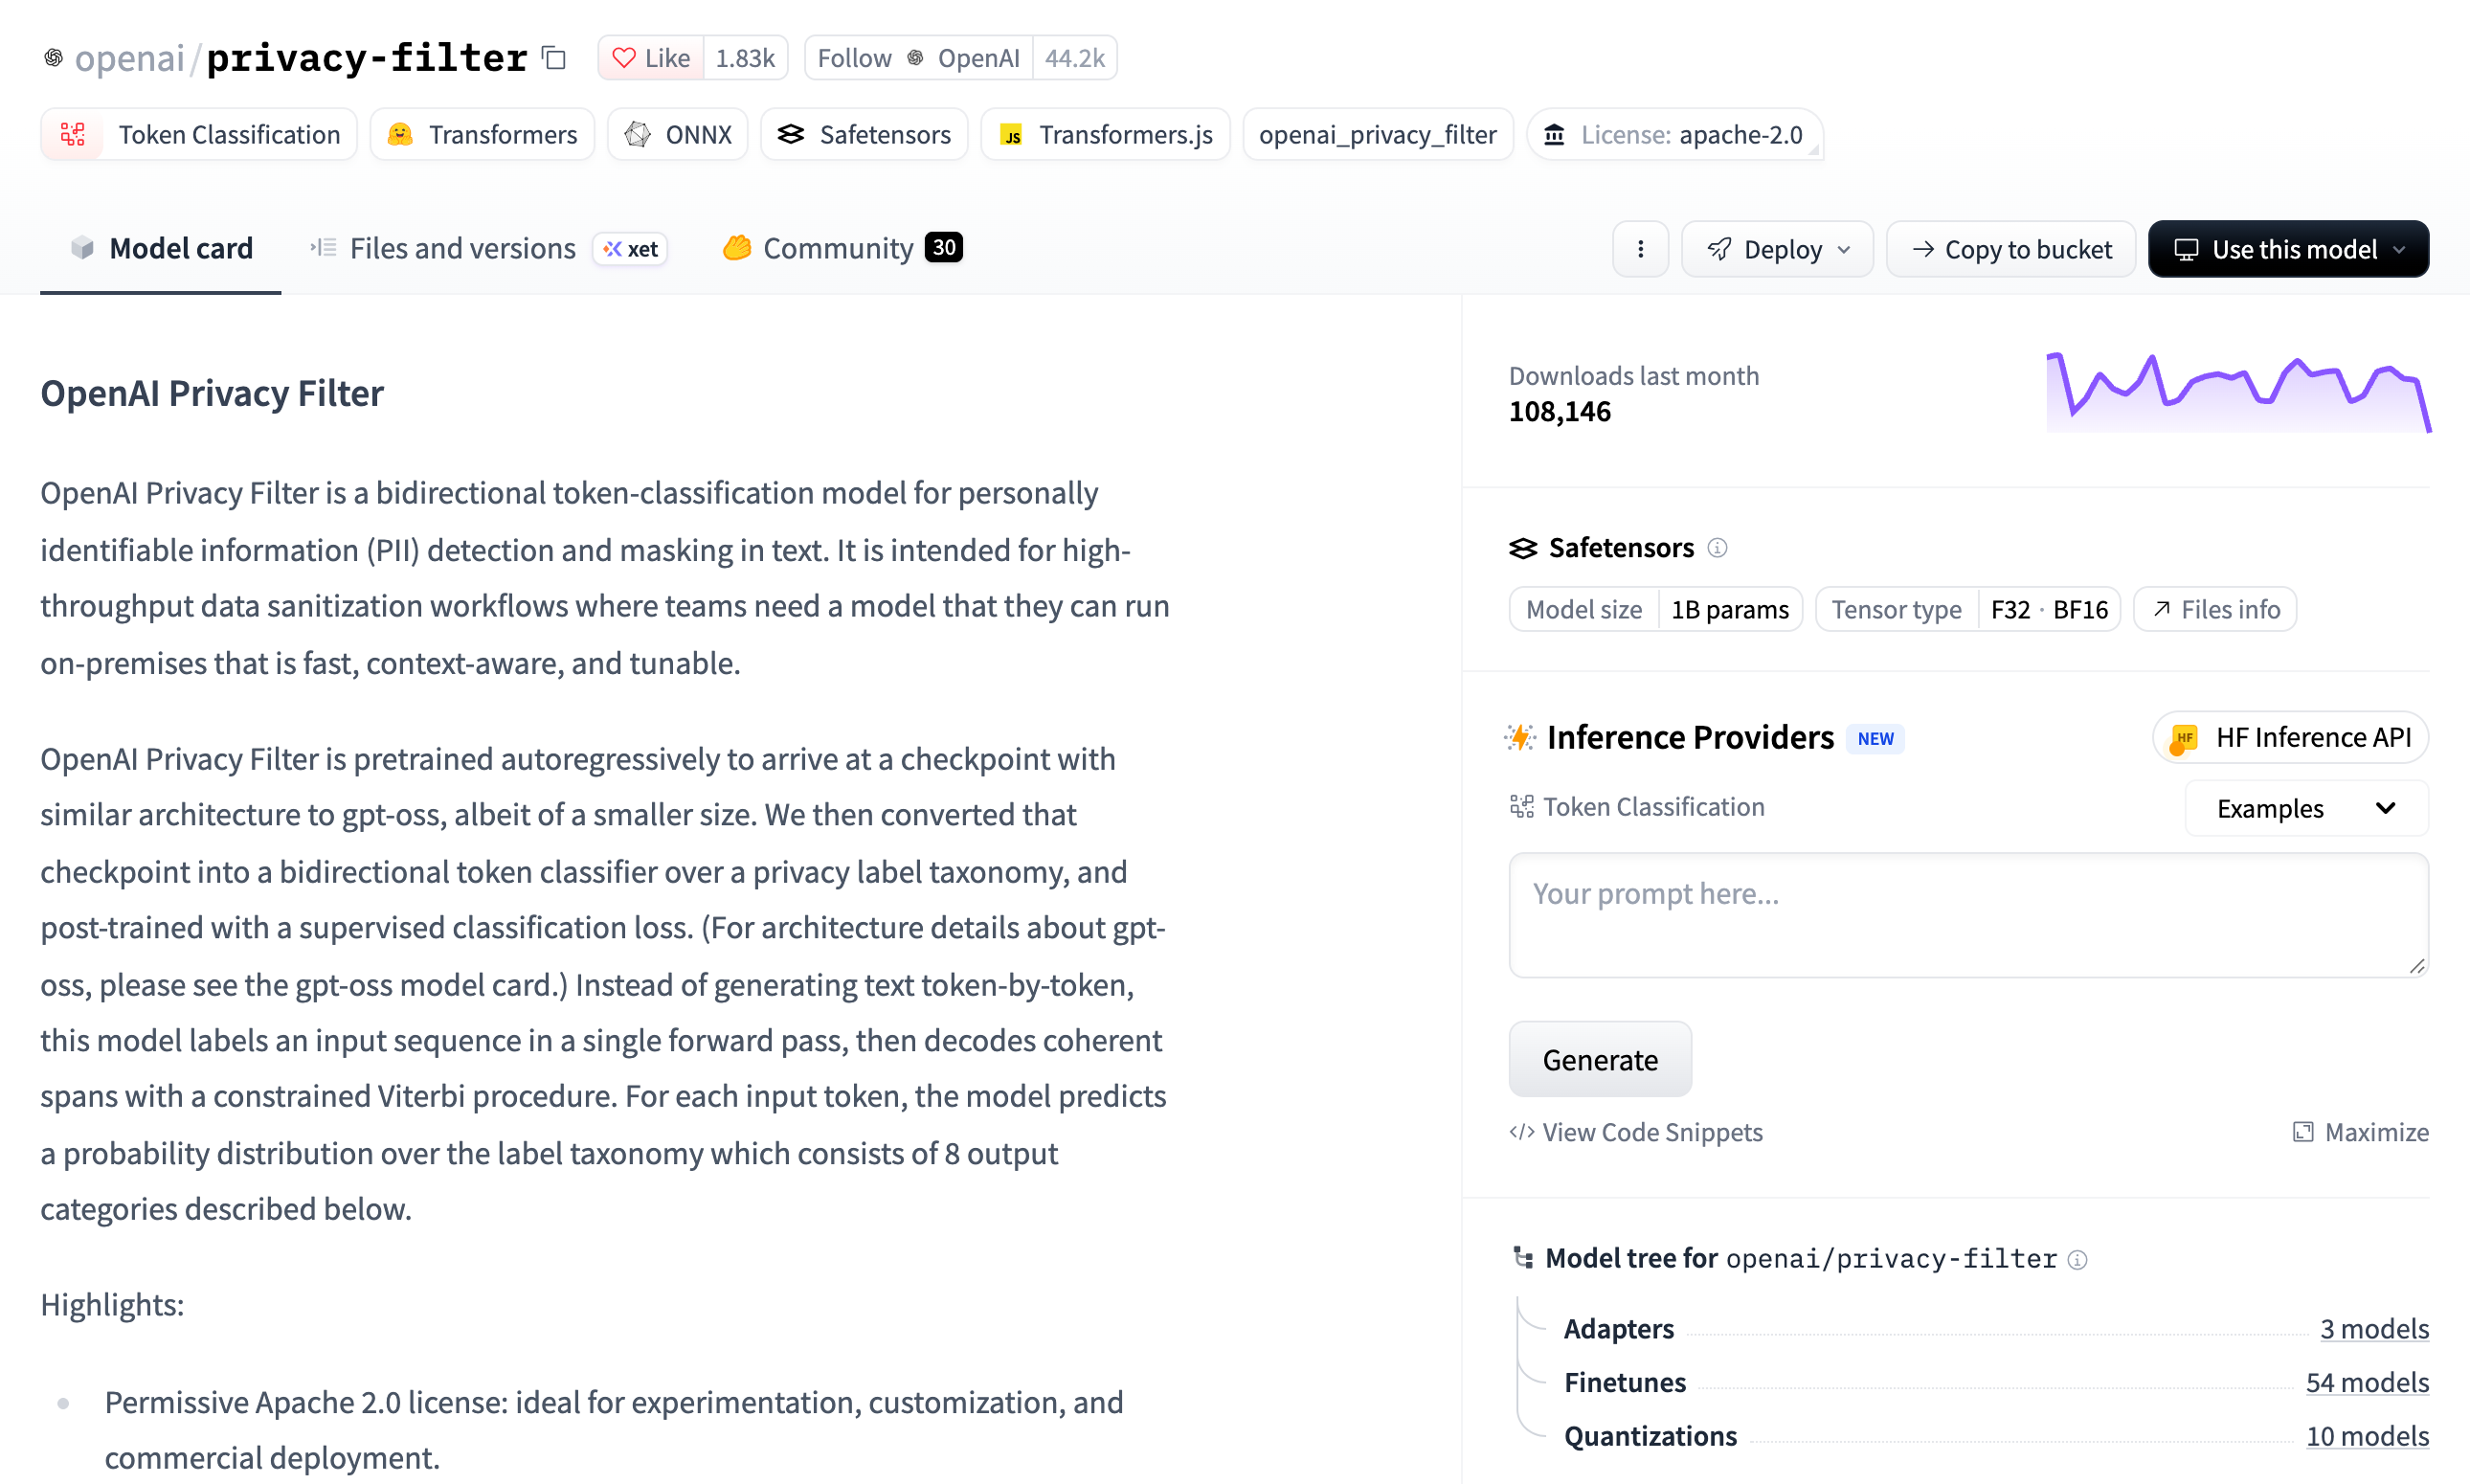
Модель маленькая по меркам LLM (у открытой Kimi K3, для сравнения, 2,8 трлн параметров): 1,5 млрд параметров, из которых на каждый токен работают только 50 млн (это разреженная MoE-архитектура). На странице модели на Hugging Face 6 ноября было 108 тысяч скачиваний за месяц и 54 дообученные версии от сообщества.
Шаг 1. Поставить opf
Утилита opf живёт в репозитории на GitHub. На PyPI её нет: пакет с именем opf там не зарегистрирован, поэтому ставим из исходников. Клонируем, заводим виртуальное окружение и ставим пакет в режиме разработки:
git clone https://github.com/openai/privacy-filter.git
cd privacy-filter
python3 -m venv .venv && source .venv/bin/activate
pip install -e .
pip подтянет torch, huggingface_hub, numpy, safetensors и tiktoken. С uv то же самое: uv venv --python 3.12 .venv и uv pip install -e .. Если клонировать репозиторий не хочется, сработает и установка напрямую: pip install 'opf @ git+https://github.com/openai/privacy-filter.git'.
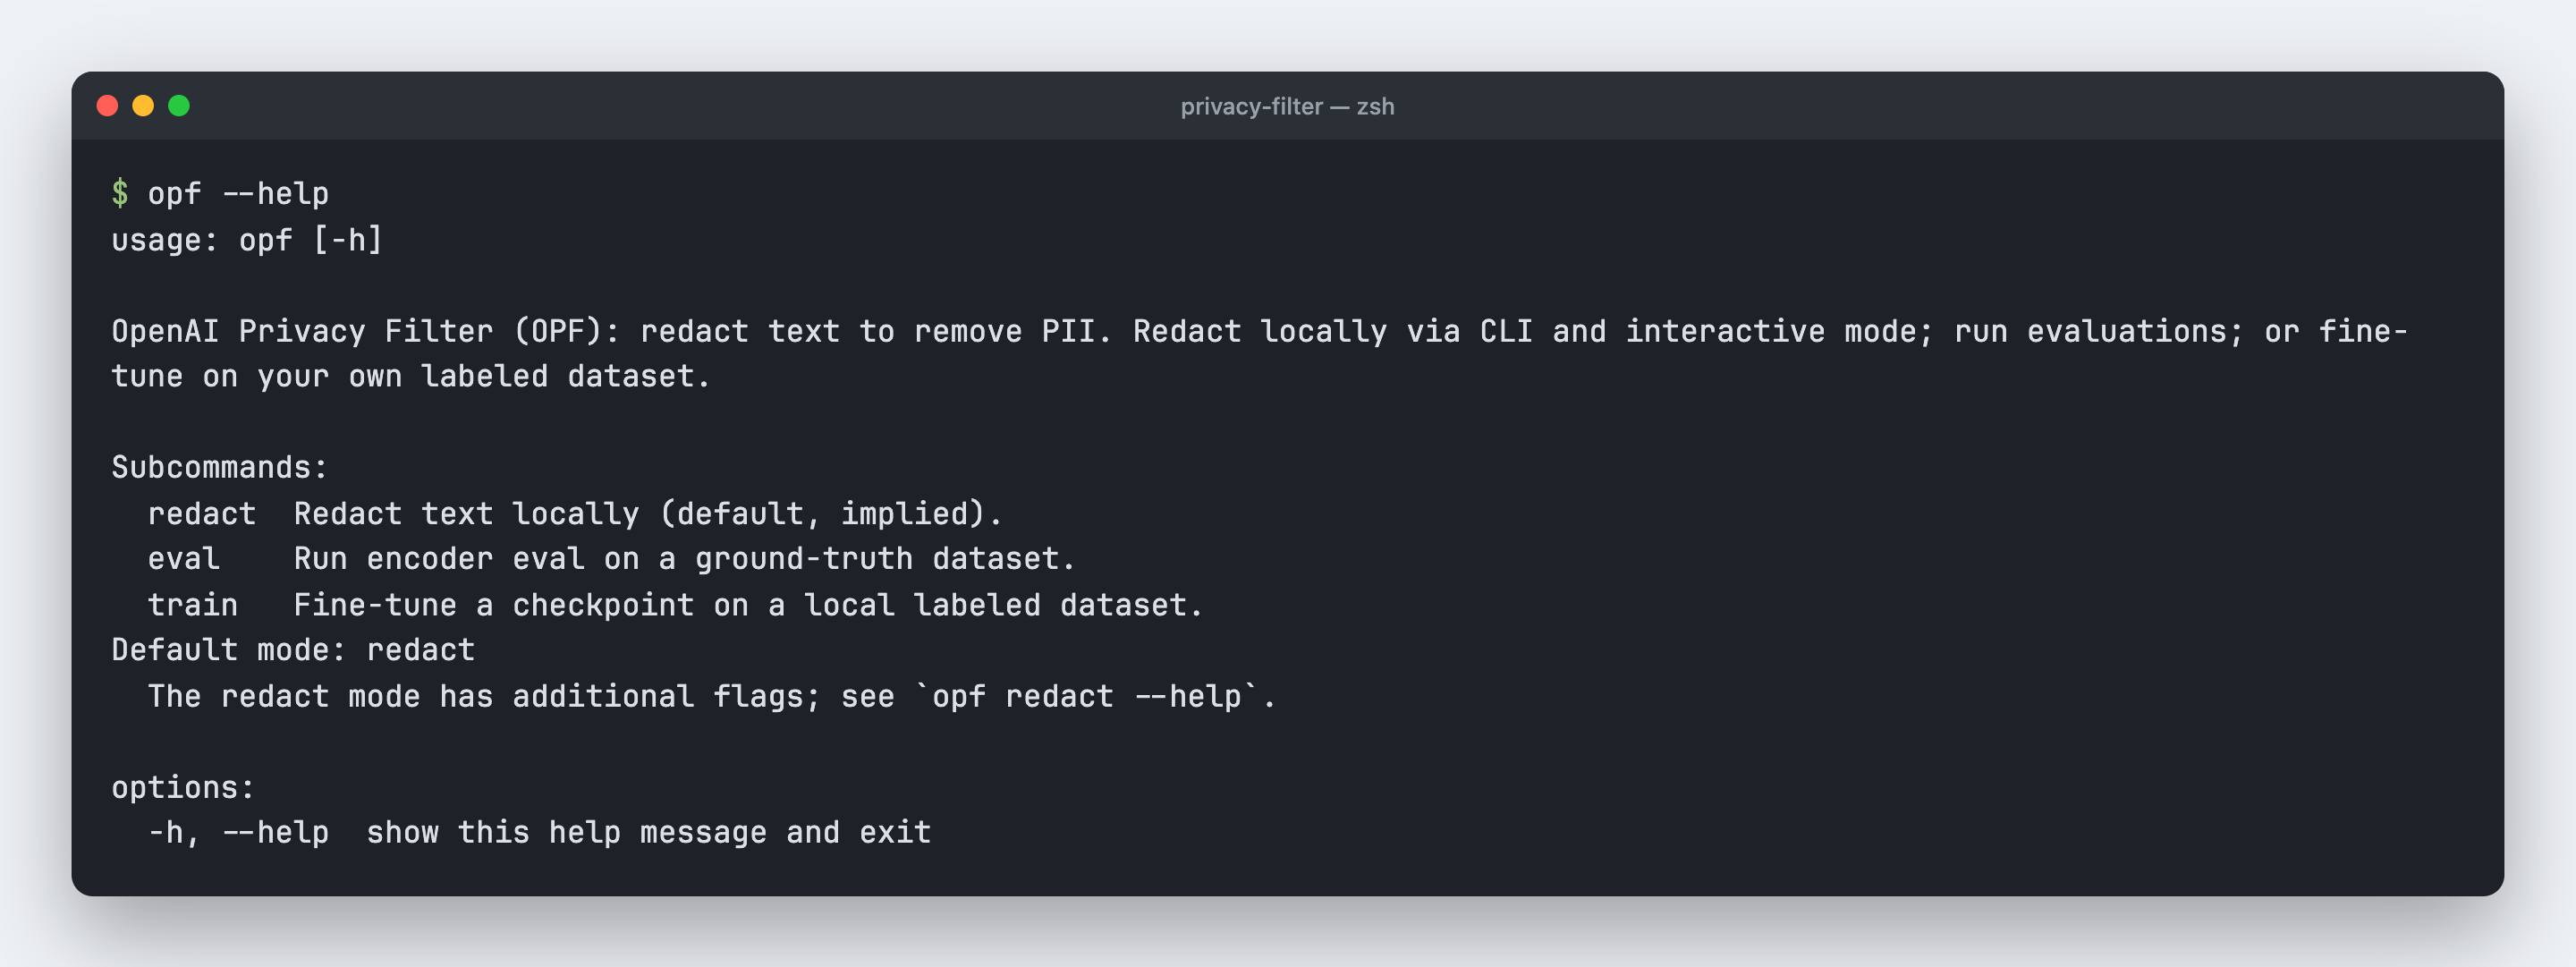
После установки в окружении появляется команда opf (её же можно звать как python -m opf). У неё три режима: redact для маскирования, eval для оценки на размеченных данных и train для дообучения.
Шаг 2. Первый запуск: почему на Mac нужен --device cpu
По умолчанию opf запускается на видеокарте NVIDIA (--device cuda) и не откатывается на процессор сам. Поэтому на Mac и на любой машине без CUDA первая команда падает:
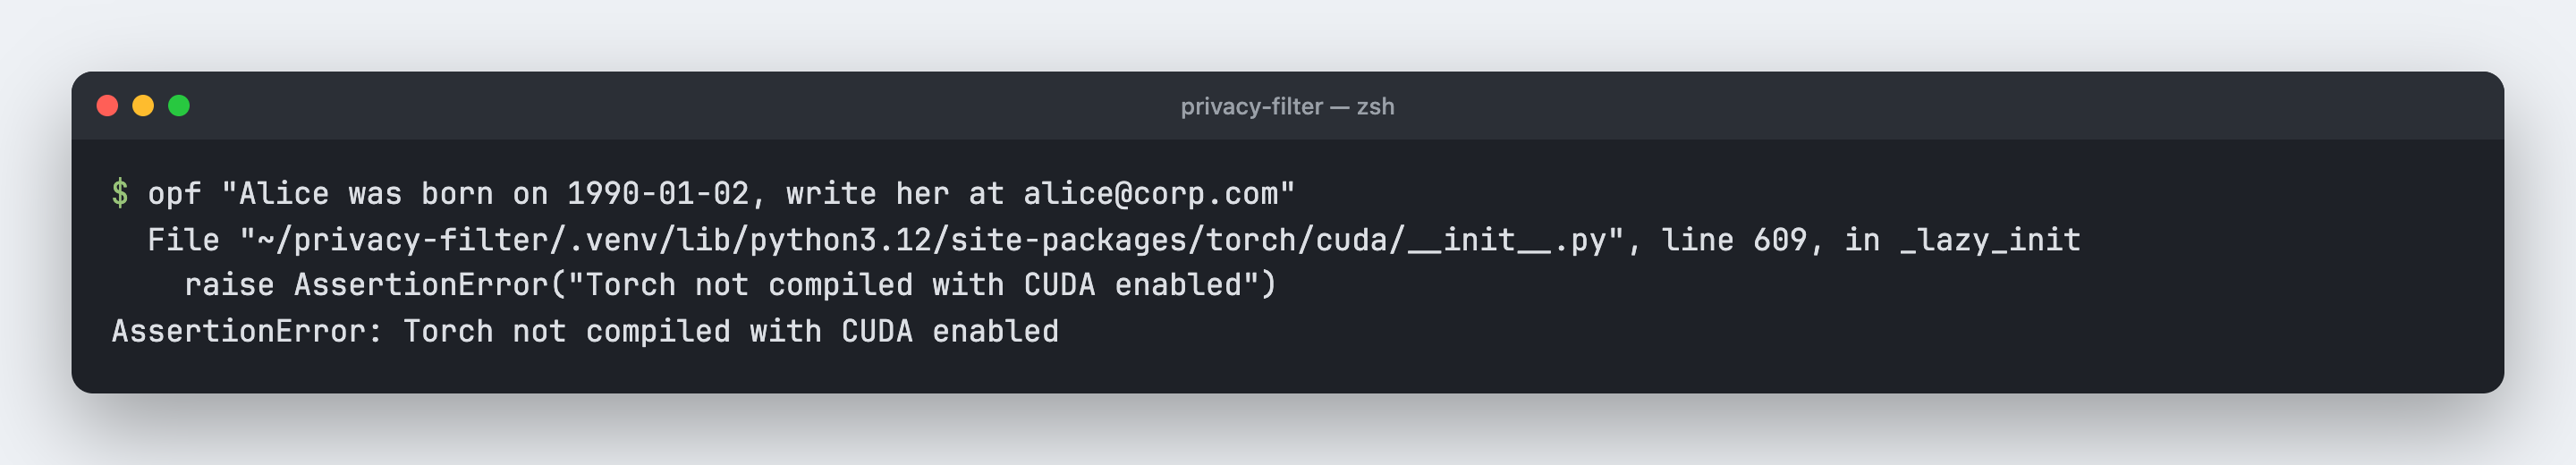
Причём падает уже после того, как скачал веса. Лечится флагом --device cpu:
opf --device cpu "Alice was born on 1990-01-02, write her at alice@corp.com"
При первом запуске opf скачивает чекпоинт (2,8 ГБ) в ~/.opf/privacy_filter. У меня загрузка заняла 53 секунды, дальше модель берётся с диска. Путь можно поменять переменной OPF_CHECKPOINT или флагом --checkpoint.
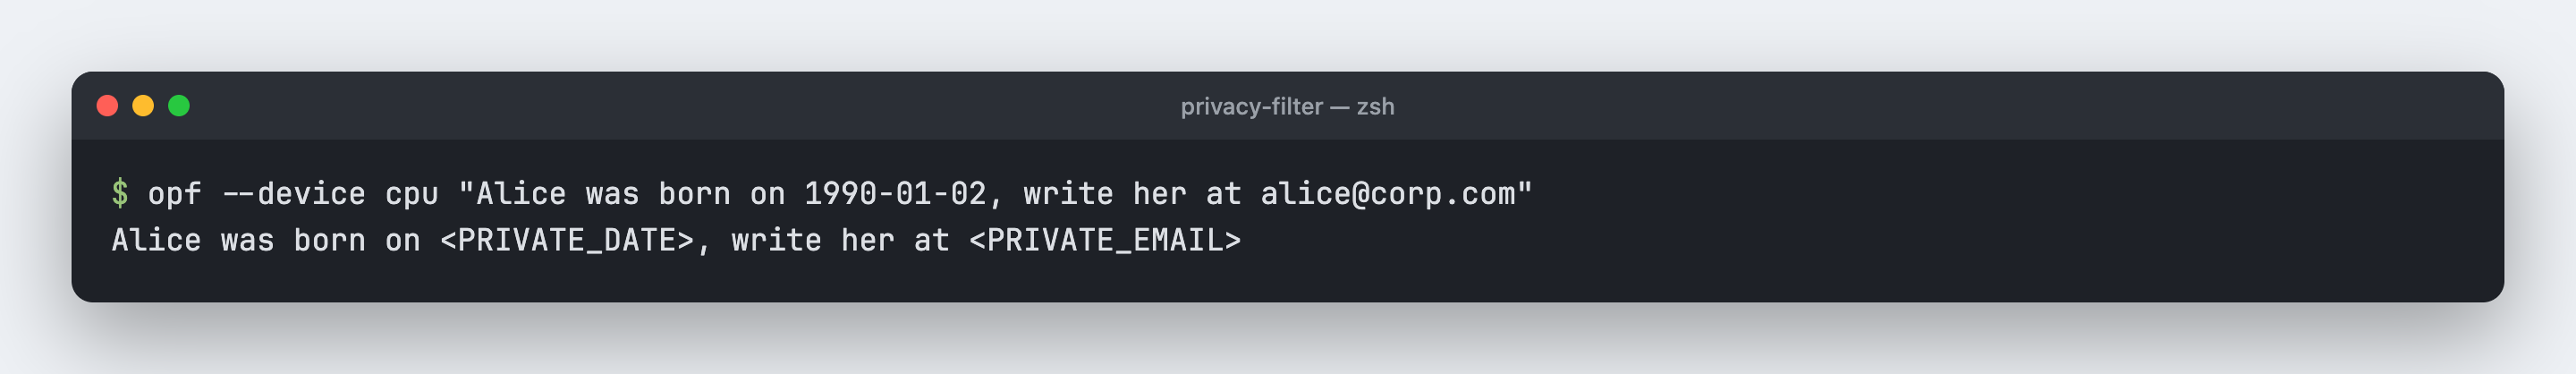
Видеокарту Mac через --device mps подключить не выйдет. Я попробовал: opf требует для MoE-слоёв пакет triton, а его под macOS нет. Так что на Mac через opf вариант один, процессор. Для Linux с NVIDIA флаг не нужен, команда работает как есть.
Если запустить opf без текста, он уйдёт в интерактивный режим: вводишь фразы по одной и сразу видишь разметку с цветной подсветкой. Удобно, чтобы прощупать модель на своих примерах до того, как писать скрипт.
Шаг 3. Как читать JSON-вывод
По умолчанию opf печатает только строку с плейсхолдерами. Для скриптов этого мало, поэтому есть флаг --format json: он отдаёт найденные фрагменты с позициями. Схема описана в OUTPUT_SCHEMAS.md.
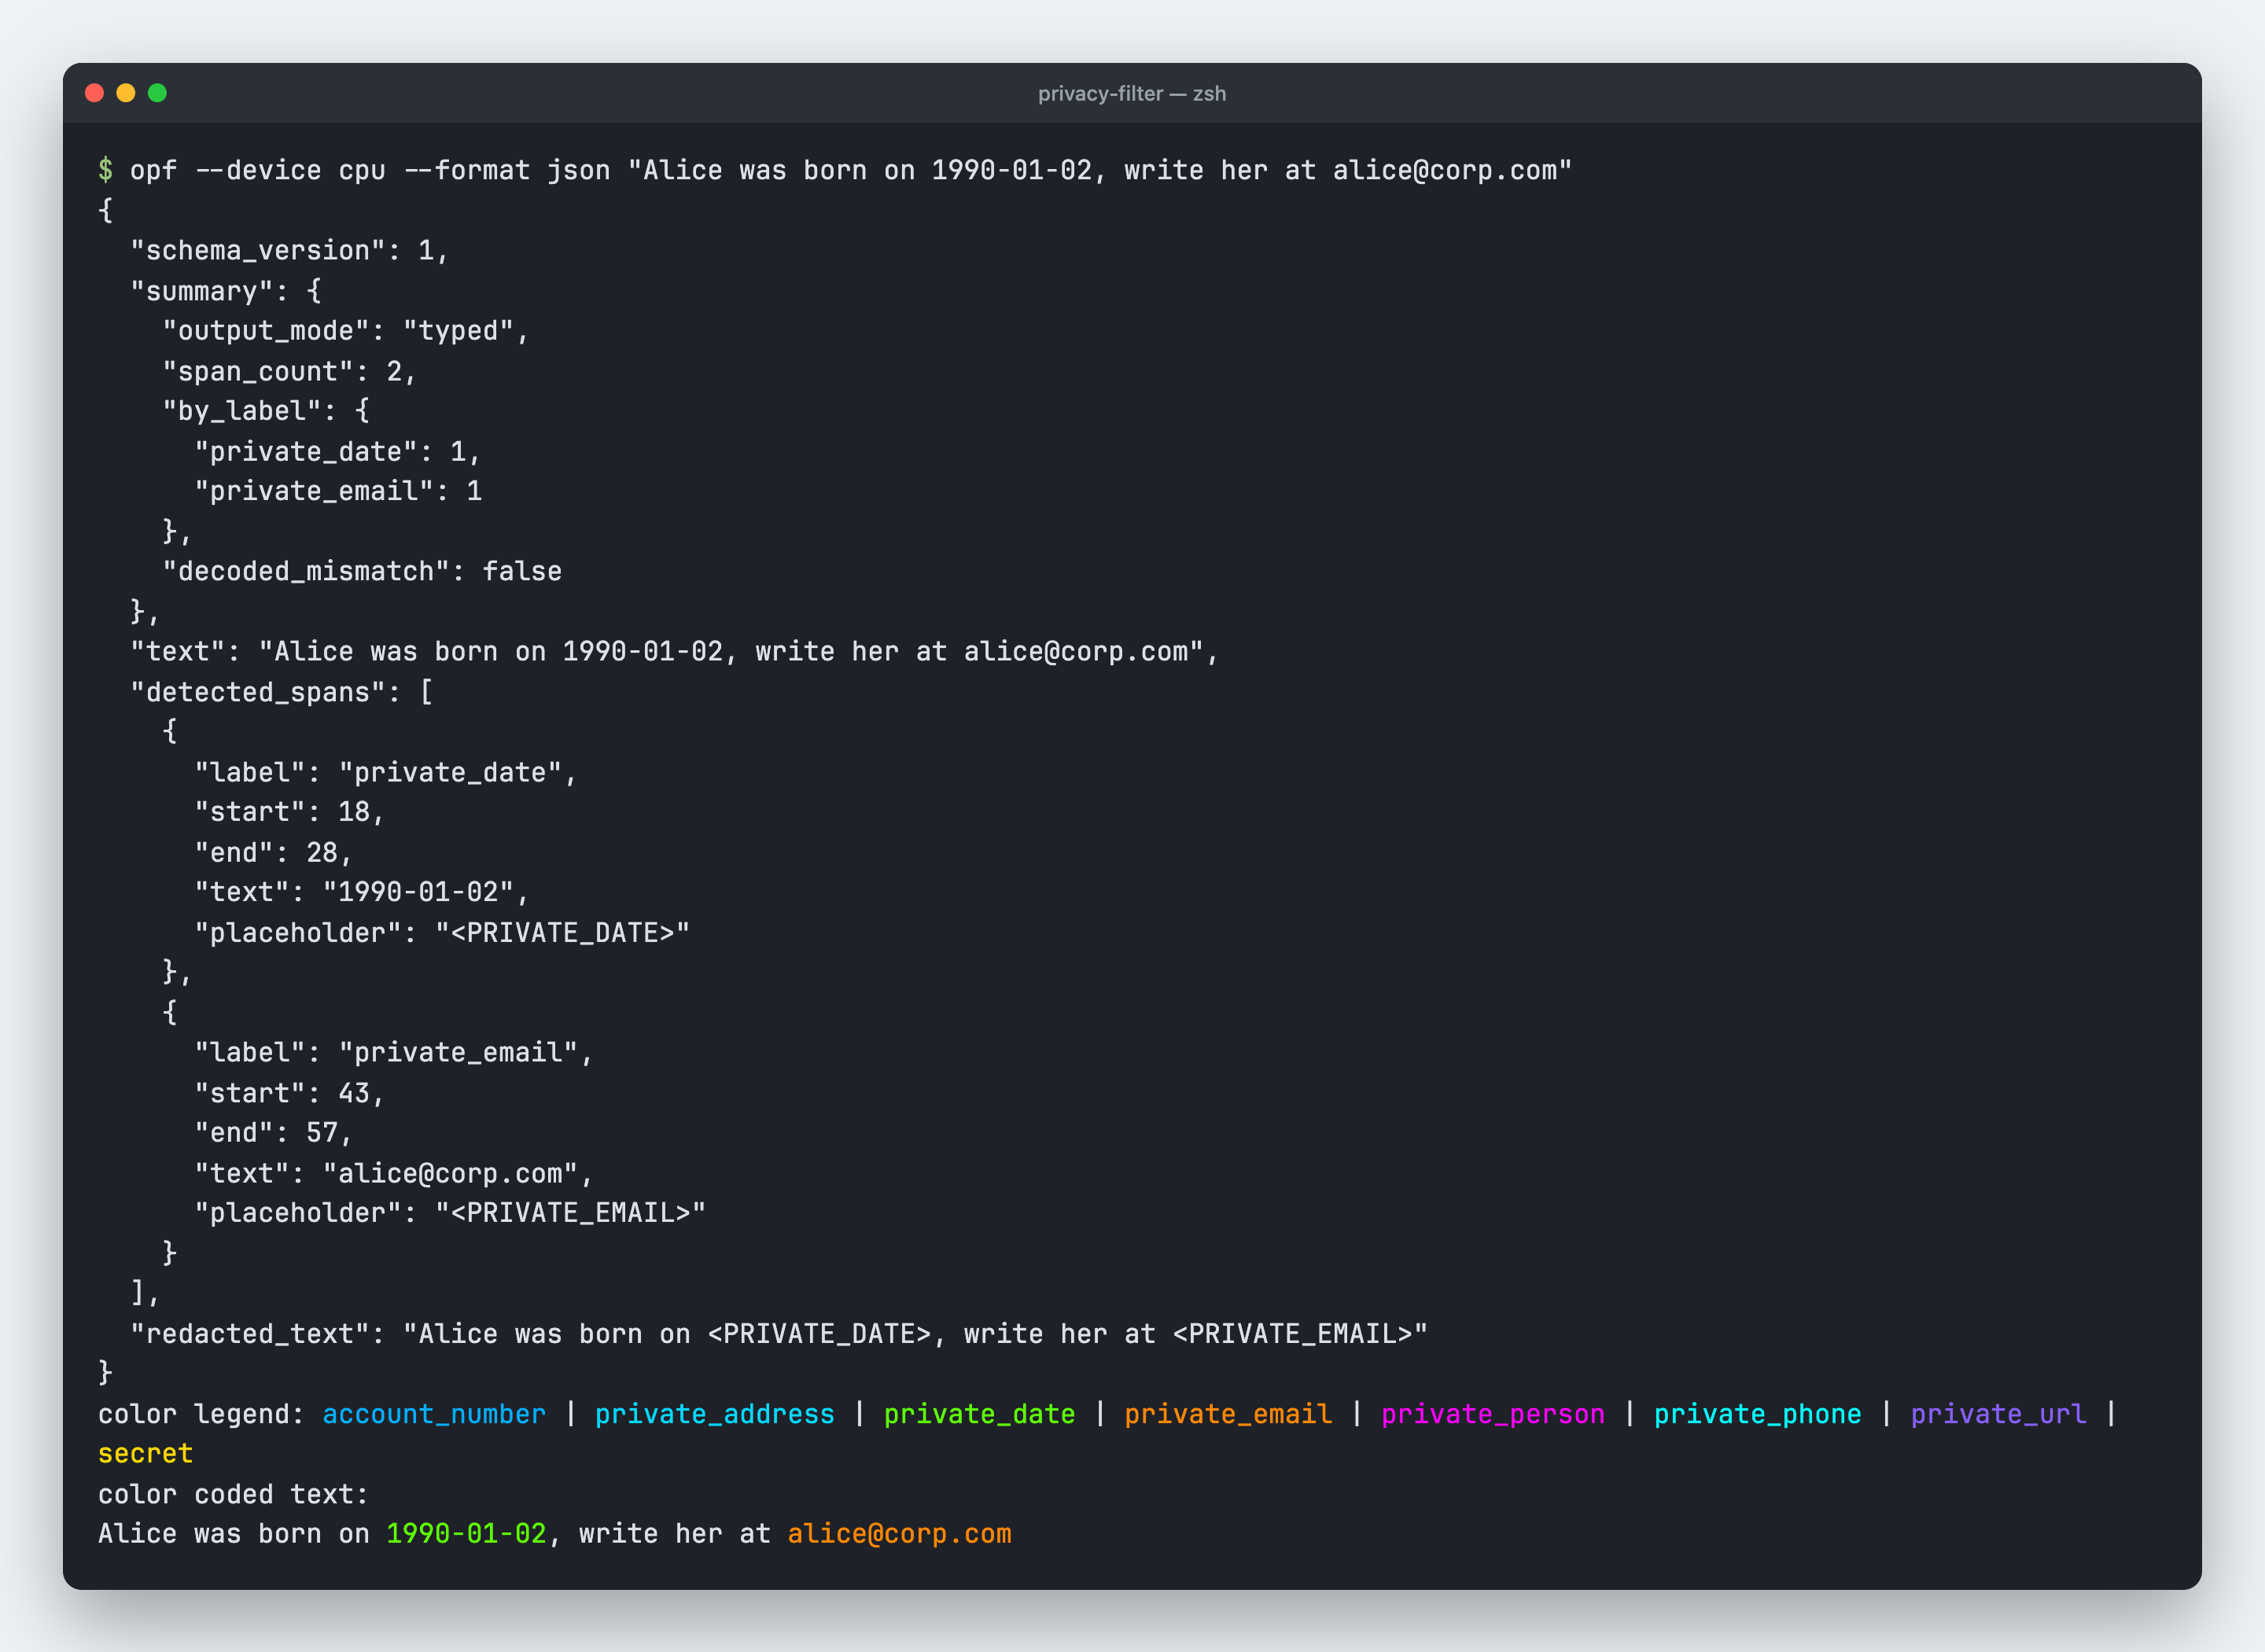
Всю работу делают два поля. В detected_spans лежит то, что нашла модель: тип (label), позиции в исходном тексте (start, end), сам фрагмент и плейсхолдер. В redacted_text уже готовый текст с плейсхолдерами, его можно сразу писать обратно в файл.
Поле summary.by_label удобно для мониторинга. Например, если в выгрузке, где раньше находилось 200 почт, вдруг нашлось 3, значит, поменялся формат данных и маска перестала срабатывать.
Режимов вывода два. --output-mode typed (по умолчанию) сохраняет категории: <PRIVATE_PERSON>, <PRIVATE_EMAIL> и так далее. --output-mode redacted сводит всё к одной метке: так проще, если тип не важен и задача просто вычистить данные.
Шаг 4. Почистить лог перед отправкой в нейросеть
Ради этого сценария модель обычно и ставят: чистка логов, тикетов и выгрузок до того, как они уйдут в чат с нейросетью, тикет-систему или чужое хранилище. Насколько это важно, хорошо видно по истории, где глава киберзащиты США загрузил служебные документы в ChatGPT.
opf чистит файл целиком (-f) и работает в пайпе, так что встаёт в любой однострочник:
opf --device cpu -f app.log
cat app.log | grep "user=" | opf --device cpu
Я собрал демо-лог из пяти строк с выдуманными данными и прогнал его через модель.
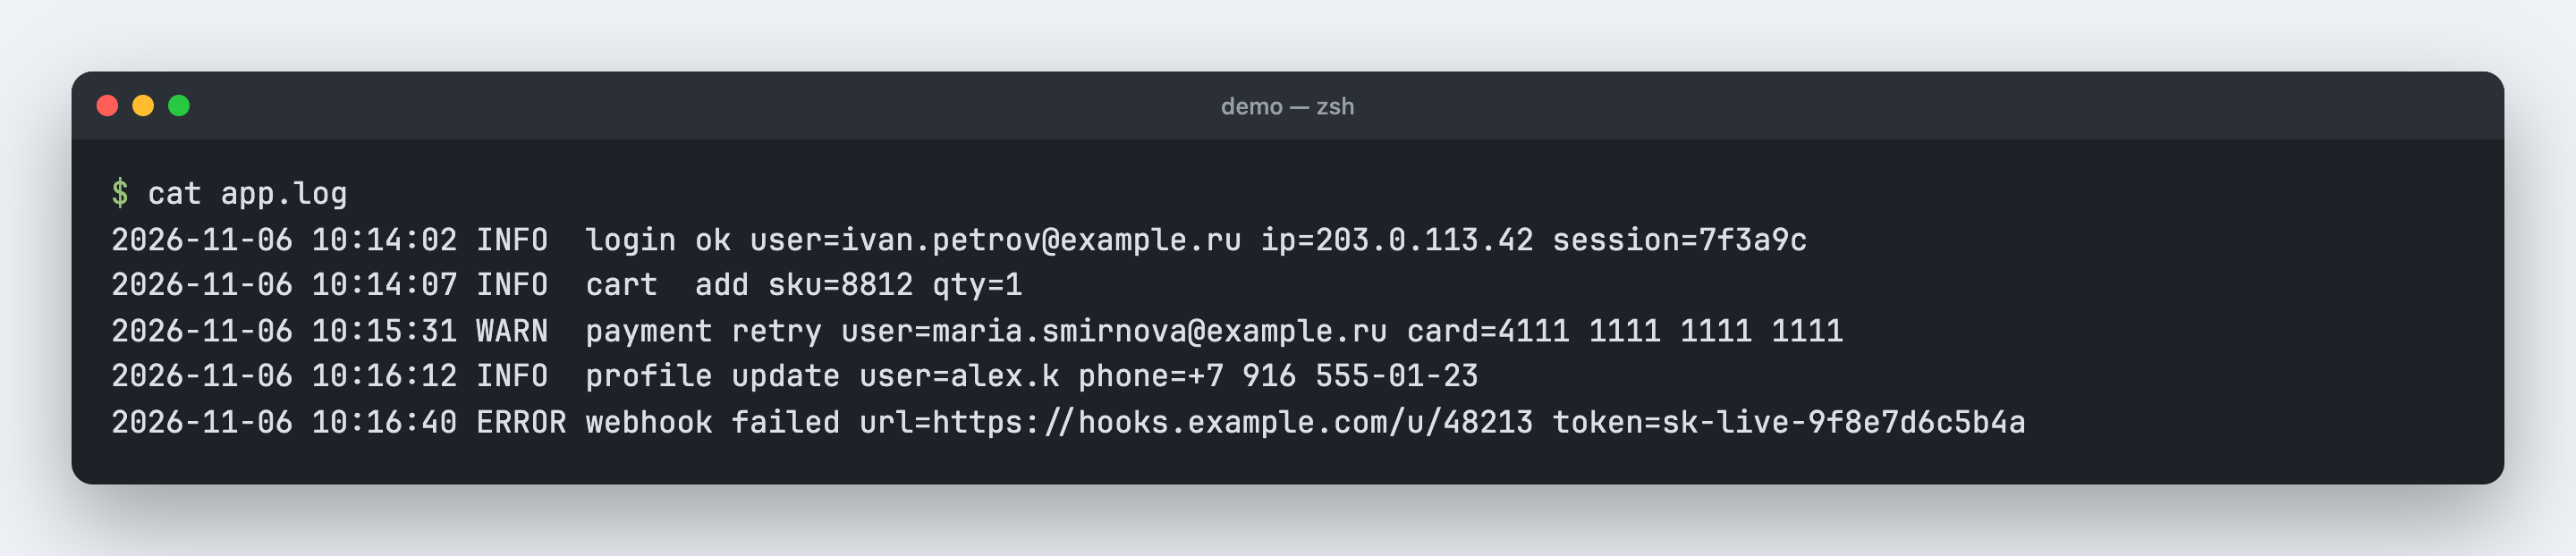
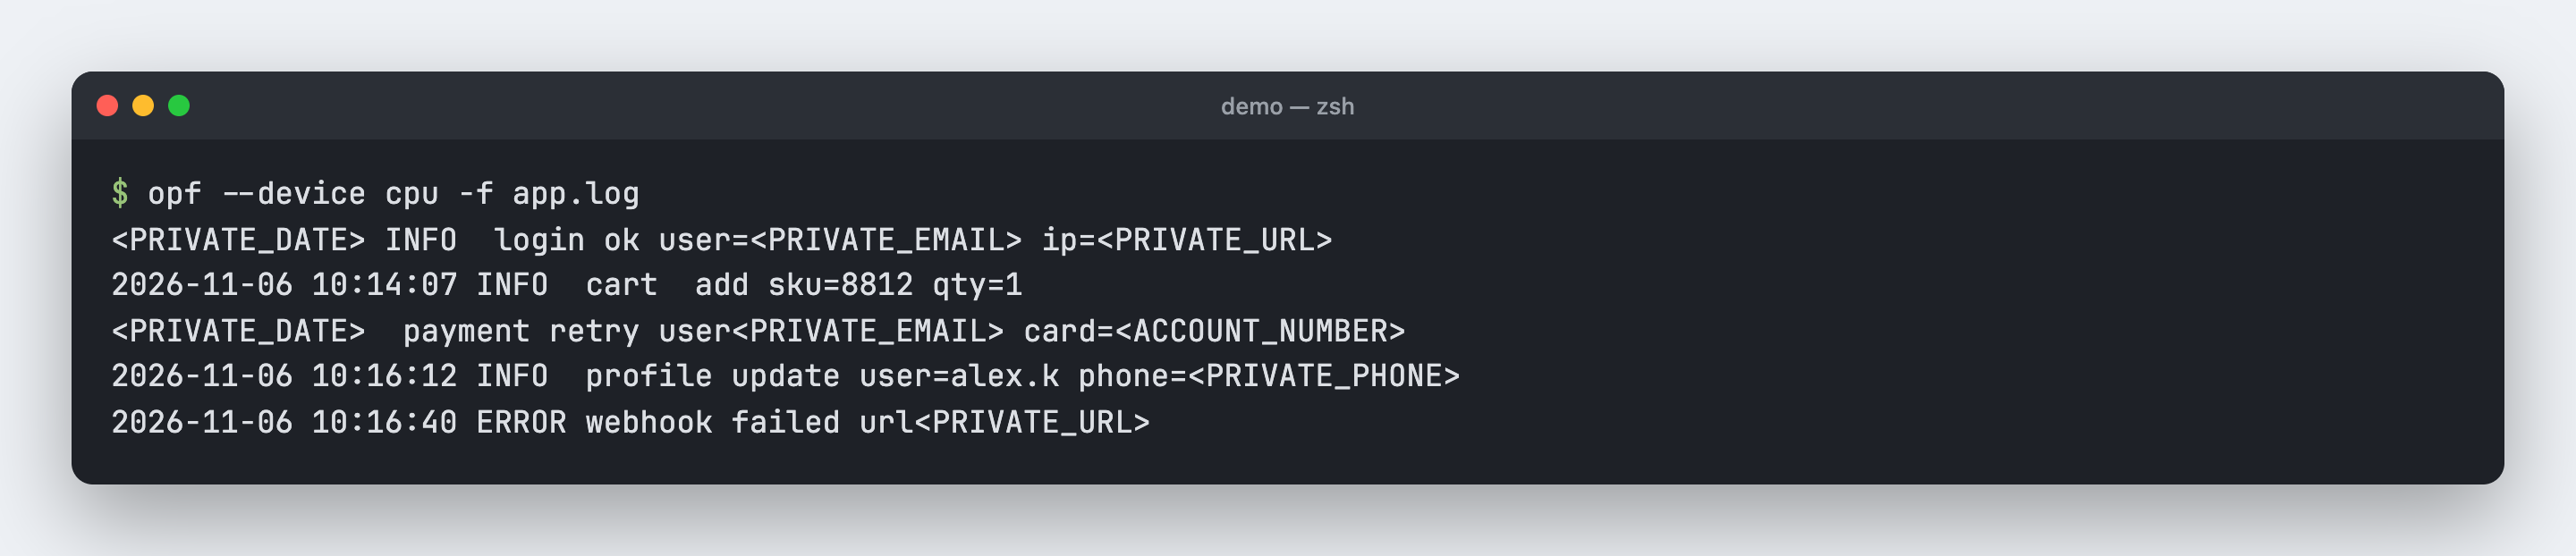
До: в логе почты, IP, номер карты, телефон и токен. После: почты, карту, телефон и токен модель спрятала, но пропустила логин alex.k, замаскировала не все даты и съела знак «=» после user. Скриншоты: терминал / matveev.tech
Почты, номер карты, телефон и URL с токеном ушли под маску. Но есть и промахи:
- логин
alex.kмодель за имя не посчитала; - из пяти дат в одинаковом формате замаскировала только две;
- IP-адрес и
session=7f3a9cслиплись в один<PRIVATE_URL>: отдельной категории для IP у модели нет; - маска откусила знак
=послеuserи словоWARNв третьей строке.
С .env похожая история. Пароль из строки подключения и ключ OpenAI модель нашла, но ключ AWS слился с ключом OpenAI в один фрагмент, и строка AWS_SECRET_ACCESS_KEY=... пропала из вывода целиком:
DATABASE_URL=postgres://<SECRET>
OPENAI_API_KEY=<SECRET>
Секрет при этом спрятан, но файл сломан: переменных было три, осталось две. Для логов, которые потом читает человек, это терпимо. Для конфигов, которые парсит программа, проверяй число строк до и после. Про то, почему сырые логи с ключами вообще не стоит отдавать агентам, я писал в статье о безопасности OpenClaw.
Английский тикет в поддержку модель, напротив, разобрала полностью: имя, номер заказа, телефон, почту и адрес.
Hi, this is <PRIVATE_PERSON> from Denver. My order #<ACCOUNT_NUMBER> hasn't arrived.
Call me at <PRIVATE_PHONE> or email <PRIVATE_EMAIL>.
My address: <PRIVATE_ADDRESS>.
Шаг 5. Встроить модель в код на Python
Если чистка нужна постоянно (предобработка датасета, фильтр перед индексацией, маска перед логированием), запускать CLI на каждую строку дорого. Каждый вызов opf заново грузит модель: в моих замерах на файл уходило от 17 до 40 секунд, и почти всё это время занимала загрузка. Поэтому модель стоит загрузить в Python один раз.
Первый способ: родной API opf. Пакет opf уже содержит класс OPF, ничего доустанавливать не нужно:
from opf import OPF

redactor = OPF(device="cpu", output_text_only=True)

for line in open("app.log", encoding="utf-8"):
    print(redactor.redact(line.rstrip("\n")))
Без output_text_only=True метод вернёт объект с detected_spans и redacted_text, как в JSON из шага 3.
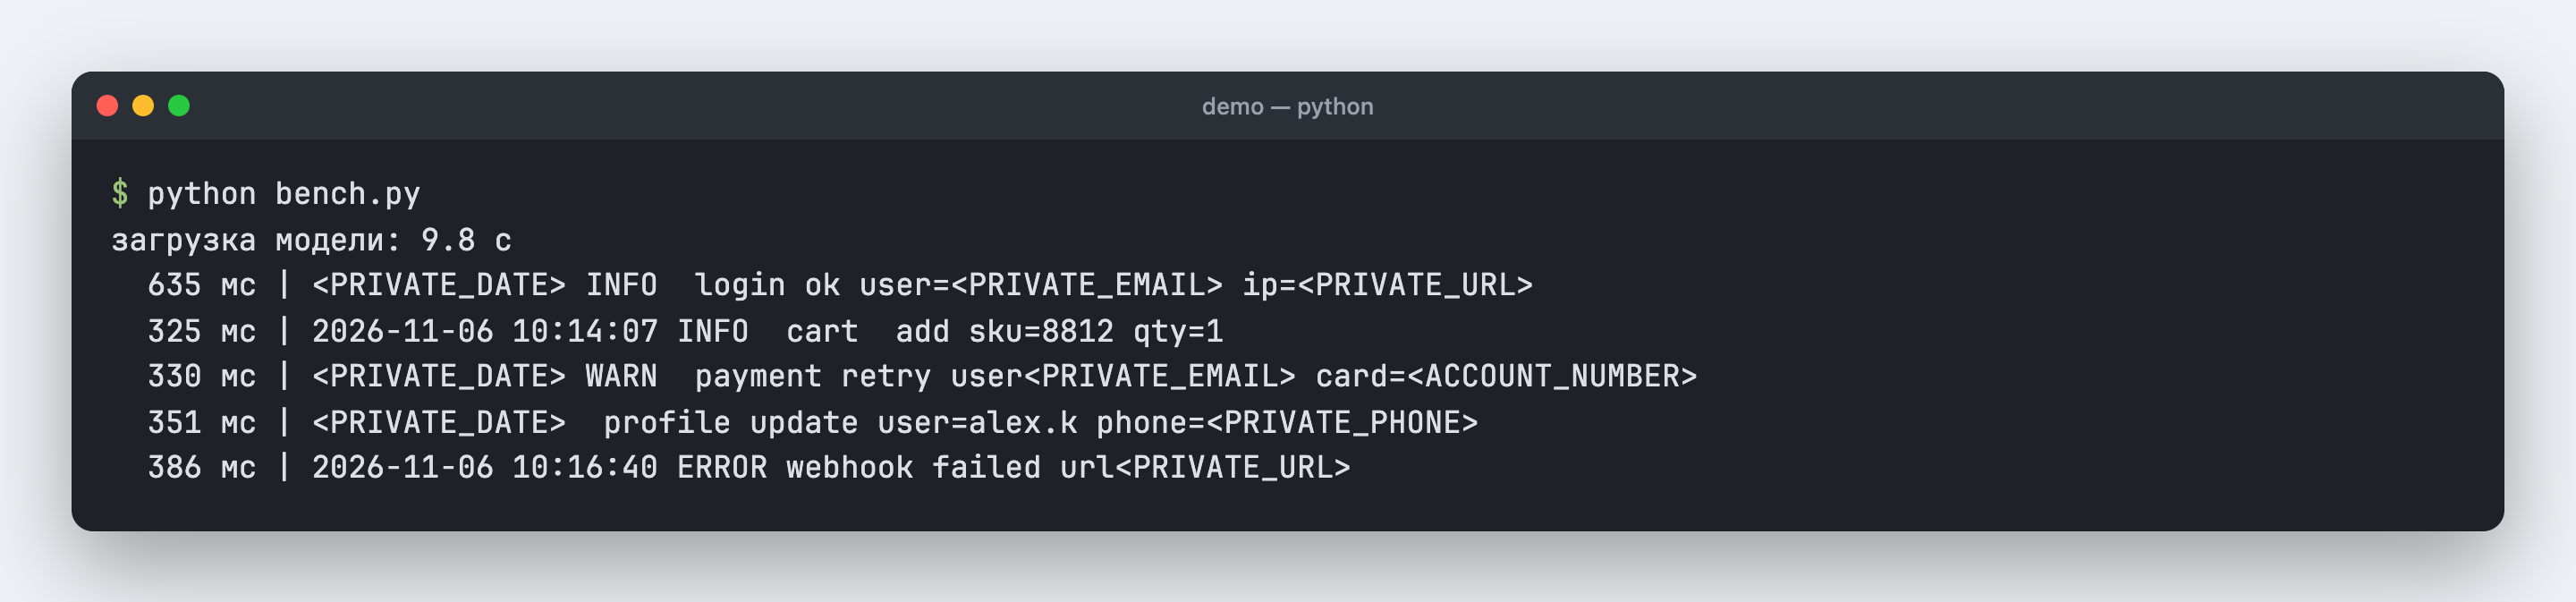
На процессоре M4 Pro модель грузится 10–14 секунд, а строка лога проходит за 0,3–0,6 секунды. Когда параллельно шли другие тяжёлые задачи, время на строку вырастало до 0,7–1,5 секунды. Для чистки выгрузок перед отправкой этого хватает. Для потока логов в реальном времени на процессоре уже нет.
Второй способ: pipeline из transformers. Privacy Filter поддерживается в transformers (я проверял на версии 5.22.2), так что подходит стандартный pipeline. Учти, что веса он скачает ещё раз, в кеш Hugging Face, отдельно от ~/.opf.
Тут меня ждала ловушка. В июльской версии гайда я брал aggregation_strategy="simple", и эта стратегия режет каждую сущность на куски: Pri + ya, priya@example.co + .uk. Со стратегией "first" фрагменты собираются целиком:
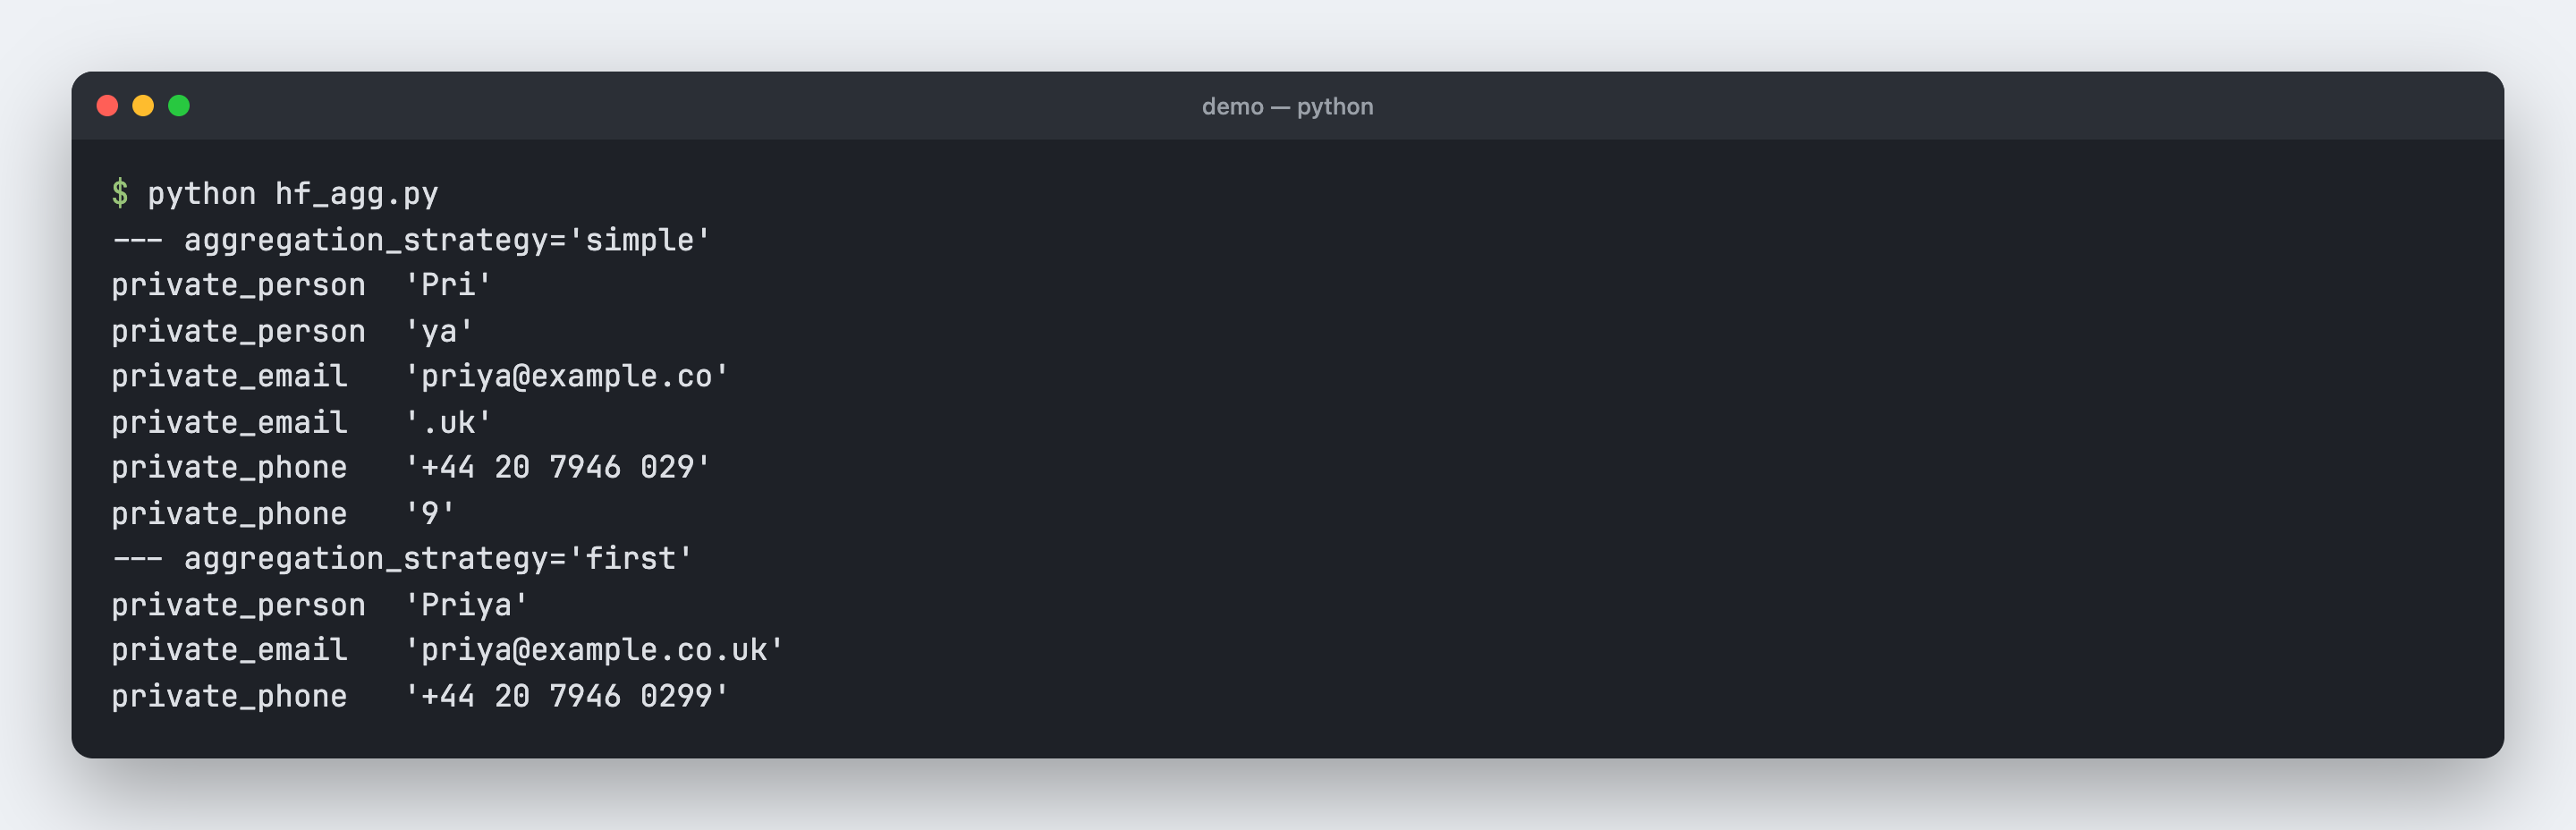
Рабочий вариант:
from transformers import pipeline

clf = pipeline(
    "token-classification",
    model="openai/privacy-filter",
    aggregation_strategy="first",  # simple режет сущности на части
    device="cpu",
)

for s in clf("Contact Priya at priya@example.co.uk or +44 20 7946 0299"):
    print(s["entity_group"], s["start"], s["end"], s["word"].strip())
Через transformers модель работает и на видеокарте Mac (device="mps"). Но быстрее не стало: после прогрева та же строка заняла 0,5–0,9 секунды, примерно как на процессоре. Чем заменять найденное (плейсхолдером, хешем или пустой строкой), решаешь сам по позициям start и end.
Как OpenAI Privacy Filter справляется с русским языком
OpenAI прямо пишет в карточке модели, что модель обучена в основном на английском и на других языках точность падает. Я проверил, насколько сильно, на трёх русских текстах: анкете, паспортных данных и сообщении из рабочего чата.
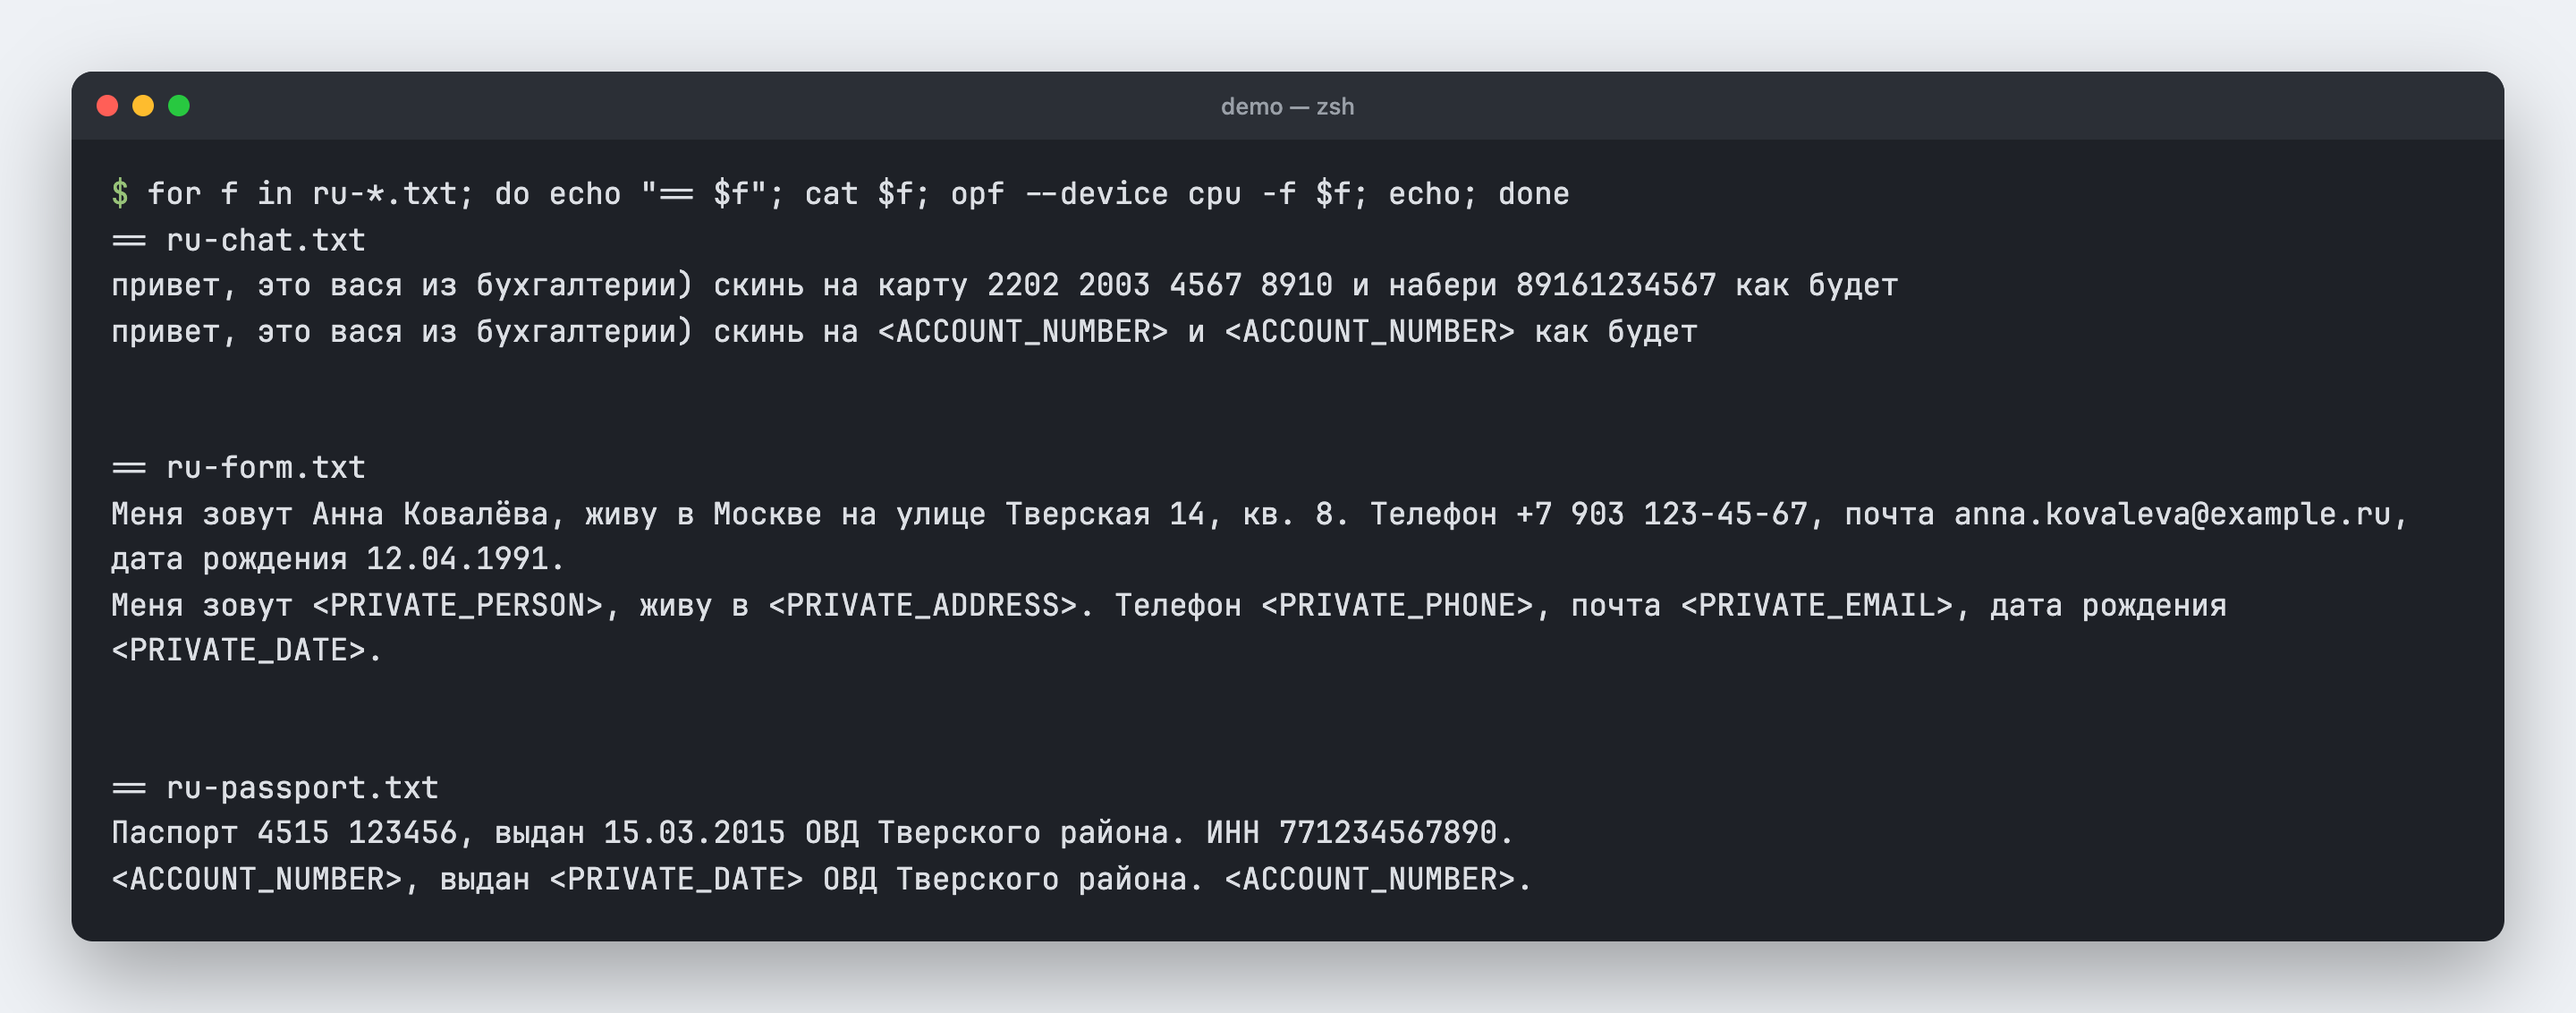
Формальный текст модель разбирает хорошо: в анкете нашлись имя, адрес, телефон, почта и дата рождения. Неформальный чат даётся хуже. «Вася» с маленькой буквы остался в тексте, телефон попал в <ACCOUNT_NUMBER>, а маска съела соседние слова «карту» и «набери».
Чтобы перейти от впечатлений к цифрам, я разметил шесть русских текстов (20 сущностей) и прогнал их через opf eval:
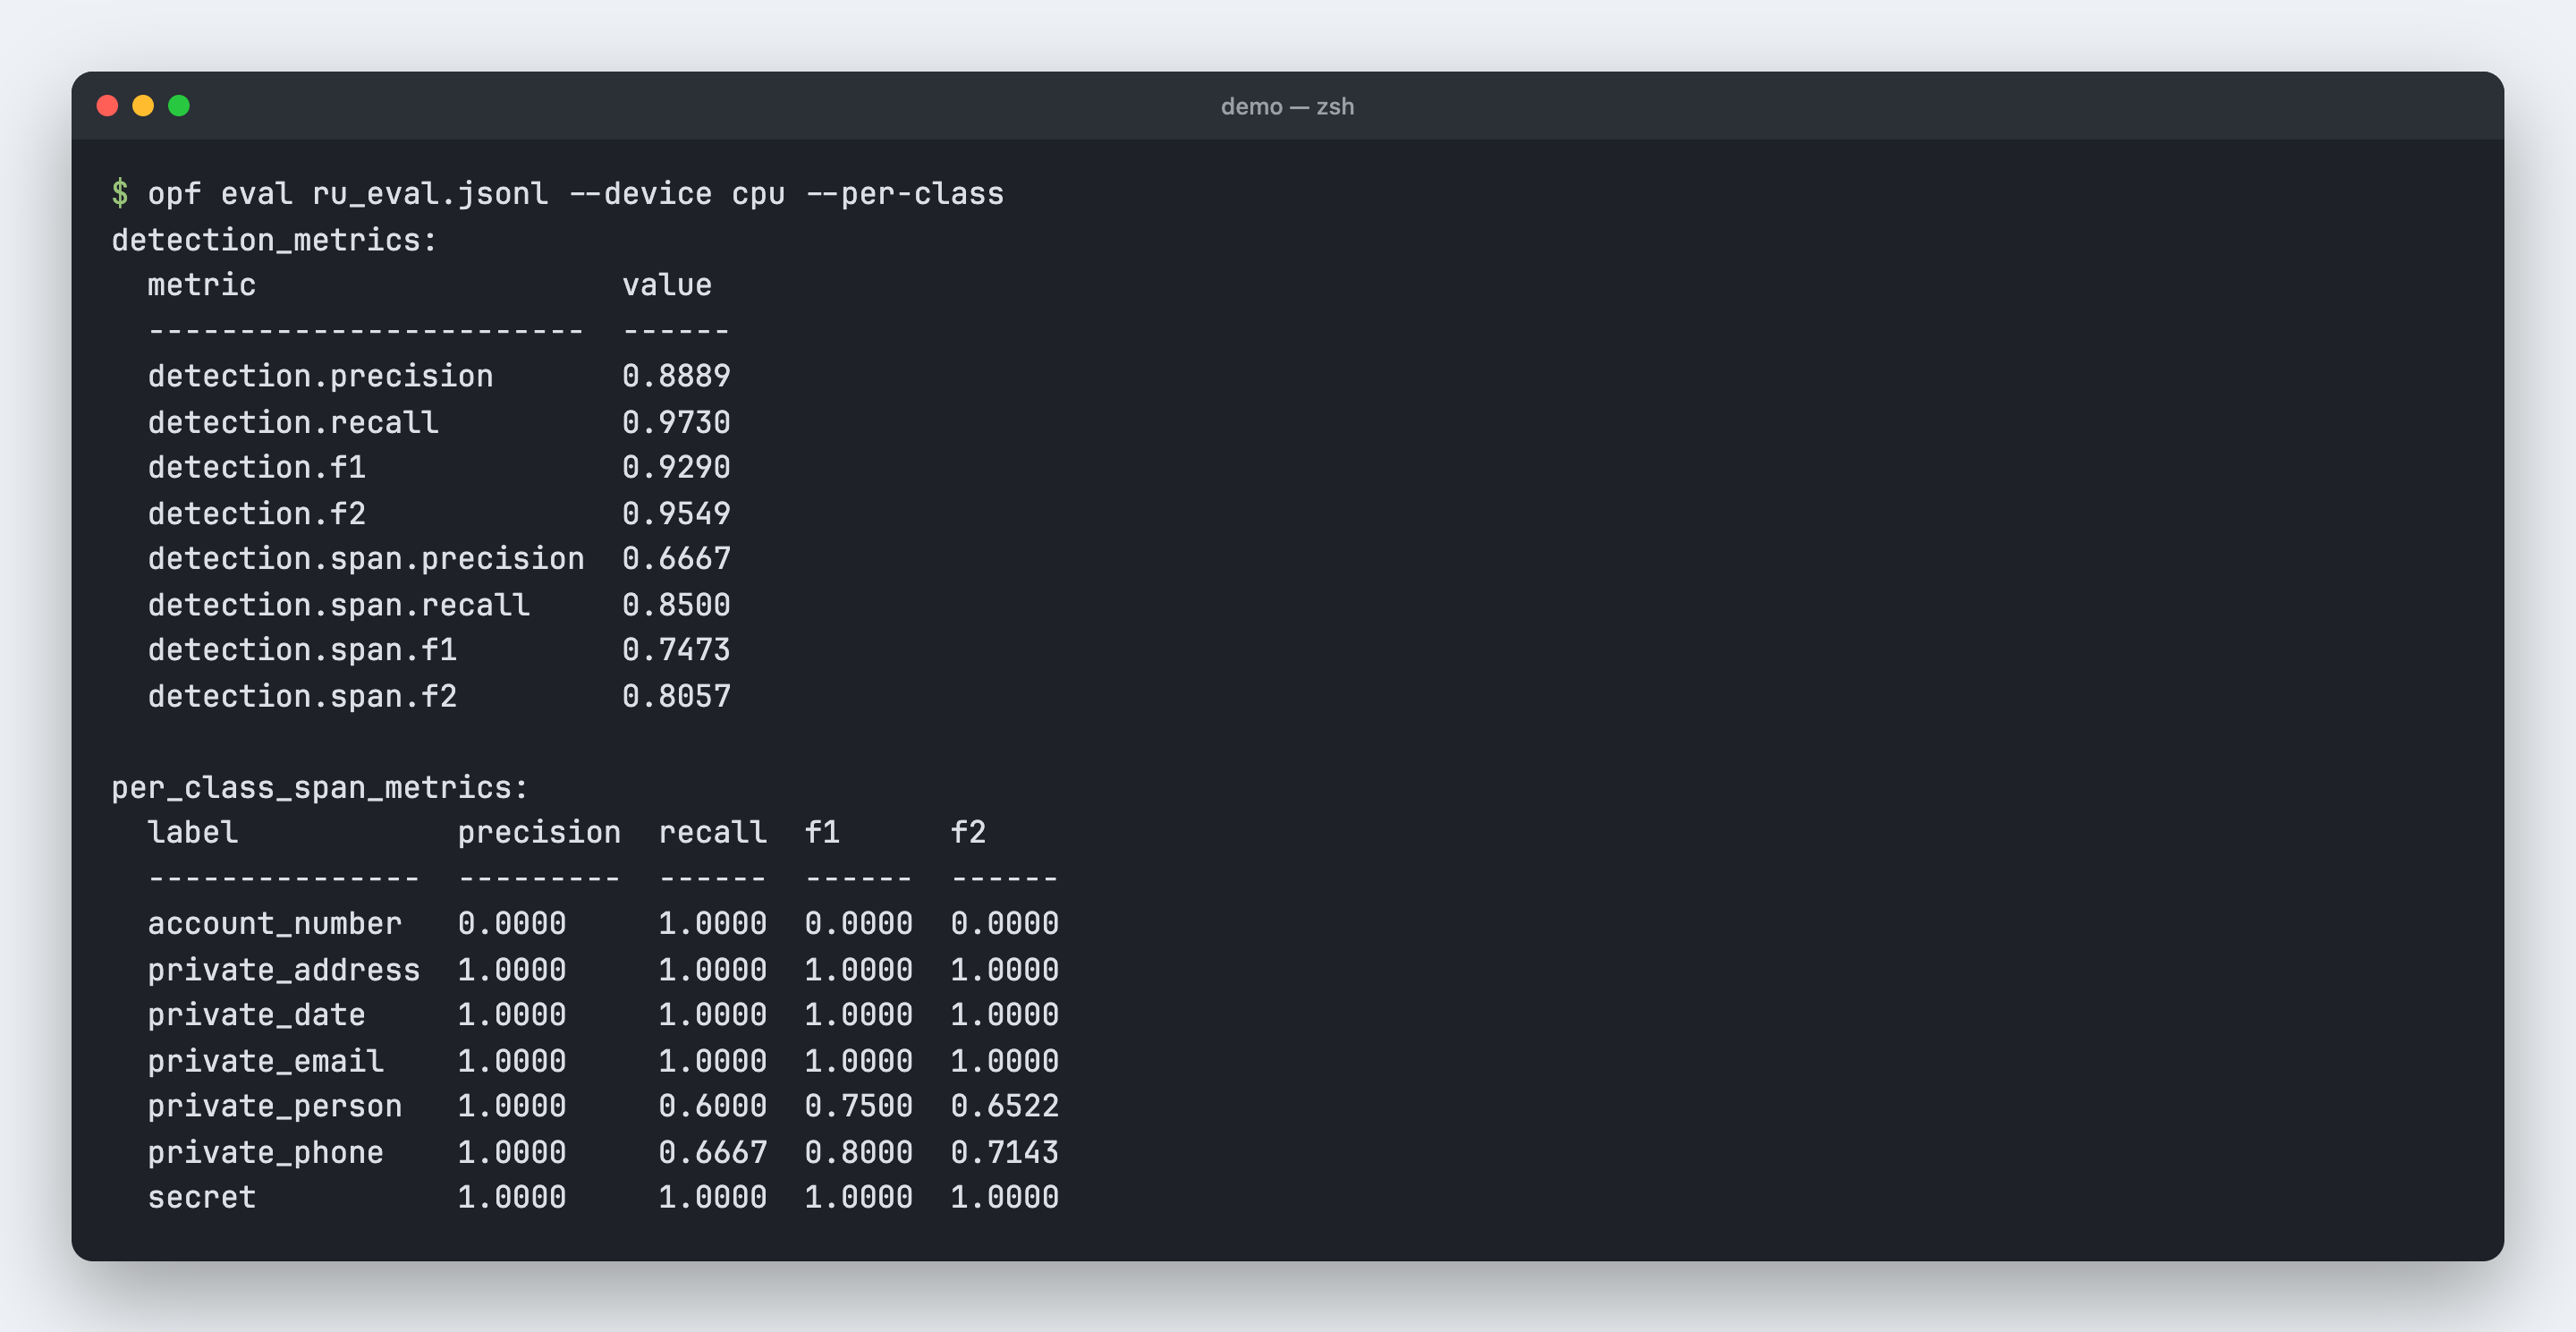
| Что | Результат на 6 русских текстах |
|---|---|
| Найдено персональных данных (полнота по токенам) | 97% |
| Фрагменты с точными границами (span precision) | 67% |
| Имена | 3 из 5, пропущены «вася» и «Дима» |
| Телефоны | 2 из 3, третий записан в номер счёта |
| Номера документов, карт и счетов | 5 из 5 найдены, но во всех маска съела слово рядом: «Паспорт», «ИНН», «карту», «Счёт», «№» |
| Даты, почты, адреса, пароли | все найдены |
Выборка маленькая, это проверка на ощупь, а не бенчмарк. Но картина понятная: на русском модель находит почти всё структурированное и теряет короткие неформальные имена. Маска при этом часто прихватывает соседнее слово.
Готового русского варианта я не нашёл. Самые скачиваемые дообученные версии от OpenMed расширяют модель до 54–55 категорий: privacy-filter-multilingual-v2 на 16 языках, privacy-filter-nemotron-v2 на 20 европейских. Русского нет ни в одной. Так что для русских текстов путь пока один: дообучение на своих данных, о нём в шаге 7.
Шаг 6. Поднять полноту через калибровку Viterbi
По умолчанию модель настроена на точность: если сомневается, она промолчит. На «грязных» данных это заметно. Tonic.ai в своём тесте получил полноту из коробки от 10% на веб-страницах до 38% на медицинских записях.
Сдвинуть баланс можно без переобучения. После классификатора работает декодер Viterbi: он собирает метки токенов в связные фрагменты, и у него есть шесть смещений переходов. В скачанном чекпоинте лежит viterbi_calibration.json с единственной точкой default, где все смещения нулевые. Готовых пресетов «строже» и «мягче» нет, свою настройку собираешь сам.
Я сделал файл, который штрафует фон и поощряет начало фрагмента:
{
  "operating_points": {
    "default": {
      "biases": {
        "transition_bias_background_stay": -2.0,
        "transition_bias_background_to_start": 2.0,
        "transition_bias_end_to_background": 0.0,
        "transition_bias_end_to_start": 0.0,
        "transition_bias_inside_to_continue": 0.0,
        "transition_bias_inside_to_end": 0.0
      }
    }
  }
}
Подключается он флагом --viterbi-calibration-path recall-2.json или в Python через redactor.set_viterbi_decoder(calibration_path="recall-2.json"). Вот тот же лог с тремя настройками:
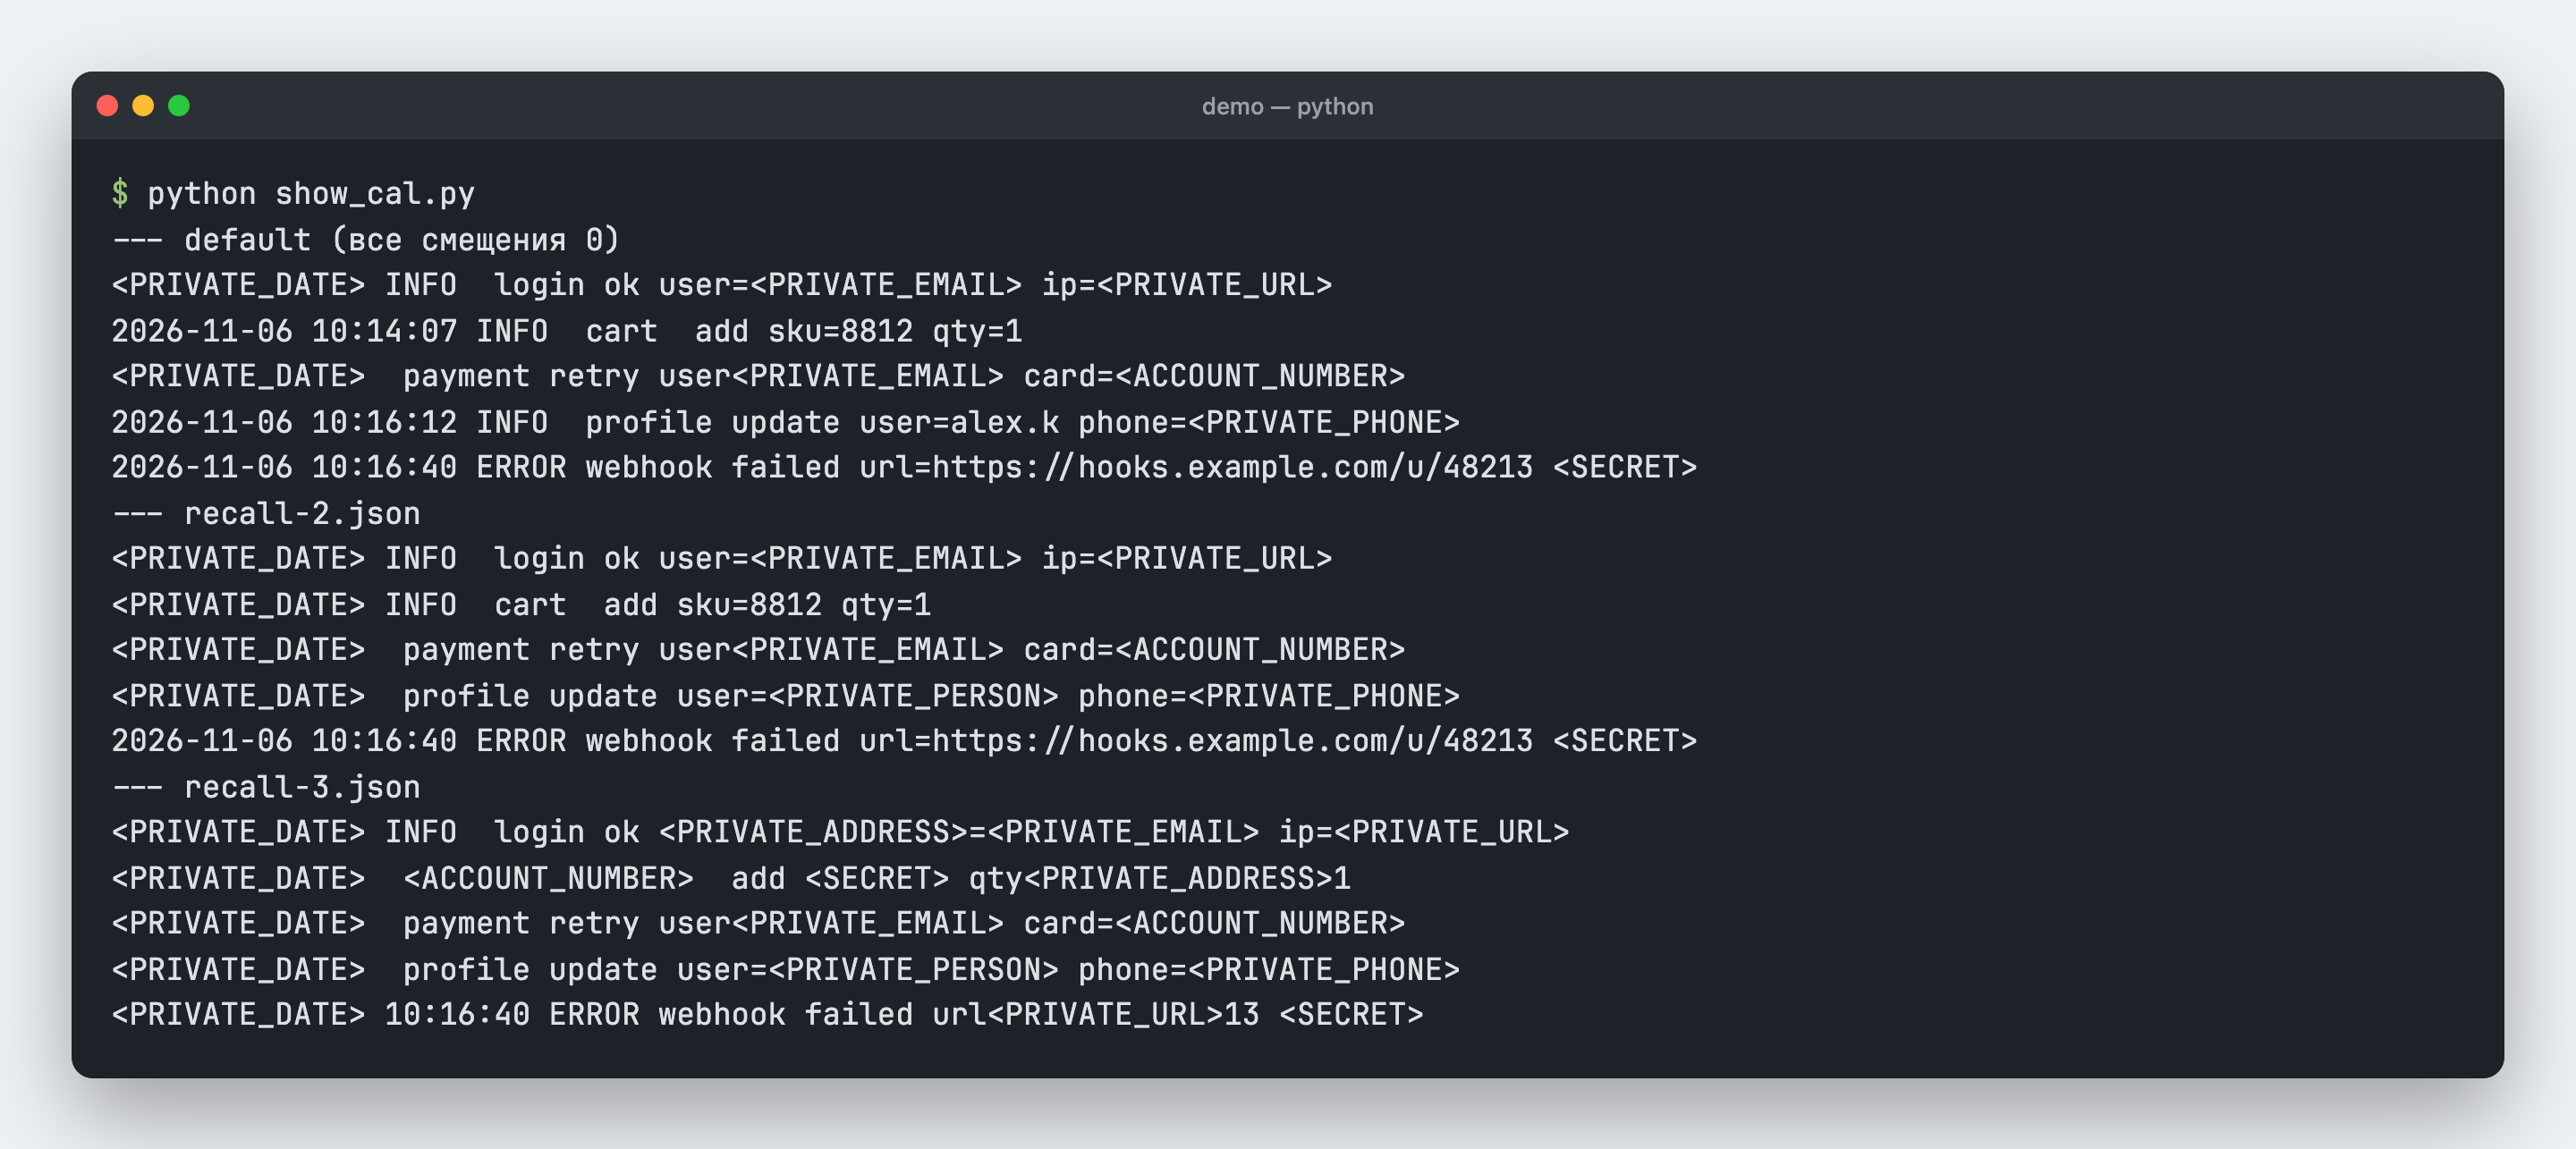
При смещении 2 нашлись логин alex.k и ещё две даты, лишних срабатываний не появилось. При смещении 3 модель пошла вразнос: слово cart стало номером счёта, sku=8812 секретом, а user адресом. «Васю» из русского чата не поймала ни одна настройка: калибровка помогает с тем, что модель почти видит, но не учит её новому.
Подбирай смещения на размеченной выборке своих данных через opf eval --viterbi-calibration-path: так видно, сколько полноты ты получаешь и сколько точности теряешь. Для данных, которые пойдут в обучение модели, можно маскировать агрессивнее. Для текста, который потом читают аналитики, важнее аккуратность.
Шаг 7. Дообучить модель под свои данные
Если домен специфичный (русские чаты, медицинские записи, свой формат логов), калибровки не хватит. Дообучение здесь обходится недорого. По данным анонса OpenAI от 22 апреля 2026 года, даже небольшой набор данных поднял F1 на доменной задаче с 54% до 96%.
Данные нужны в формате JSONL: в каждой строке текст и размеченные фрагменты с позициями. Вот строка из моего русского набора для opf eval, тот же формат подходит для opf train:
{"text": "Паспорт 4515 123456, выдан 15.03.2015 ОВД Тверского района. ИНН 771234567890.", "spans": {"account_number: 4515 123456": [[8, 19]], "private_date: 15.03.2015": [[27, 37]], "account_number: 771234567890": [[65, 77]]}, "info": {"id": "ru_2"}}
Минимальный запуск:
opf train train.jsonl \
  --validation-dataset val.jsonl \
  --output-dir ./my_checkpoint \
  --device cpu
На выходе получится папка с config.json и model.safetensors, её потом подсовываешь через --checkpoint. Свою таксономию меток задаёт --label-space-json (первой меткой обязательно идёт фоновая O). Именно так OpenMed собрала версии на 54 категории: в карточке прямо указано, что их учили штатным opf train. Готовые демо-скрипты лежат в FINETUNING.md и в папке examples/scripts/finetuning.
На процессоре train идёт медленно: даже eval на шести коротких текстах занимал у меня от 3 до 22 секунд чистого счёта в зависимости от нагрузки. Для обучения на тысячах примеров лучше арендовать машину с NVIDIA.
Что проверить, если модель не запускается или молчит
pip install падает. Скорее всего, Python ниже 3.10. Проверь python3 --version и заведи окружение на свежей версии. С uv проще всего: uv venv --python 3.12.
AssertionError: Torch not compiled with CUDA enabled. Это дефолтный --device cuda. Добавь --device cpu, а в Python передай OPF(device="cpu").
Triton-backed MoE kernels require the optional triton dependency. Ты указал --device mps. Под macOS opf так не работает, оставайся на cpu или бери transformers с device="mps".
Первый запуск долго висит. opf качает 2,8 ГБ весов. На машине без интернета скачай чекпоинт заранее и укажи путь через OPF_CHECKPOINT или --checkpoint.
Каждый вызов занимает полминуты. Так CLI загружает модель на каждый запуск. Для потока строк держи модель в памяти через Python API из шага 5.
Модель почти ничего не находит. Это консервативный дефолт из шага 6, на русском и нетипичных данных он заметнее. Помогут калибровка или дообучение, переустановка не поможет.
В выводе пропали строки или слова рядом с маской. Фрагмент захватил соседние символы или перенос строки, как с ключом AWS в .env. Сверяй число строк до и после и смотри start и end в JSON-выводе.
Частые вопросы
Можно ли запустить Privacy Filter в браузере? Да. Модель собрана под Transformers.js и работает на WebGPU без сервера: pipeline("token-classification", "openai/privacy-filter", { device: "webgpu", dtype: "q4" }). В репозитории модели лежат ONNX-веса в нескольких точностях, включая q4 и fp16.
Делает ли Privacy Filter данные обезличенными по закону? Нет. OpenAI называет модель инструментом минимизации данных, а не анонимизации, и прямо советует оставлять ручную проверку в медицине, юриспруденции и финансах. Юридической гарантии ни по GDPR, ни по 152-ФЗ модель не даёт.
Есть ли версия для Apple Silicon побыстрее? Есть конвертации под MLX, например mlx-community/openai-privacy-filter-4bit. Работают они не через opf, а через свой рантайм, поэтому флаги из этого гайда к ним не подходят.
С чего начать сегодня
Возьми один реальный лог или выгрузку, которую собирался отдать нейросети, и прогони её через opf --device cpu --format json -f файл. Потом открой detected_spans и посчитай, сколько персональных данных модель пропустила. Если промахов больше пары на сотню строк, размечай 20–30 примеров в формате из шага 7: на них и подбирается калибровка, и с них начинается дообучение.
Другие инструменты, где нейросеть решает конкретную задачу, собраны в разделе «Нейросети для задач».
Читайте также
- OpenAI Privacy Filter: обзор открытой модели для PII: архитектура, бенчмарки и где модель ошибается на реальных данных
- OpenClaw и безопасность: как не стать жертвой своего AI-агента: какие данные нельзя отдавать агенту и как ограничить ему доступ
- DiffSense: AI генерирует коммиты прямо на твоём Mac: ещё один пример локальной нейросети, которой не нужен сервер
- Nemotron 3.5 Lightning: быстрая открытая модель для агентов: открытые модели NVIDIA, на датасете которой учили версию Privacy Filter на 55 категорий