Мультиагенты в OpenAI Codex: настройка и примеры
Мультиагентный режим Codex на ноябрь 2026: что включено по умолчанию, как описать роли агентов и почему на маленьком проекте один агент оказался вдвое быстрее.
· обновлено · 11 мин
Четыре агента Codex исправили три бага в моём демо-проекте за 111 секунд. Один агент справился с той же задачей за 56 и потратил почти вчетверо меньше токенов. Мультиагенты в OpenAI Codex — это режим, в котором главный агент запускает дочерних, раздаёт им части задачи и сводит ответы в один итог. В Codex CLI 0.166.0 режим включён по умолчанию, а настраивать нужно роли агентов в config.toml и правило, когда делегировать работу.
Первую версию этой статьи я писал в феврале, когда мультиагенты были экспериментальной функцией за флагом. С тех пор OpenAI сделали режим стабильным, переименовали команды, сняли модели из моих примеров и запретили ролям менять песочницу. Ниже инструкция на ноябрь 2026 года, проверенная 6 ноября на Codex CLI 0.166.0. Через всю статью идёт один пример: корзина интернет-магазина с тремя багами. На ней я настроил роли, запустил три агента-исследователя и одного исполнителя, сравнил их с одним агентом и проверил правило в AGENTS.md.
В статье разберём:
- как устроен мультиагентный режим в Codex;
- как включить и выключить дочерних агентов;
- как настроить роли агентов в config.toml;
- как агенты Codex нашли и исправили три бага;
- когда мультиагенты быстрее одного агента;
- как заставить Codex делегировать без просьбы в промпте;
- как управлять запущенными агентами;
- какие ошибки ломают работу агентов.
Как устроен мультиагентный режим в Codex
Главный агент получает от Codex набор инструментов для работы с другими агентами: запустить агента, отправить ему сообщение, дождаться результата, прервать. Каждый дочерний агент (в документации его называют subagent) работает в своём потоке, со своим контекстом и своей моделью. В главный чат он возвращает короткую выжимку, а не логи и стектрейсы.
Зачем это нужно, OpenAI объясняют в документации двумя терминами. Context pollution: полезное тонет в шуме промежуточного вывода. Context rot: качество ответов падает по мере того, как чат заполняется лишним. Мультиагенты уносят шумную работу в отдельные потоки, и главный агент держит в голове только требования и решения. Второй плюс это параллельность: пока один агент читает модуль оплаты, другой уже разбирает доставку.
Схема похожа на паттерн параллелизации, который Anthropic описывали в гайде по воркфлоу агентов: задачу режут на независимые куски, гоняют их одновременно и собирают результат. В Codex роль оркестратора играет главный агент, а нарезку определяешь ты промптом или правилами проекта.
В Codex есть три встроенных агента, и для первого запуска их хватит:
defaultберёт задачи общего назначения;workerправит код и чинит баги;explorerчитает и исследует кодовую базу.
Мультиагенты работают в Codex CLI, в десктопном приложении ChatGPT и в расширении для IDE. В феврале потоки агентов были видны только в терминале, теперь приложение и IDE показывают их панелью над полем ввода. Про подключение Codex к редакторам от JetBrains я писал в гайде по Codex в JetBrains IDE.
Как включить и выключить дочерних агентов в Codex
Ничего включать не нужно. В справочнике конфигурации флаг features.multi_agent помечен как stable и «on by default», а ключ agents.enabled по умолчанию равен true. Команда /experimental из старой версии статьи больше не про мультиагентов: в ней теперь сетевой прокси и запрет сна во время работы.
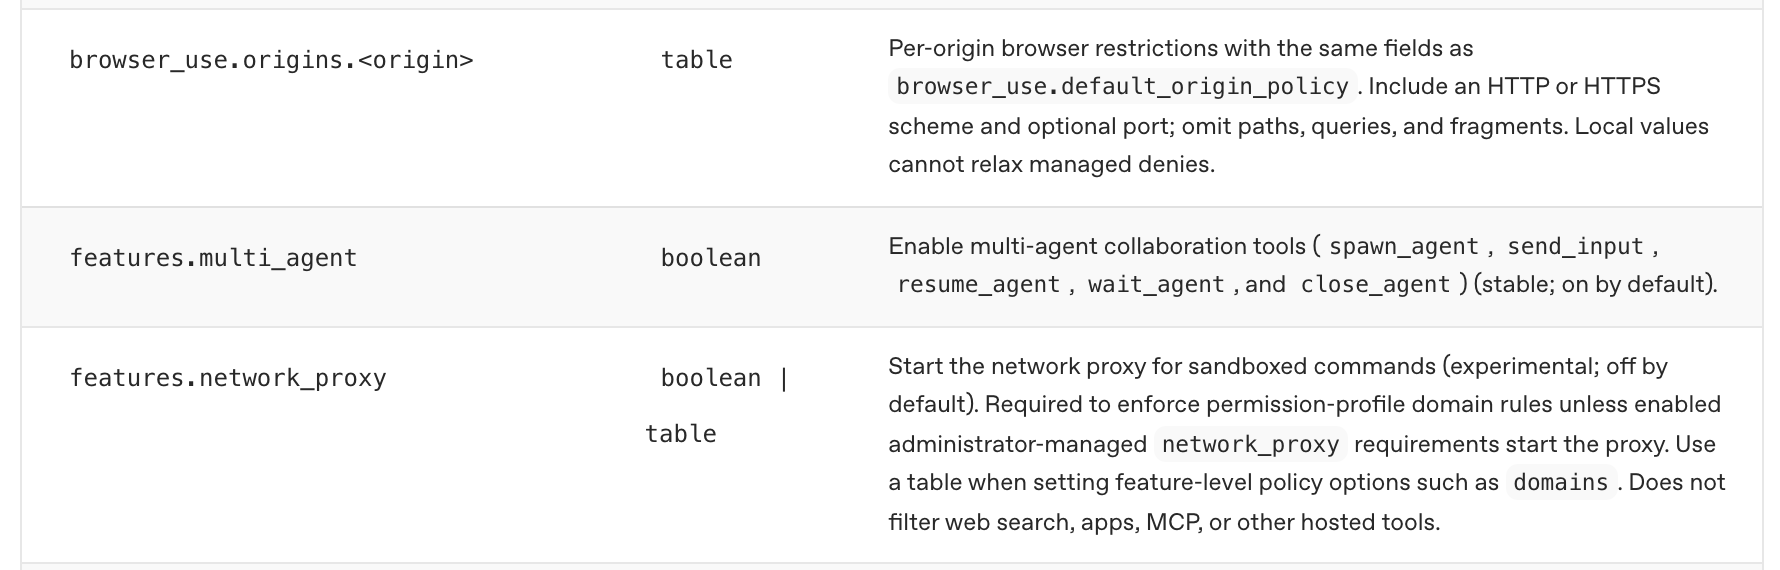
Если строка multi_agent = true в секции [features] осталась у тебя с февраля, она не мешает. Для обычного пользователя флаг ничего не меняет, а администраторам он нужен, чтобы закрепить режим включённым или выключенным для всей команды.
Выключают мультиагентов ключом agents.enabled. Глобально это строка в ~/.codex/config.toml:
[agents]
enabled = false
Для одного запуска хватит флага -c agents.enabled=false. Я проверил разницу на двух прогонах codex exec: попросил агента перечислить инструменты для работы с другими агентами.
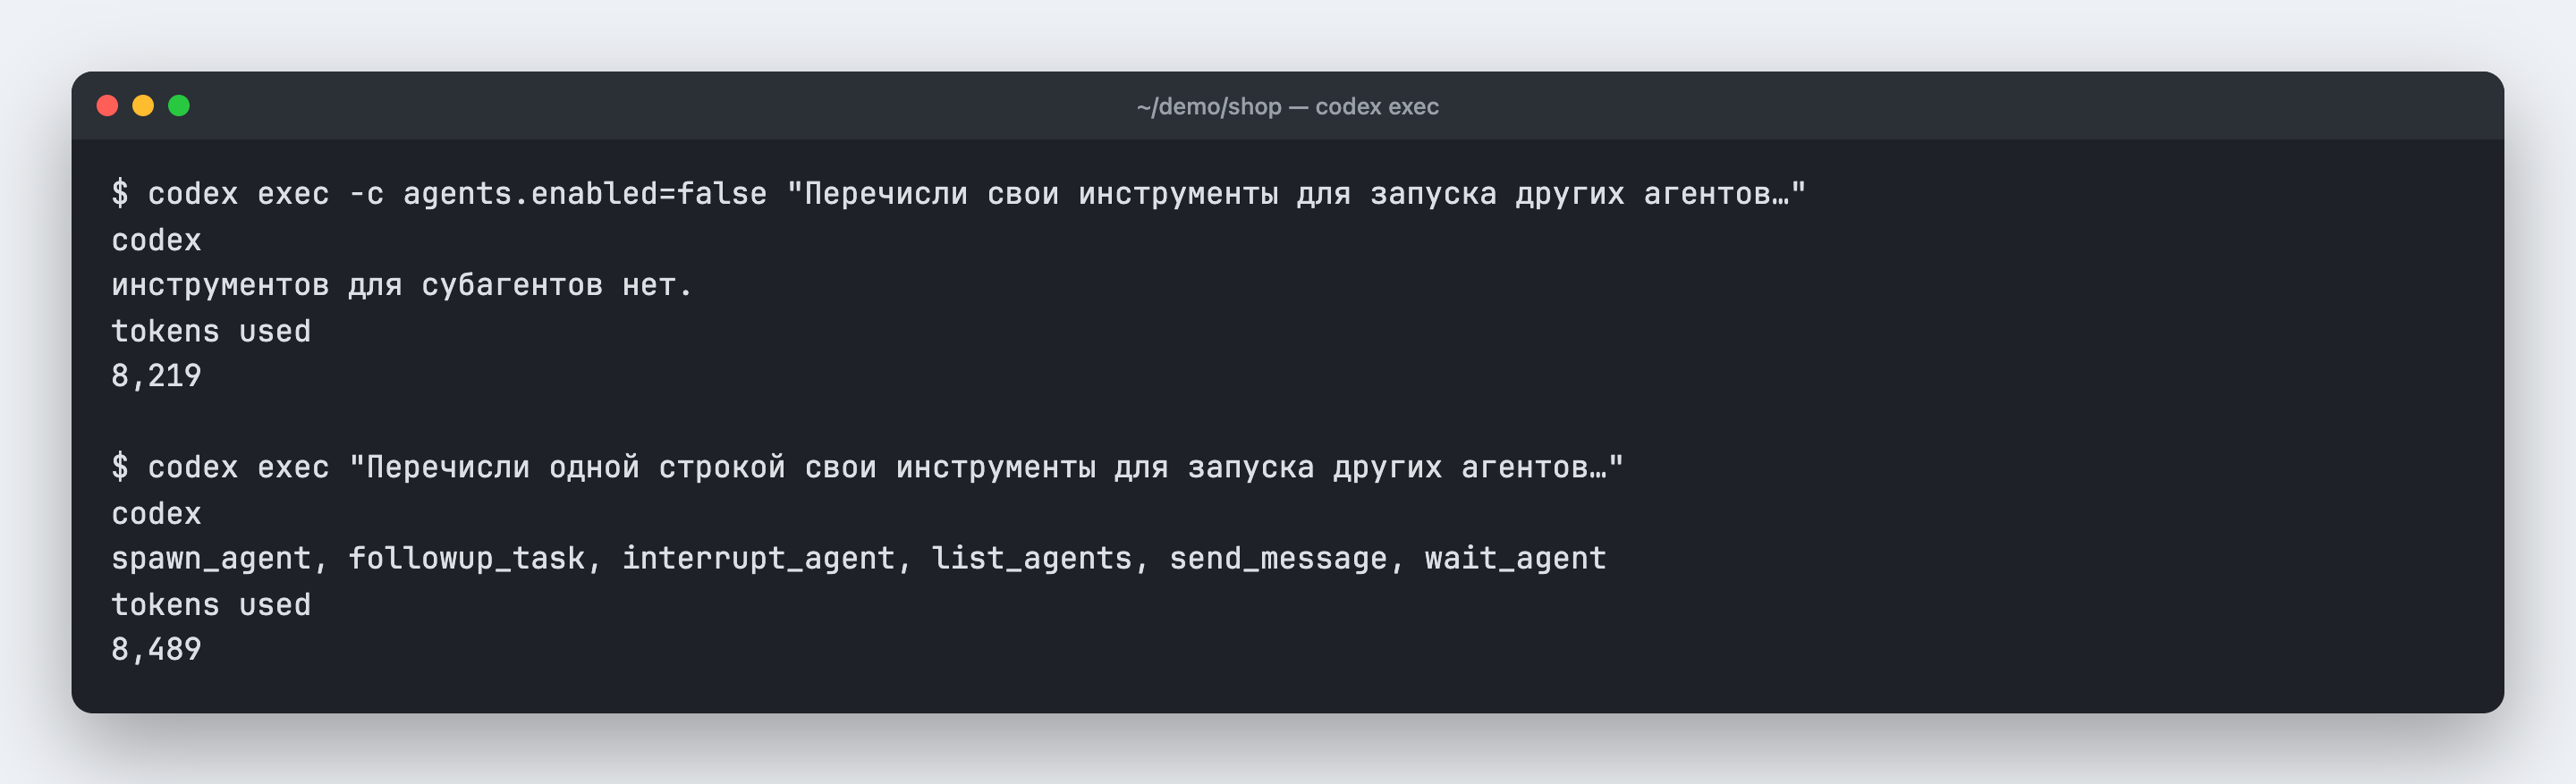
Обрати внимание на имена. В справочнике до сих пор перечислены send_input, resume_agent и close_agent, а Codex CLI 0.166.0 на 6 ноября выдал модели spawn_agent, wait_agent, send_message, followup_task, interrupt_agent и list_agents. Набор я сверил по журналу сессии в ~/.codex/sessions, а не только по ответу модели. Для обычной работы это неважно, имена инструментов ты сам не вызываешь. Но если пишешь хуки или разбираешь журналы, ориентируйся на свою версию CLI, а не на документацию.
Как настроить роли агентов в config.toml
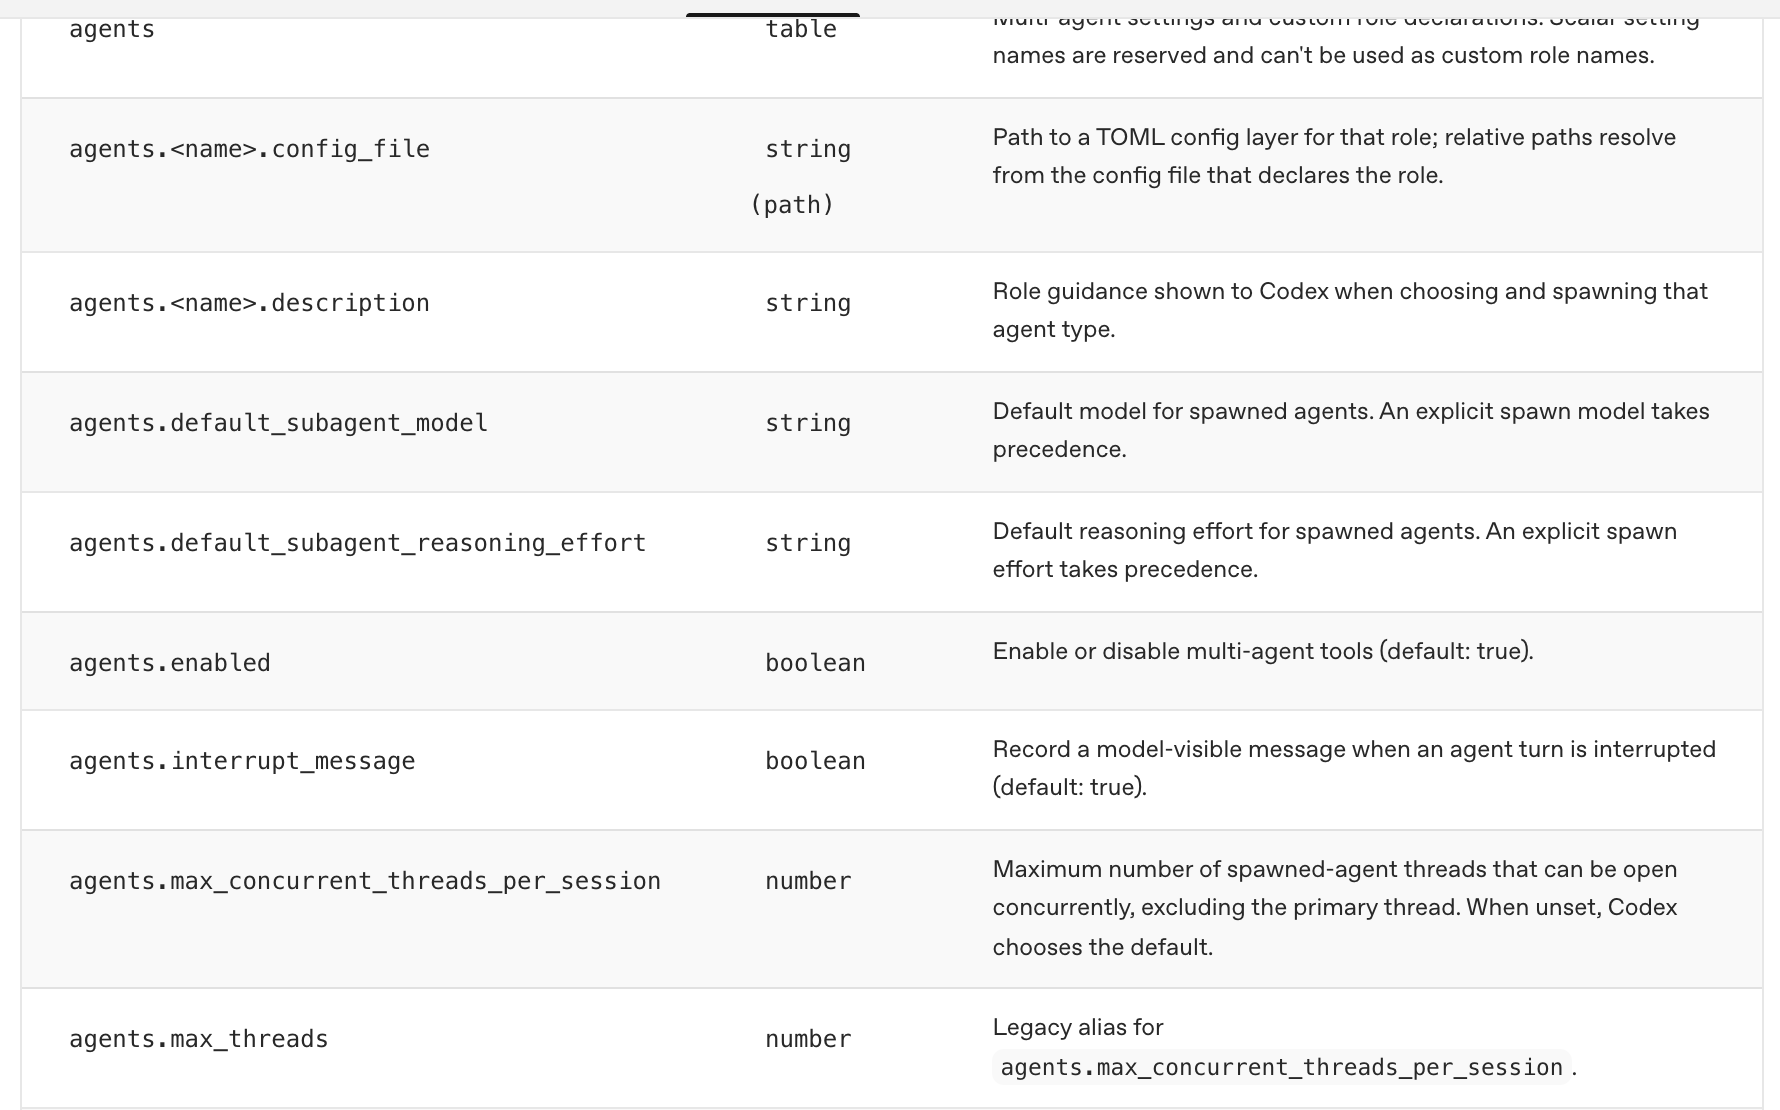
Роль это именованный тип агента со своей моделью и инструкциями. В config.toml у роли два поля: description подсказывает главному агенту, когда её звать, а config_file указывает на файл с настройками. Относительный путь в config_file считается от того config.toml, где объявлена роль.
Для демо я завёл две роли в проектном .codex/config.toml. Исследователь mapper только читает и ищет баги, исполнитель fixer их чинит:
[agents]
max_concurrent_threads_per_session = 4

[agents.mapper]
description = "Исследователь: разбирает один модуль и ищет баги. Файлы не правит."
config_file = "agents/mapper.toml"

[agents.fixer]
description = "Исполнитель: чинит найденные баги минимальной правкой и гоняет тесты."
config_file = "agents/fixer.toml"
Файл роли это обычный слой конфигурации. Исследователю я дал быструю и дешёвую GPT-6 Luna с высоким уровнем рассуждений:
# .codex/agents/mapper.toml
model = "gpt-6-luna"
model_reasoning_effort = "high"
developer_instructions = """
Ты разбираешь ровно один модуль, который назвал родительский агент.
Файлы не меняй. Найди баги на границах значений и в обработке ввода.
Верни список: файл, строка, что не так, каким тестом это видно.
"""
Исполнителю досталась GPT-6.1 Sol со средним уровнем: ему нужно аккуратно править код, а не перебирать гипотезы.
# .codex/agents/fixer.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
developer_instructions = """
Чини только баги из сводки родительского агента, минимальной правкой.
Не трогай тесты. После правки запусти .venv/bin/python -m pytest -q и приложи итог.
"""
Кроме ролей в секции [agents] есть глобальные ключи:
max_concurrent_threads_per_sessionограничивает, сколько дочерних агентов открыто одновременно, не считая главного. Старое имяmax_threadsработает как синоним;default_subagent_modelиdefault_subagent_reasoning_effortзадают модель и уровень рассуждений агентам, у которых они не указаны. Явное указание при запуске агента главнее;interrupt_messageрешает, сообщать ли модели, что её ход прервали (по умолчанию да).
Имена этих ключей зарезервированы, роль с именем enabled или max_threads завести нельзя. Роли из проектного .codex/config.toml Codex читает только в доверенных проектах, при первом открытии он спросит.
Есть и второй способ описать агента: отдельный TOML-файл в ~/.codex/agents/ или .codex/agents/ с полями name, description и developer_instructions. Он удобнее, когда агентов много и их хочется хранить в репозитории по файлу на агента. Как устроены такие файлы, какие поля в них больше не работают и какую модель дать каждому агенту, я подробно разобрал в инструкции по субагентам Codex.
Модели из февральских примеров больше не годятся. GPT-5.3-Codex-Spark OpenAI сняли с Codex 14 сентября 2026 года, а gpt-5.3-codex помечена как устаревшая для входа через аккаунт ChatGPT. Замена для быстрых агентов теперь GPT-6 Luna, для сложных GPT-6.1 Sol. Про самую мощную модель линейки читай в обзоре GPT-6 Astra.
Как агенты Codex нашли и исправили три бага
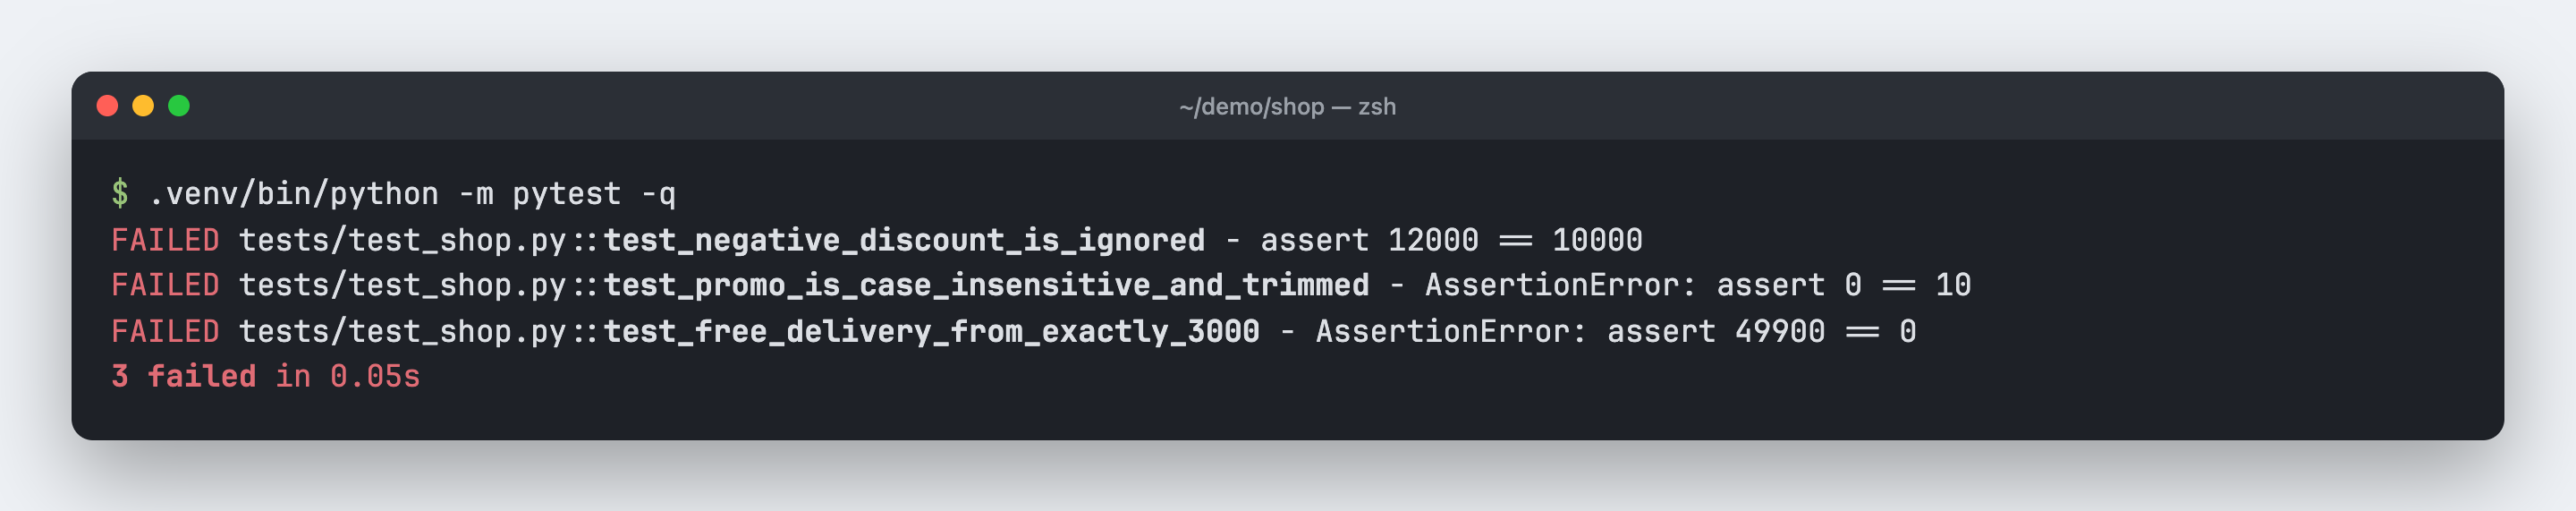
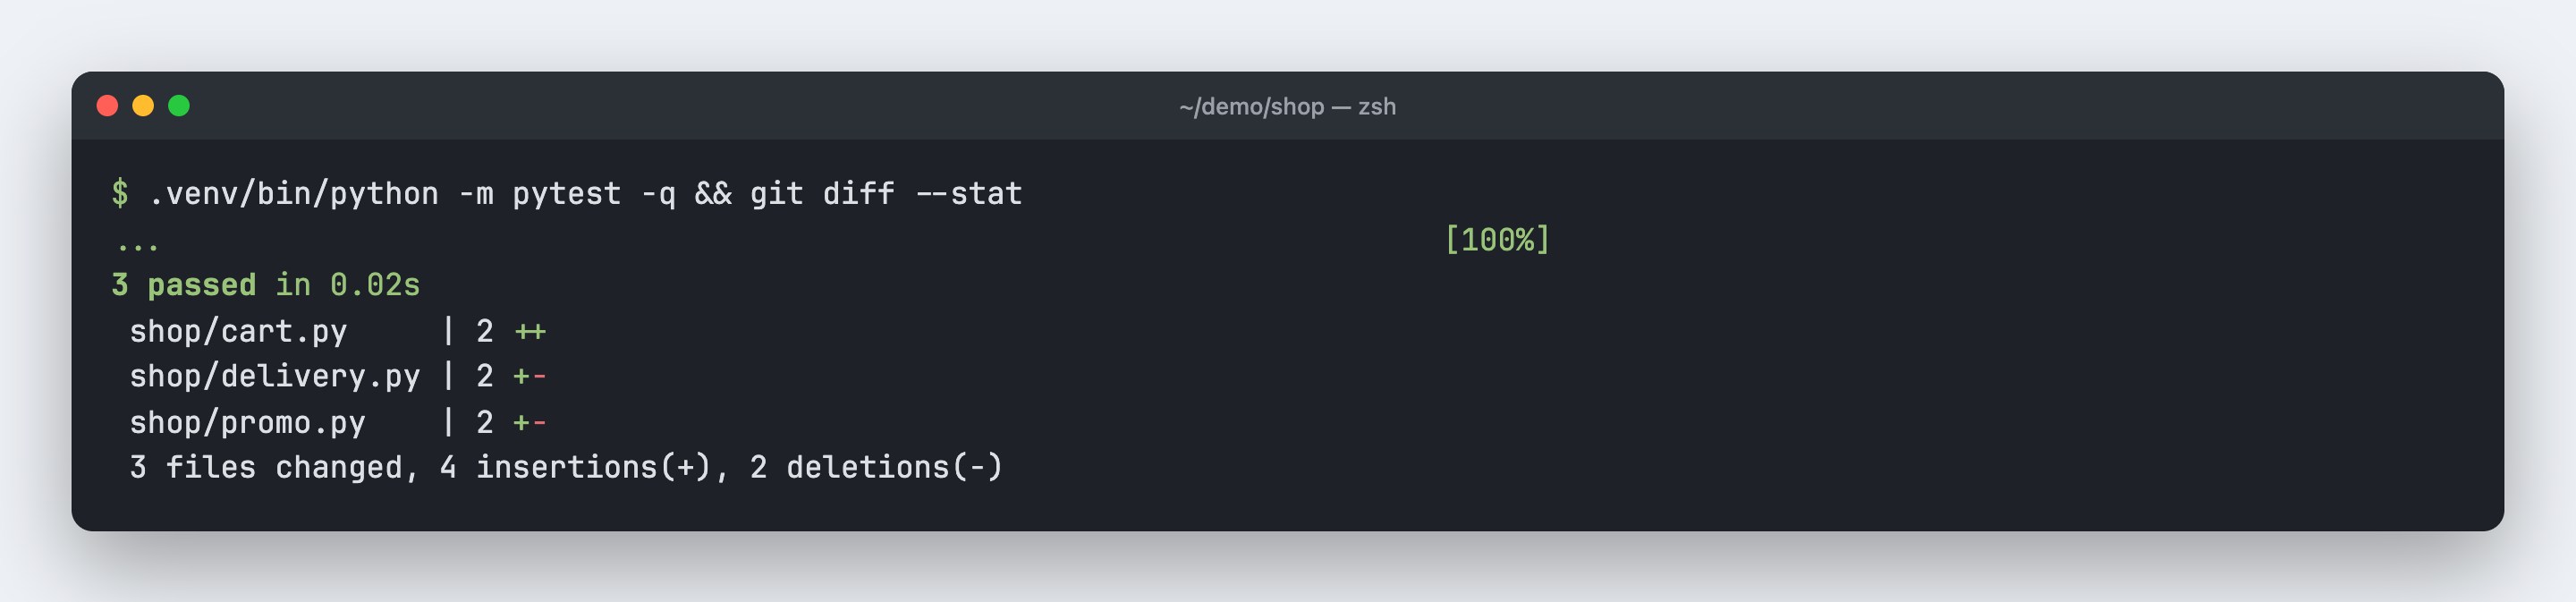
Демо-проект маленький: корзина интернет-магазина из четырёх модулей на Python. В три из них я специально заложил баги на границах значений: отрицательная скидка увеличивает сумму, промокод с пробелами не распознаётся, бесплатная доставка не включается ровно от 3000 рублей. Тесты это видят.
Дальше один промпт с явной схемой делегирования. Хороший промпт для мультиагентов говорит три вещи: как поделить работу, ждать ли всех агентов и в каком виде вернуть итог.
Codex запустил трёх исследователей, дождался их, пересказал находки и отдал правку исполнителю. Главный агент при этом сам подключил мой скилл с правилами Карпатого о минимальных правках, такой набор я разбирал в статье про Karpathy skills.
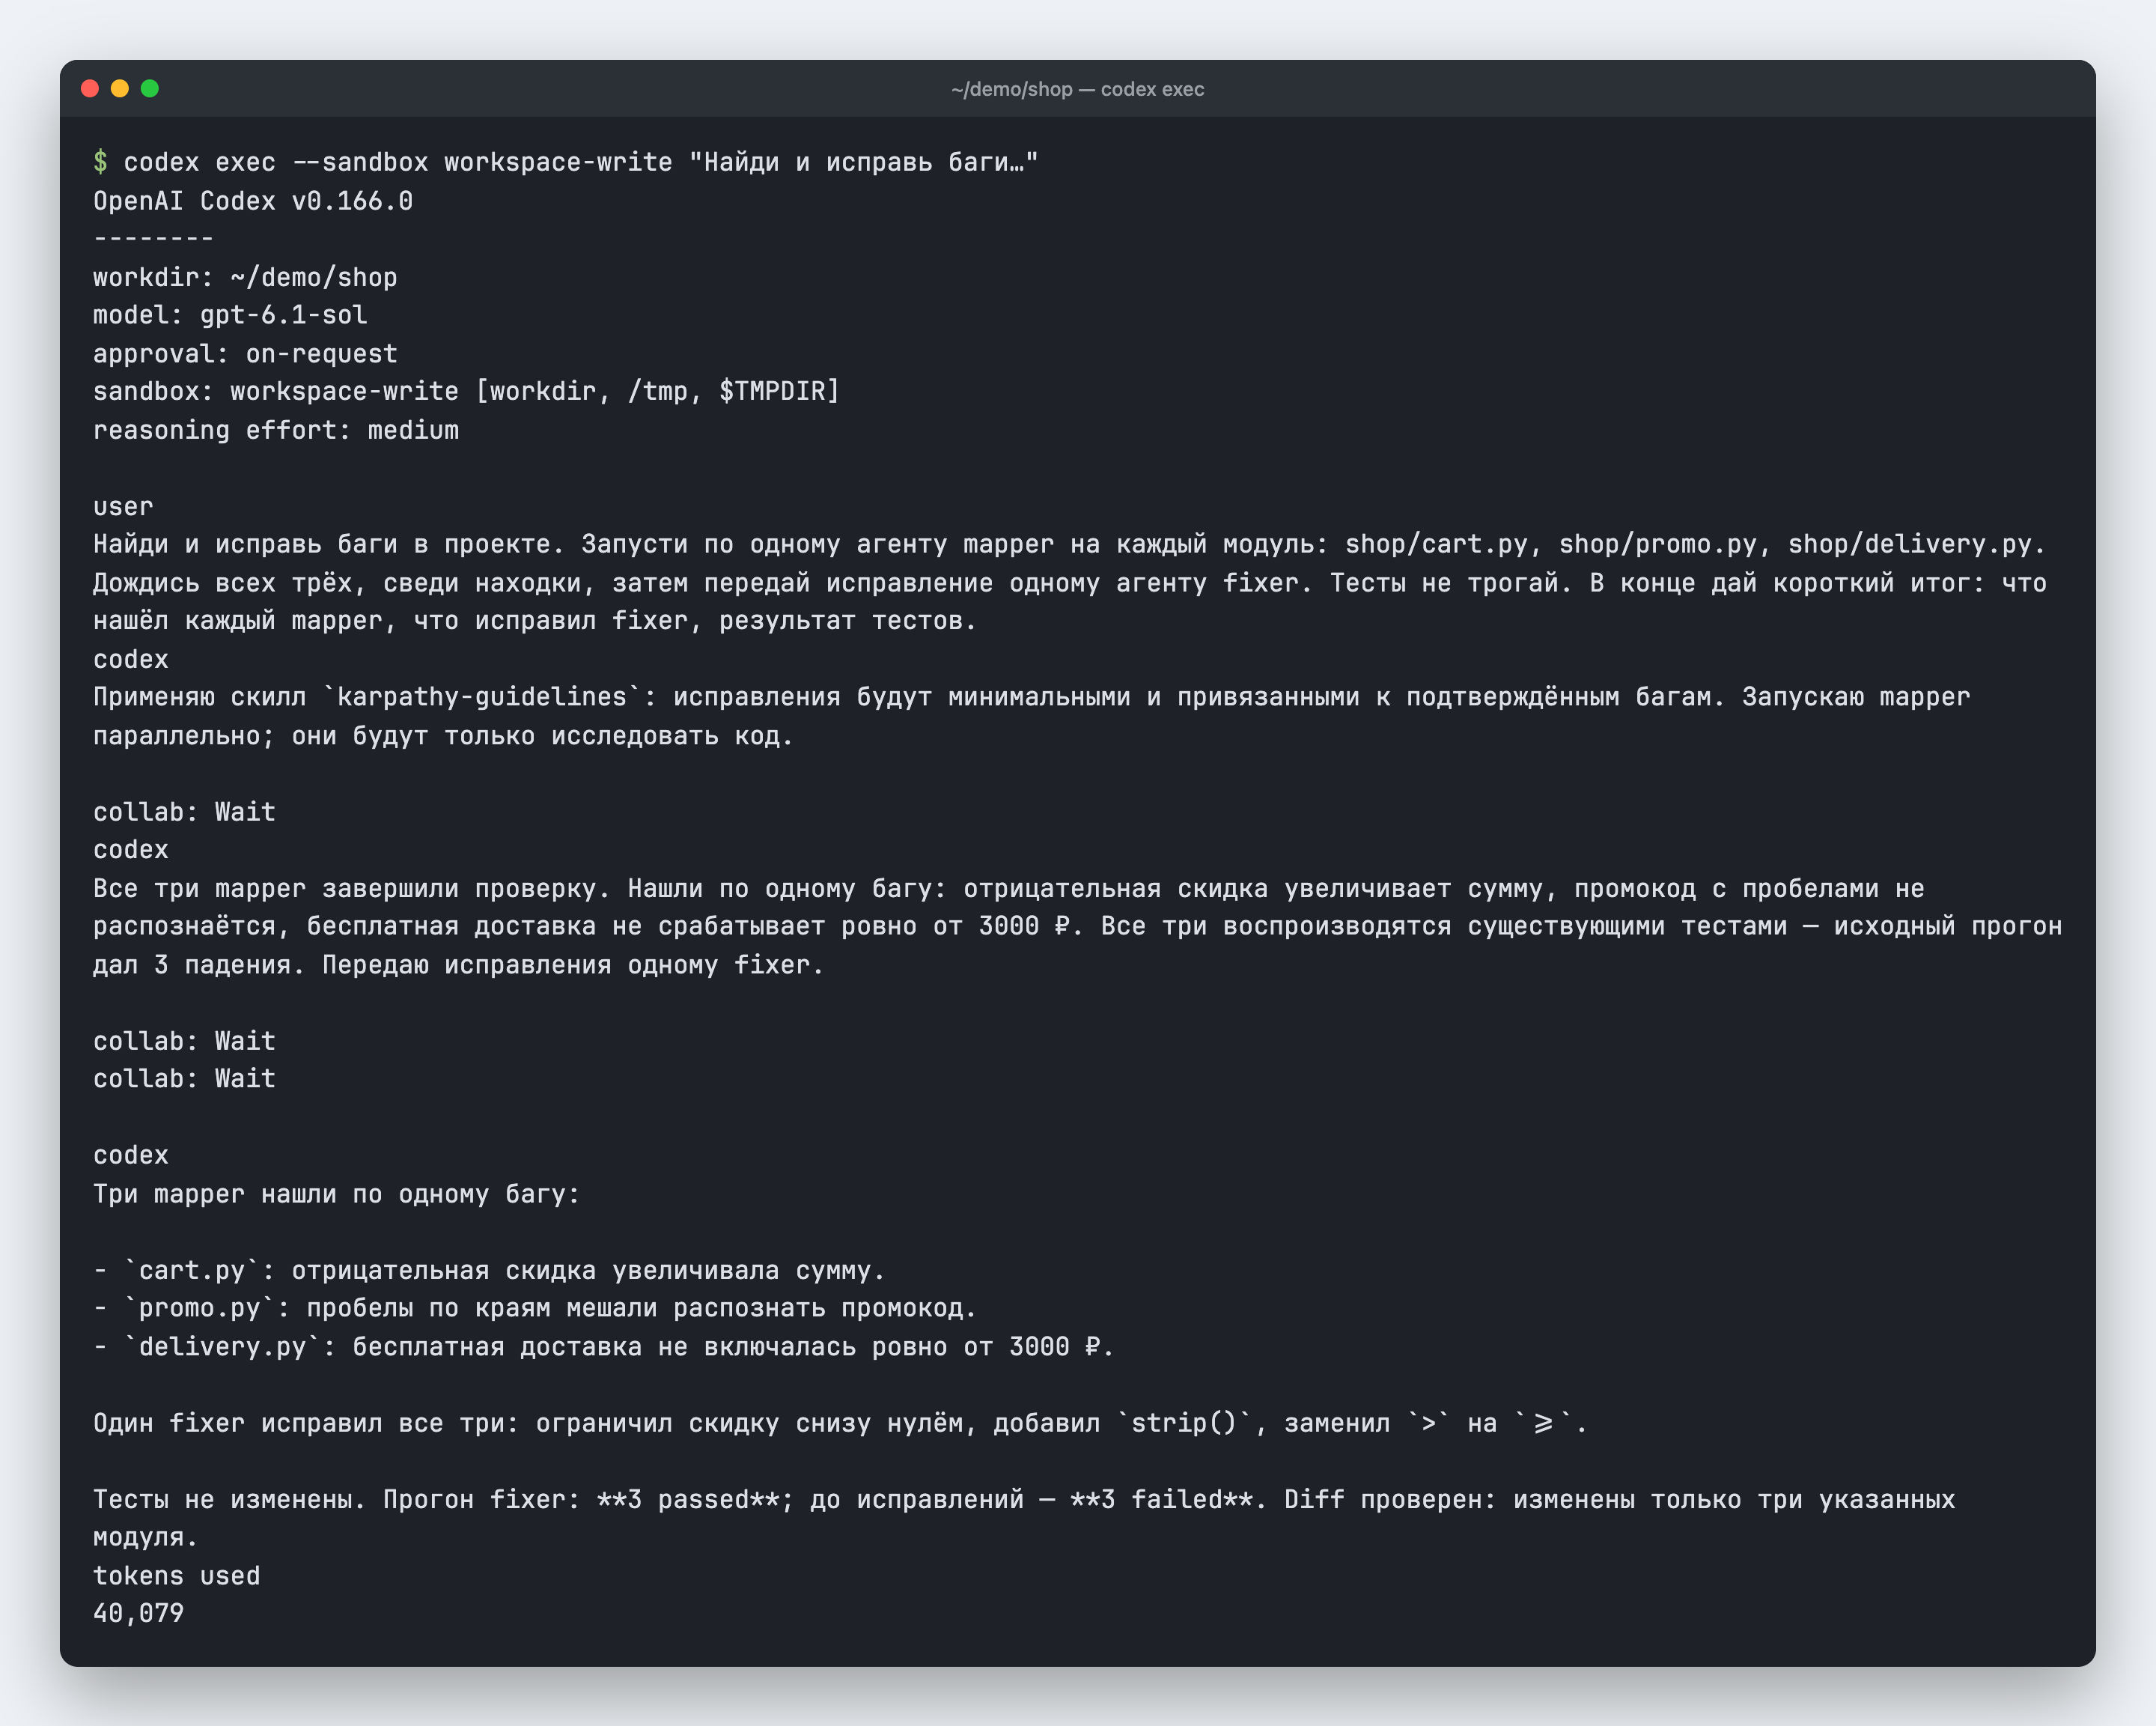
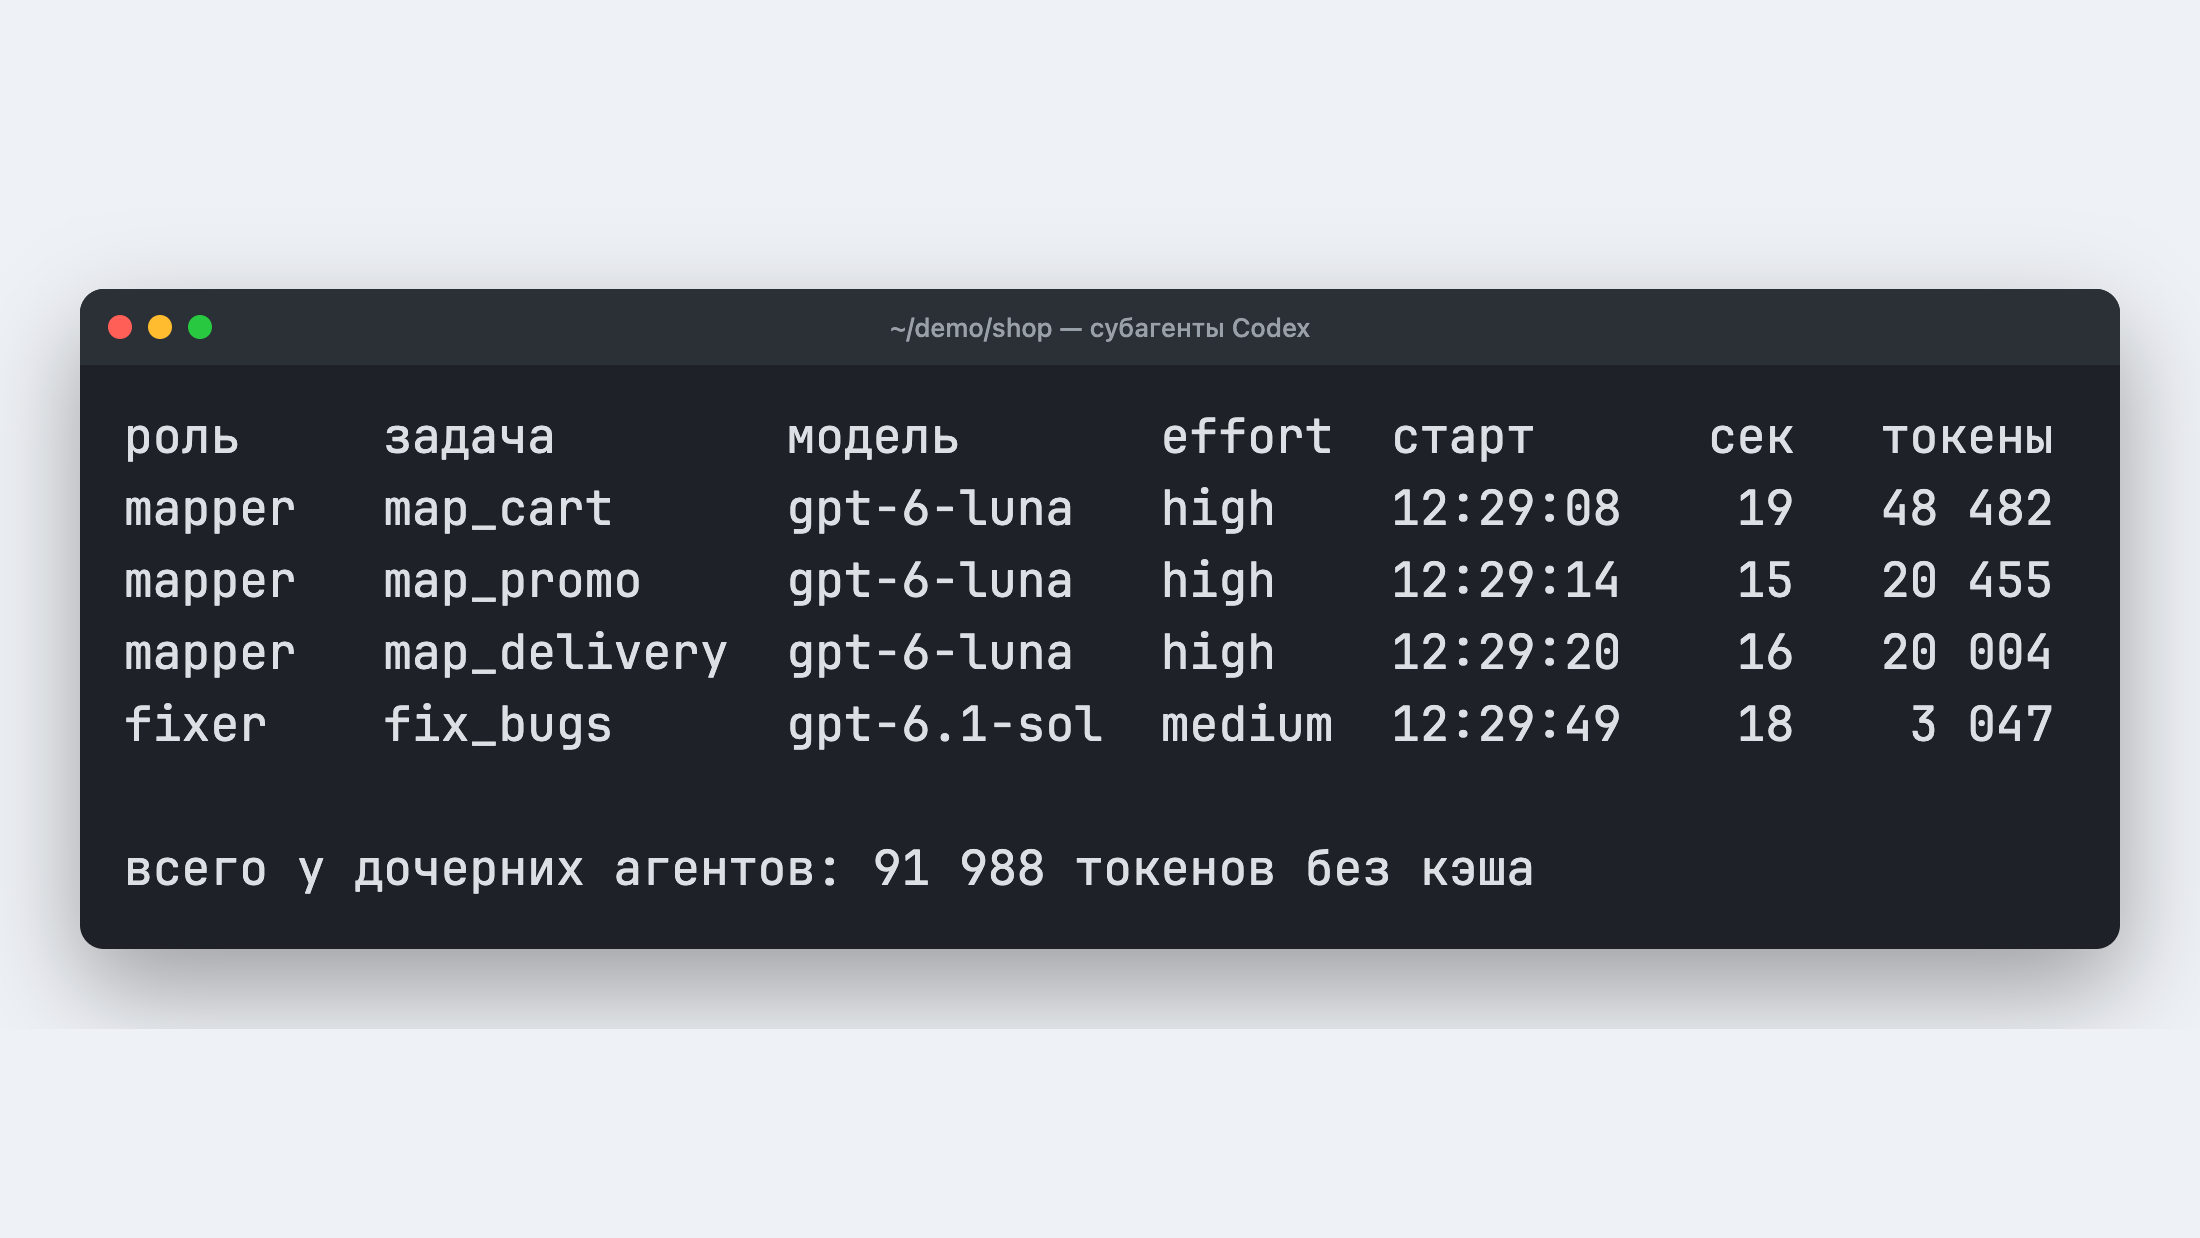
В самом выводе codex exec не видно, какие роли и модели получили агенты. Это видно в журнале сессии. Я написал короткий скрипт, который разбирает журналы из ~/.codex/sessions и собирает таблицу по дочерним агентам.
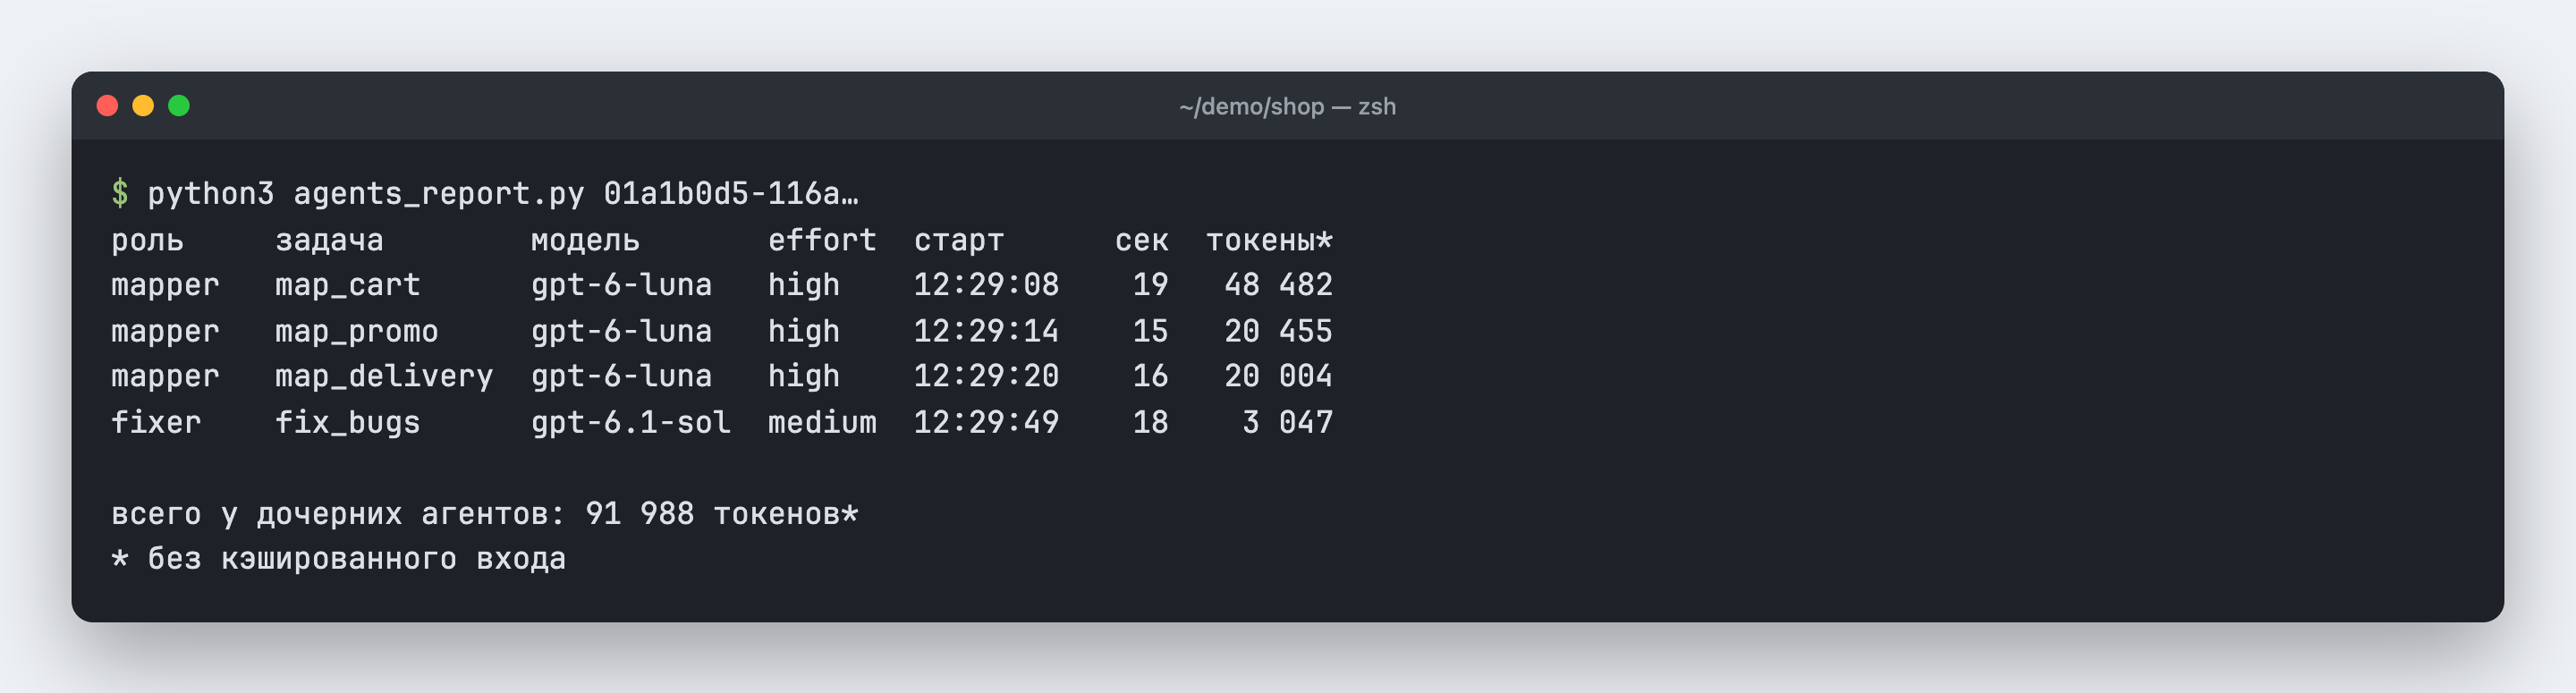
Три исследователя стартовали с разницей в шесть секунд и работали параллельно, каждый от 15 до 19 секунд. Исполнитель уложился в 18 секунд и потратил всего 3 тысячи токенов без кэша: вся разведка уже была сделана за него. Итоговый дифф вышел аккуратным, по одной-две строки на модуль.
Когда мультиагенты быстрее одного агента
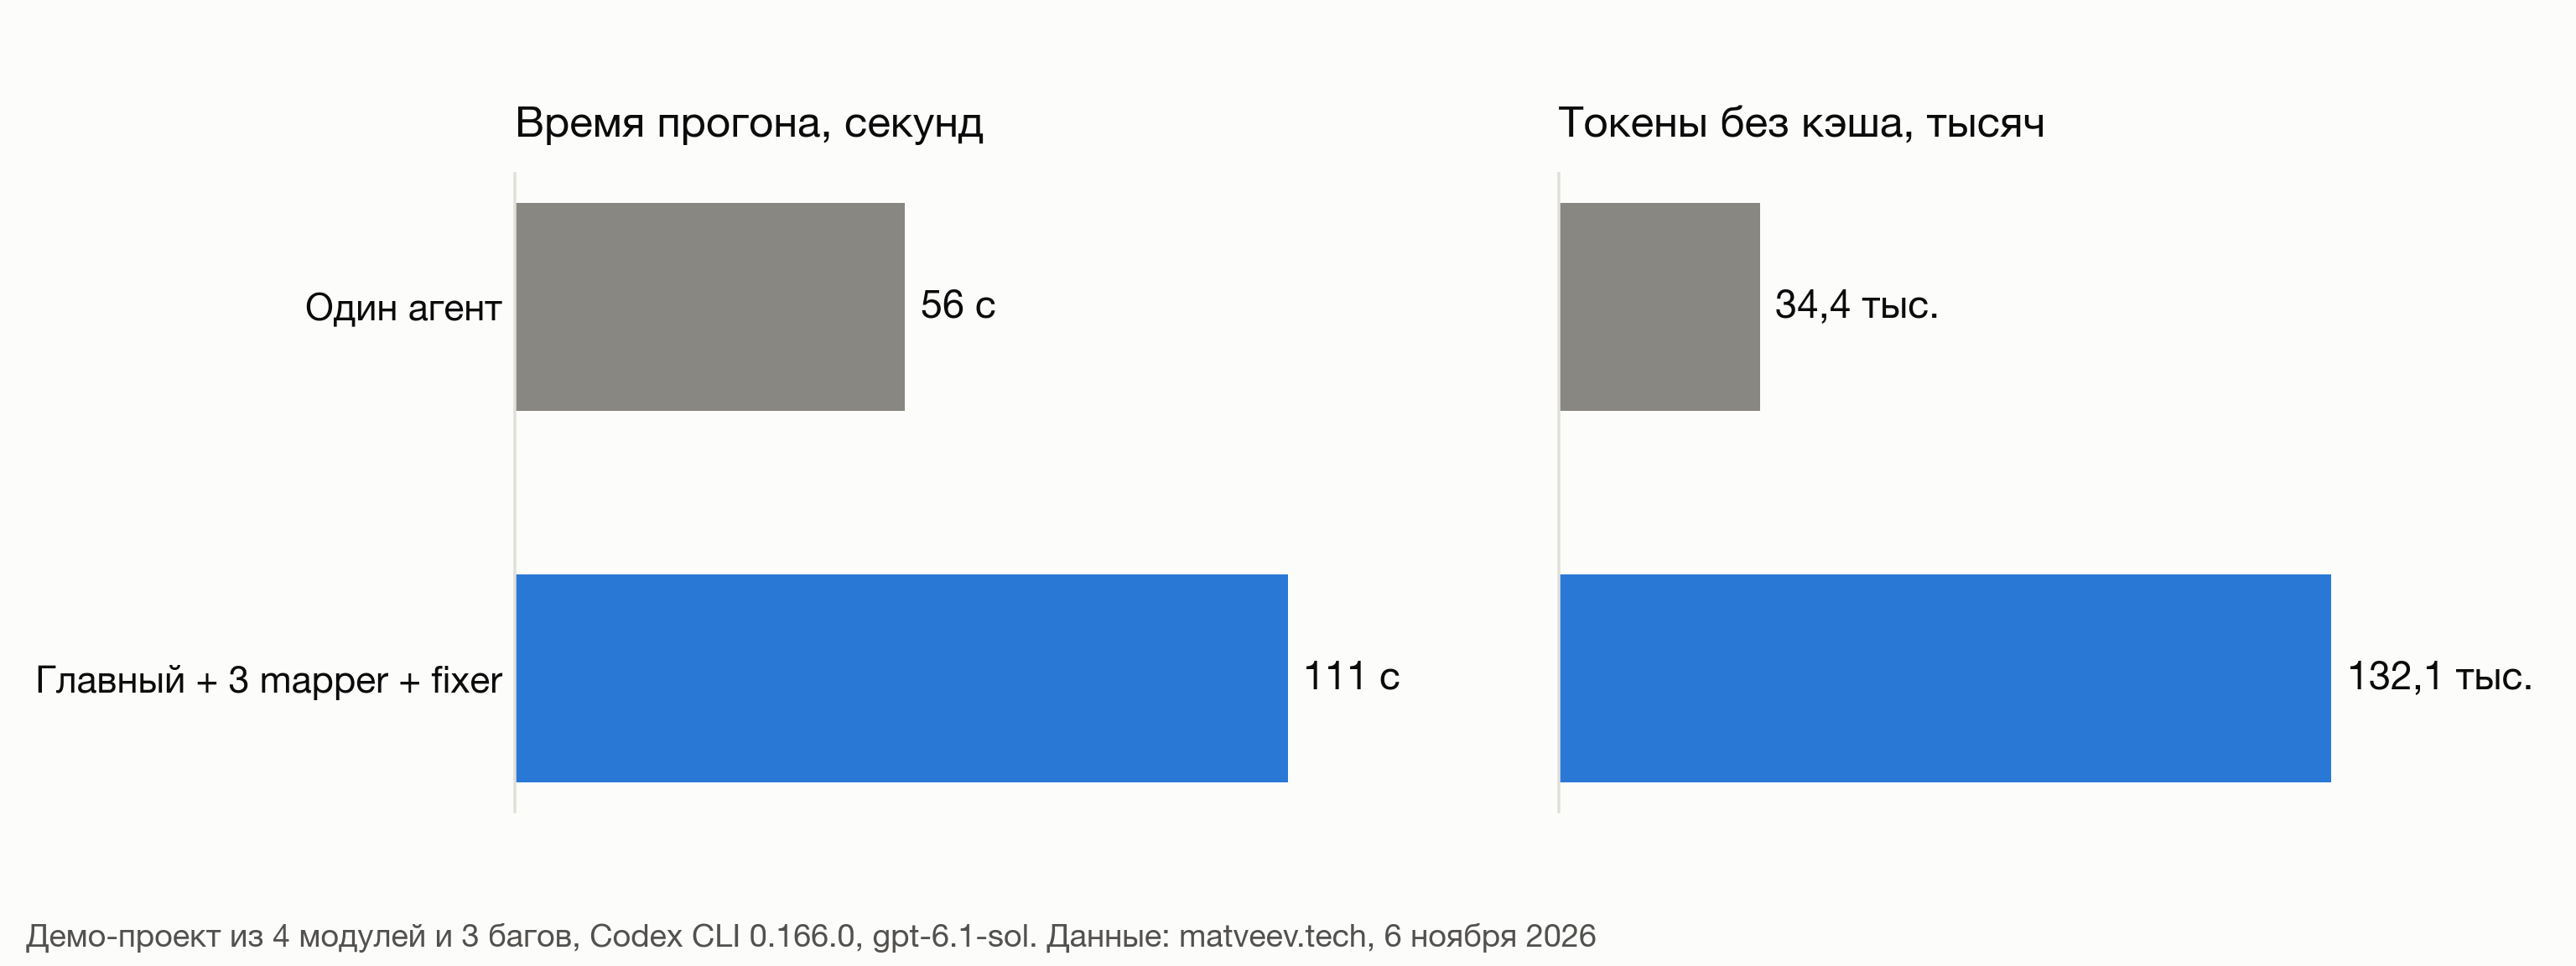
Ту же задачу я дал одному агенту с agents.enabled=false на копии проекта. Он нашёл и исправил те же три бага сам, вдвое быстрее и с почти вчетверо меньшим расходом токенов. Я ждал, что параллельные агенты хотя бы не проиграют по времени, и ошибся.
| Прогон | Время | Токены без кэша |
|---|---|---|
| Один агент | 56 секунд | 34,4 тыс. |
| Главный агент, 3 mapper, fixer | 111 секунд | 132,1 тыс. (40,1 у главного, 92 у дочерних) |
Причина простая. Каждый дочерний агент заново читает проект и инструкции, а главный тратит время на запуск, ожидание и сводку. Когда весь проект помещается в один контекст, этот накладной расход ничем не окупается. В февральской версии статьи я писал, что ревью шестью агентами вышло примерно втрое быстрее последовательных промптов. Это правда для большого PR, где каждый агент читает свой кусок на десятки файлов. На маленьком проекте выходит наоборот.
Моё правило теперь такое: мультиагентов стоит звать, когда частей задачи три и больше, каждая требует чтения своего большого куска кода или логов, и части не зависят друг от друга. Например, ревью большого PR по пунктам или разбор логов нескольких сервисов. Для правки трёх строк хватит одного агента. OpenAI в документации тоже советуют начинать с задач на чтение: исследование, тесты, разбор логов. С параллельной записью кода осторожнее, агенты могут править одни и те же файлы и конфликтовать.
Как заставить Codex делегировать без просьбы: AGENTS.md, скиллы и Ultra
Локальный Codex сам по себе агентов не запускает. По документации OpenAI, он делегирует в трёх случаях: ты прямо попросил в промпте, этого требует AGENTS.md проекта или этого требует подключённый скилл.
Вариант с AGENTS.md удобен для повторяющихся задач. Я добавил в демо-проект правило: на вопросы об устройстве проекта отвечать через субагентов, по одному на модуль. Сам вопрос про агентов ничего не говорил.
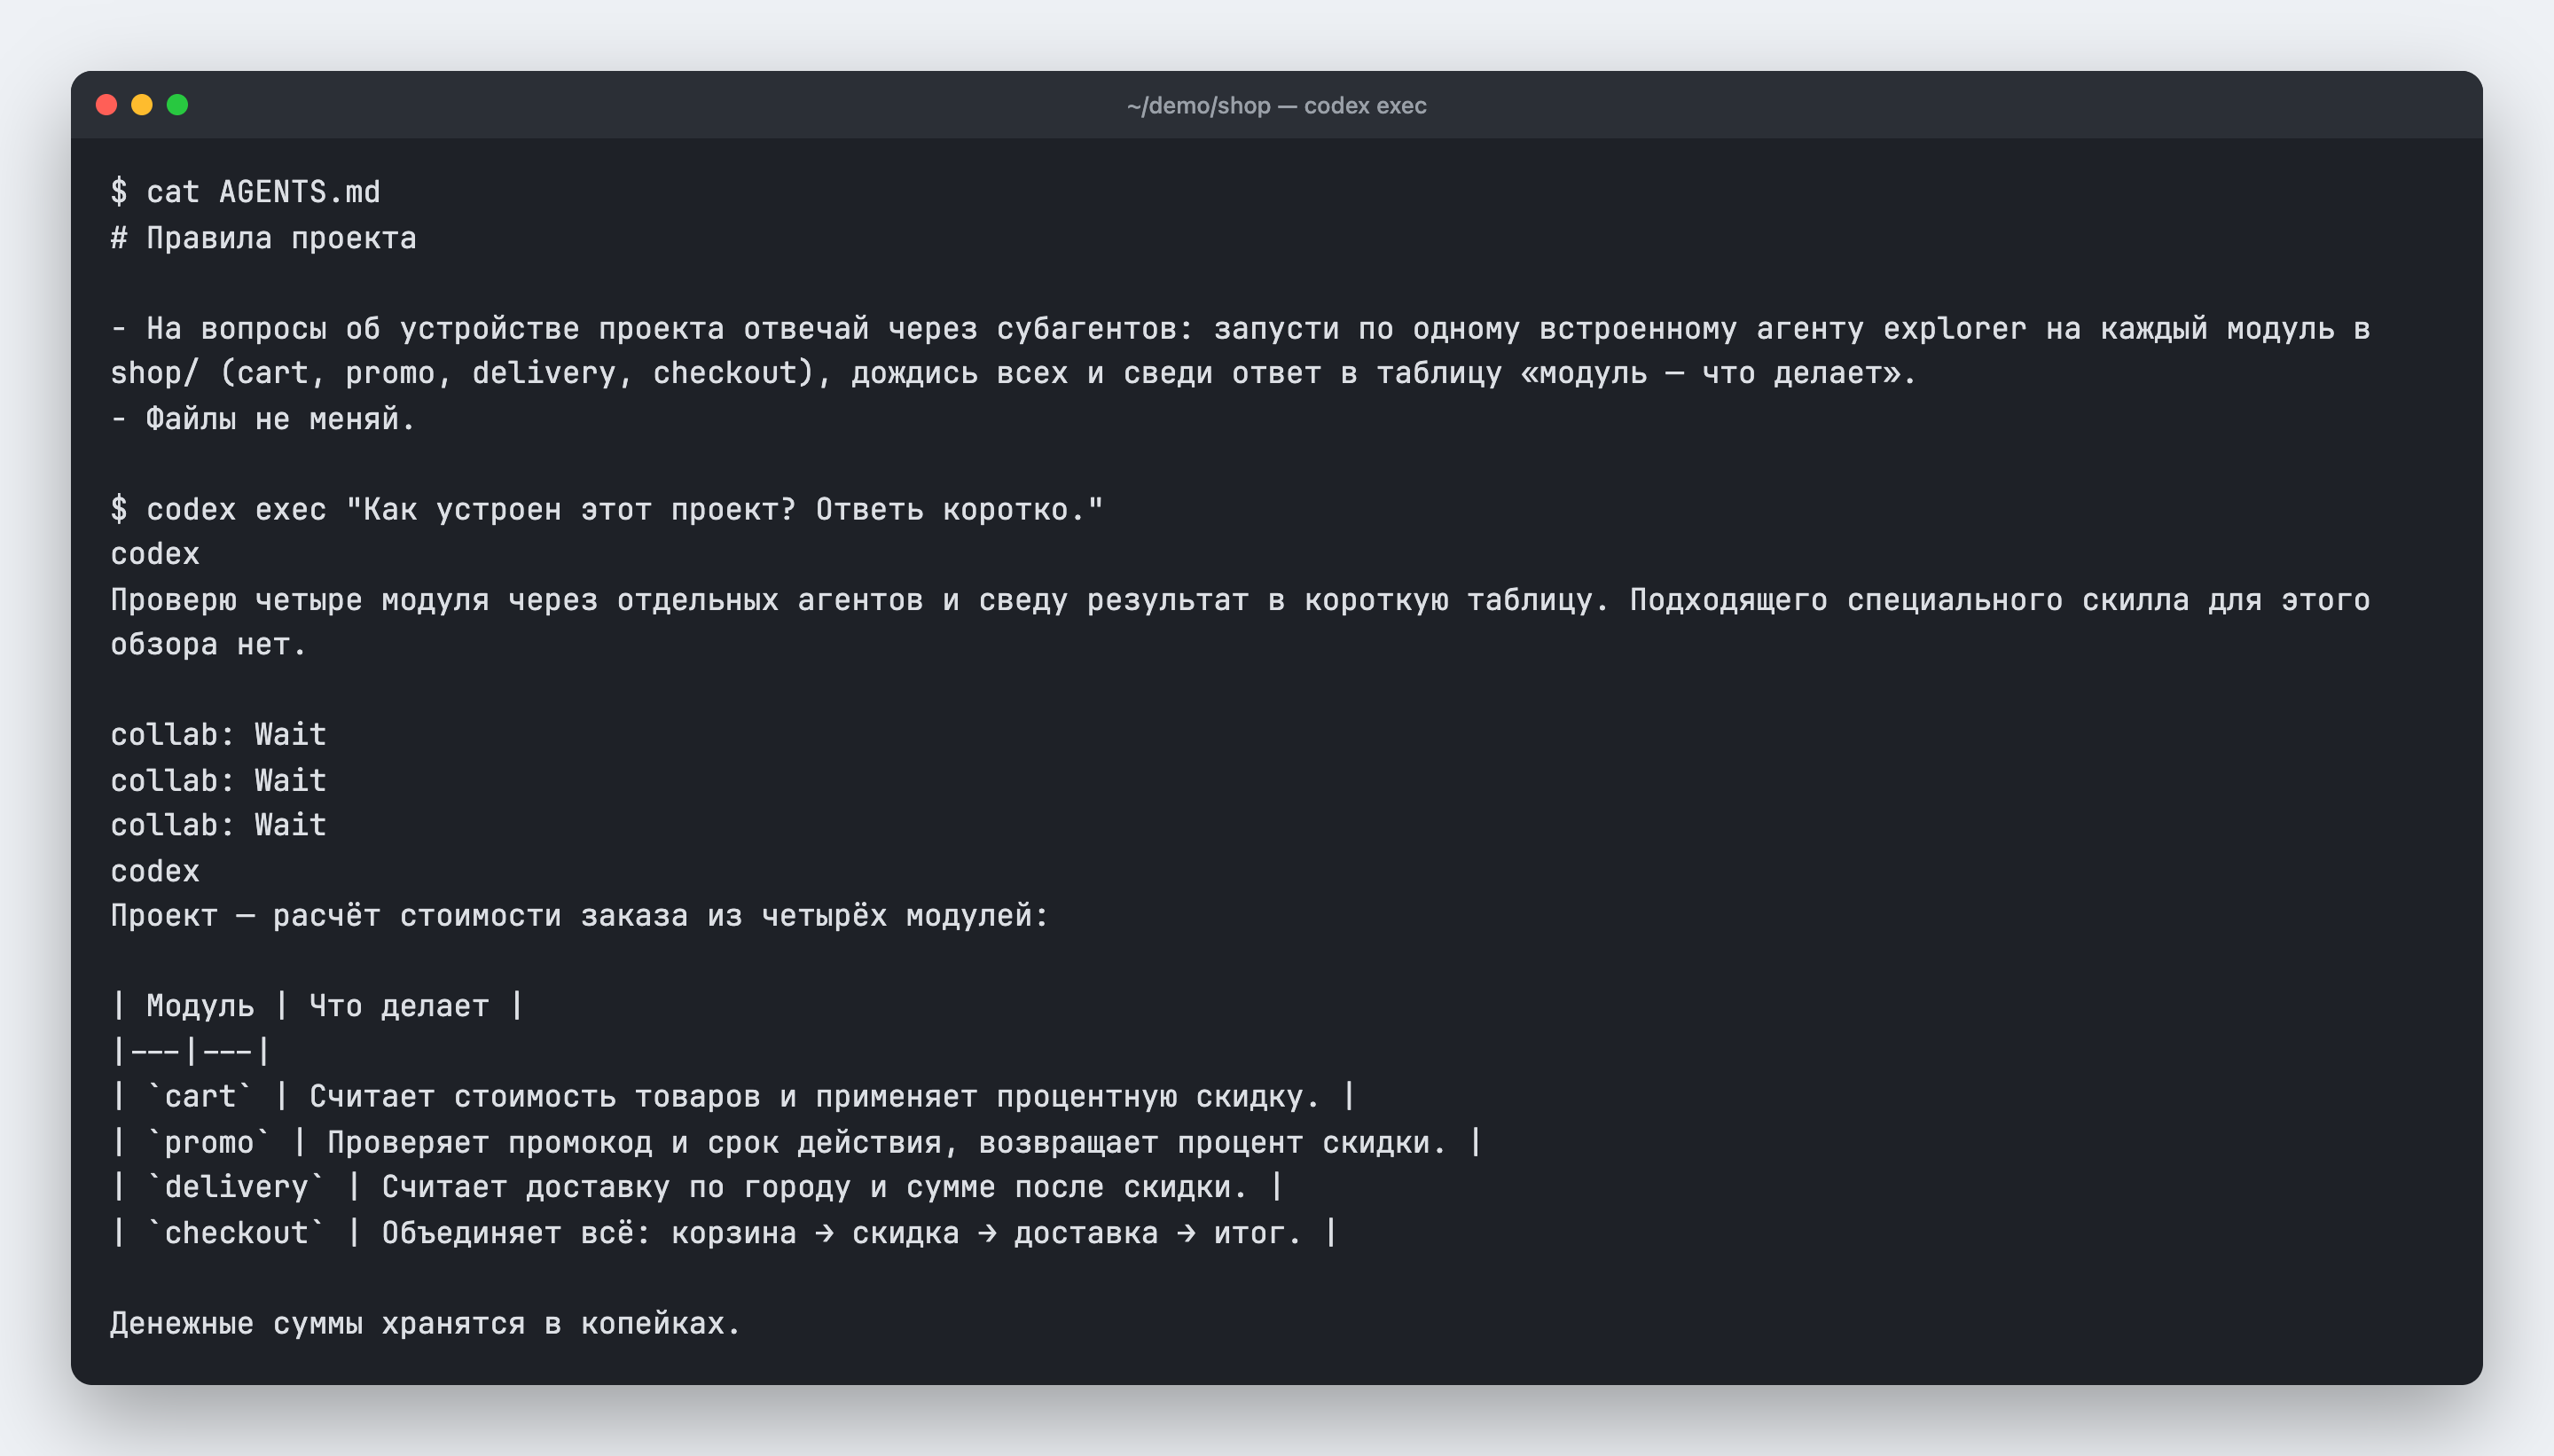
Codex запустил четыре агента и свёл ответ в таблицу. Одна деталь: в правиле я просил встроенный explorer, а в журнале сессии тип агента не указан, то есть Codex взял агента по умолчанию. Если тебе важна конкретная роль, пиши её имя в промпте явно, как в демо с багами.
Третий путь это режим Ultra. Это высший уровень рассуждений, на котором модель сама решает, какую работу разнести по агентам. Страница моделей советует выбирать его, когда задачу можно разделить на осмысленные части, и честно предупреждает, что большинству задач ни Max, ни Ultra не нужны.
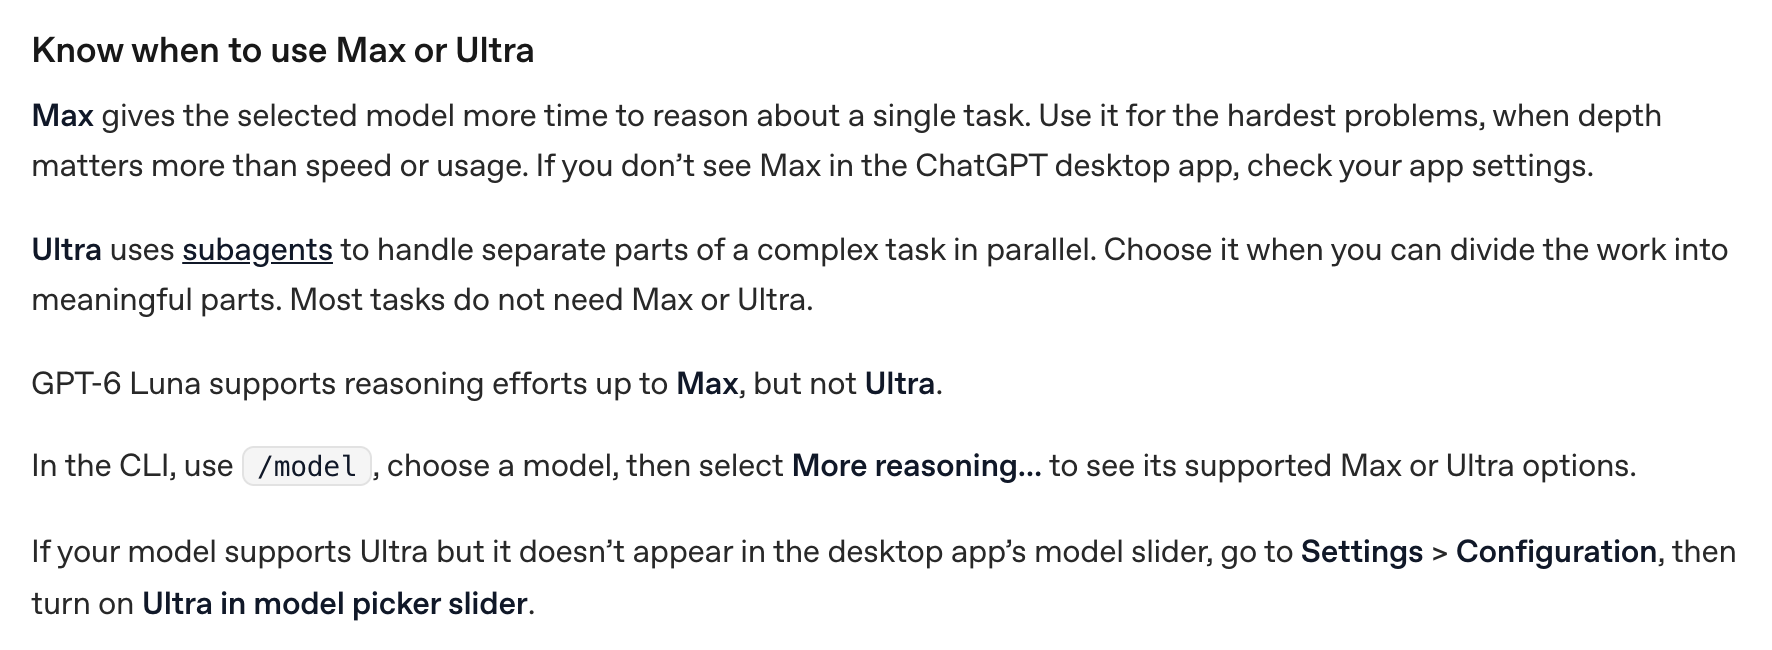
В CLI Ultra включают так: /model, выбрать модель, затем пункт More reasoning. GPT-6 Luna поддерживает уровни только до Max. В веб-версии ChatGPT Work мультиагенты тоже есть, но там своих ролей не опишешь: агенты работают в облаке OpenAI, а на большинстве уровней их нужно просить явно.
Как управлять запущенными агентами
Пока агенты работают, их можно смотреть и направлять:
/subagentsв CLI открывает список потоков, в любой можно перейти и посмотреть, что агент делает. Старой команды/agentбольше нет, а/agentsтеперь открывает центр управления чатами, это другое;- остановить агента, перенаправить его или закрыть готовые потоки можно обычной просьбой в чате;
- в приложении и IDE то же самое показывает панель над полем ввода, а в IDE оттуда можно остановить всех агентов сразу.
С подтверждениями есть нюанс. Дочерние агенты наследуют песочницу и политику подтверждений главного, включая смену через /permissions или --yolo. Если агенту в фоновом потоке нужно твоё разрешение, CLI покажет запрос поверх главного потока с меткой источника. Клавиша o открывает этот поток, чтобы посмотреть контекст перед ответом.
В неинтерактивном режиме (codex exec, CI) спросить некого. Действие, которому нужно новое разрешение, падает, и ошибка возвращается главному агенту. Поэтому права для пакетных прогонов задают заранее: --sandbox workspace-write, как в моём демо. Старый флаг --full-auto больше не поддерживается.
В журнале моей сессии видно, как главный агент ждёт: он трижды вызывал wait_agent с таймаутом 10 секунд. Исследователи работали одновременно, поэтому их этап занял 28 секунд. По очереди они потратили бы 50.
Похожая схема есть и у Claude Code, там она называется Agent Teams. Чем она отличается, я показал в инструкции по Agent Teams.
Какие ошибки ломают работу агентов
Роль пытается ограничить песочницу. В феврале я советовал дать explorer строку sandbox_mode = "read-only". Теперь это не работает: sandbox_mode, approval_policy, model_provider и mcp_servers в файле агента игнорируются, агент берёт их у главного. Инструкция «файлы не меняй» просит агента не править код, но отдельной песочницы не создаёт. Если нужна защита от записи, запускай главного агента в read-only.
Роль не подхватывается. Проверь путь: config_file считается от того config.toml, где объявлена роль. Роль из ~/.codex/config.toml с путём agents/mapper.toml ищет файл в ~/.codex/agents/mapper.toml. Проектные роли работают только в доверенном проекте.
В конфиге осталась снятая модель. Роль с gpt-5.3-codex-spark или gpt-5.4 при входе через ChatGPT упадёт: эти модели сняты с Codex. Поменяй их на gpt-6-luna и gpt-6.1-sol.
Агенты зря делят мелкую задачу. Как показал мой замер, на маленьком проекте делегирование вышло вдвое медленнее и почти вчетверо дороже по токенам. Если весь код влезает в один контекст, проси одного агента.
Агенты пишут в одни файлы. Параллельная запись приводит к конфликтам. Схема «несколько исследователей читают, один исполнитель пишет» из демо надёжнее, чем три исполнителя одновременно.
Пакетный прогон падает на подтверждении. В codex exec агенту некого спросить. Задай нужный режим песочницы при запуске и не рассчитывай на интерактивные разрешения.
Стоит ли звать мультиагентов Codex: мой вердикт
Выключать режим незачем: локальный Codex сам агентов не запускает, они появляются только по просьбе, правилу в AGENTS.md или скиллу. Поэтому вопрос сводится к тому, когда их звать. Мой ответ: на ревью большого PR и разборе логов нескольких сервисов, где каждая часть читает свой большой кусок. На проекте, который целиком влезает в один контекст, команда проиграет одному агенту, как моя корзина проиграла вдвое по времени.
Если роли всё-таки заводить, то две, как в демо: исследователя на GPT-6 Luna, который только читает, и исполнителя на GPT-6.1 Sol, который пишет. Защиты от записи это не даёт, её держит только песочница главного агента. Зато пишет один агент, и конфликтов в общих файлах нет.
Больше гайдов по Codex, Cursor и другим агентам для кода собрано в разделе о вайб-кодинге.
Читайте также
- Лучшие AI-агенты для кода в 2026 году: где Codex стоит среди Claude Code, Cursor и других агентов.
- Cursor 2.5: плагины, песочница и субагенты: как устроены субагенты у прямого конкурента.
- 8 уровней агентного инжиниринга: на каком уровне мультиагенты начинают приносить пользу.
- Agent harness: что это и из чего состоит: обвязка вокруг модели, частью которой стала оркестрация агентов.