Субагенты в Codex: настраиваем AI-команду
Разбираю субагентов в Codex CLI 0.166: свои агенты в TOML, выбор между GPT-6.1 Sol и GPT-6 Luna и живой прогон ревью ветки тремя агентами.
· обновлено · 11 мин
Я дал Codex ветку с тремя заложенными багами и попросил проверить её двумя субагентами. Через 1 минуту 25 секунд пришёл итог, где были все три. Субагенты в Codex — это дочерние агенты, которым основной агент раздаёт независимые куски задачи: один читает код, другой ищет баги, третий пишет тесты. Работают они параллельно, каждый в своём потоке и со своим контекстом, а в главный чат возвращают только выжимку.
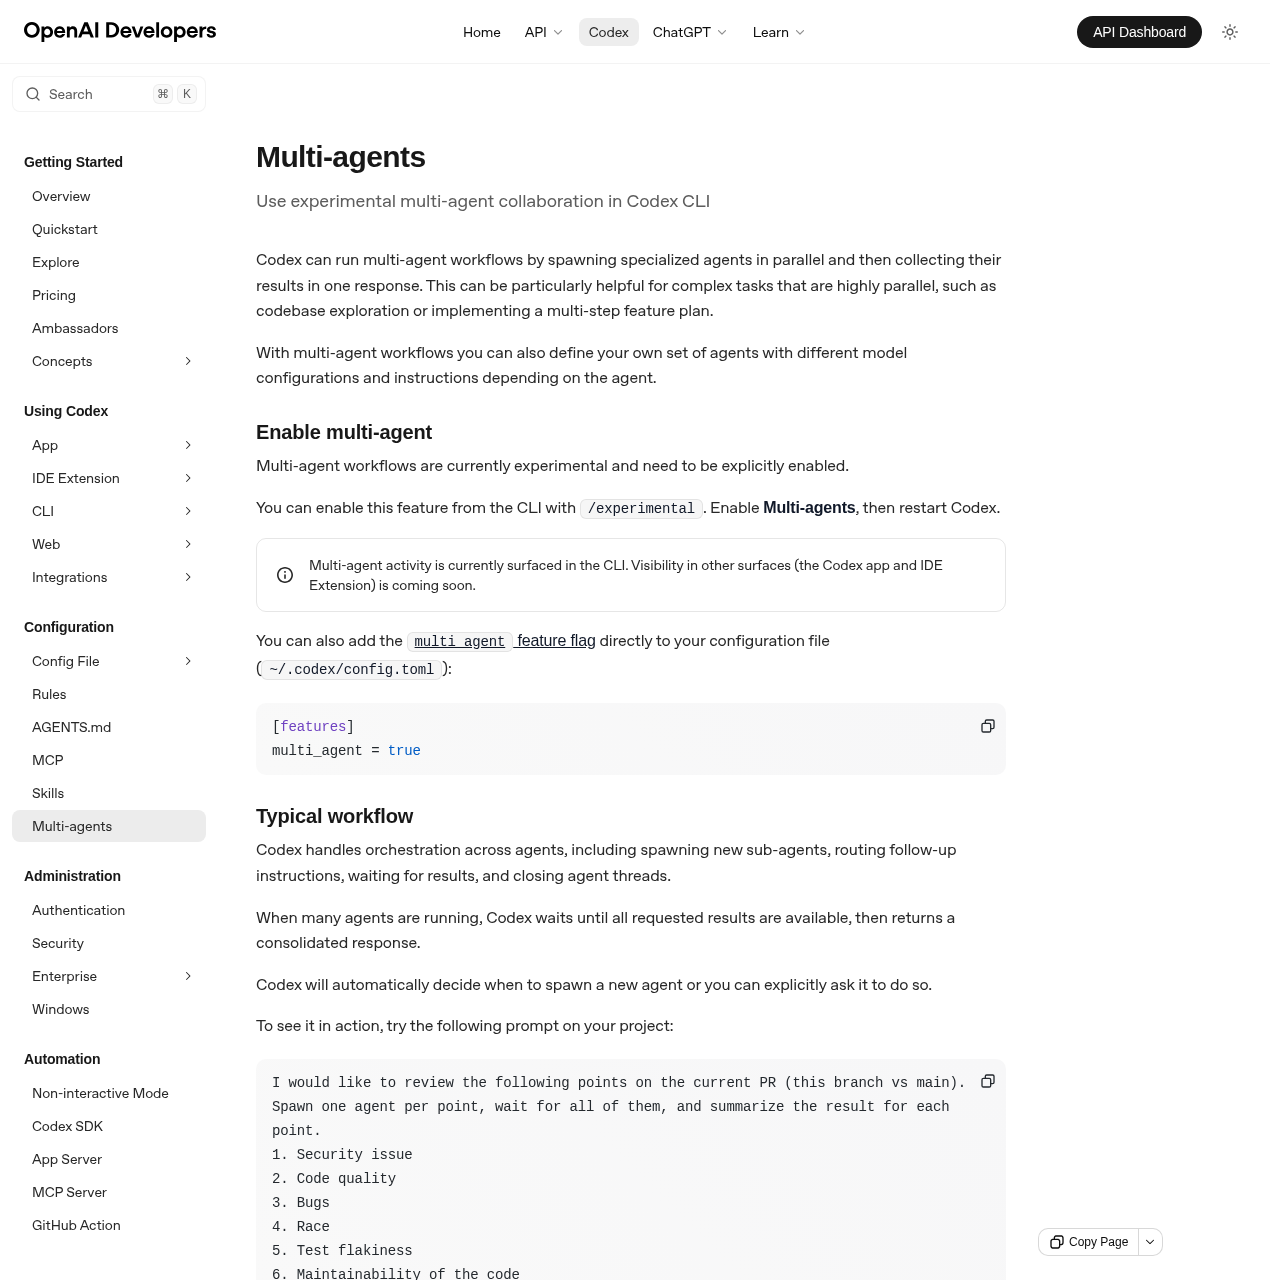
В свежих версиях Codex субагенты включены по умолчанию, своих агентов описывают TOML-файлами. Я пользуюсь субагентами с мартовского релиза, а до этого гонял мультиагентный режим Codex, пока он был экспериментальным.
За полгода изменилось почти всё вокруг субагентов. Модели, которые я советовал в первой версии этой статьи, OpenAI сняли с Codex. Команду /agent переименовали, а часть полей в файле агента перестала работать. Ниже инструкция на ноябрь 2026 года: проверил её на Codex CLI 0.166.0 и демо-проекте с тремя своими агентами.
В статье разберём:
- что такое субагенты в Codex и когда они нужны;
- как запустить встроенных агентов без настройки;
- как описать своих агентов в TOML;
- как агенты Codex разобрали ветку с тремя багами;
- какую модель дать каждому агенту и сколько это стоит;
- что изменилось с марта 2026 года;
- какие ошибки ломают работу субагентов.
Что такое субагенты в Codex и зачем они нужны
Субагент — это отдельный агент, которого Codex запускает под конкретную подзадачу. У него свой поток (agent thread), своя модель и свой контекст. Закончив работу, он отдаёт основному агенту короткий итог, а не сырые логи.
Зачем так усложнять? Даже у модели с контекстом в миллион токенов чат со временем зарастает мусором: стектрейсы, вывод тестов, заметки по ходу исследования. В документации OpenAI это называют context pollution (полезное тонет в шуме) и context rot (качество ответов падает по мере заполнения контекста). Про второе есть отдельное исследование Chroma. Субагенты уносят шумную работу из главного чата, и основной агент держит в голове только требования и решения.
Второй плюс в скорости. Пока один агент читает код, другой уже гоняет сценарии, и ждать их по очереди не нужно.
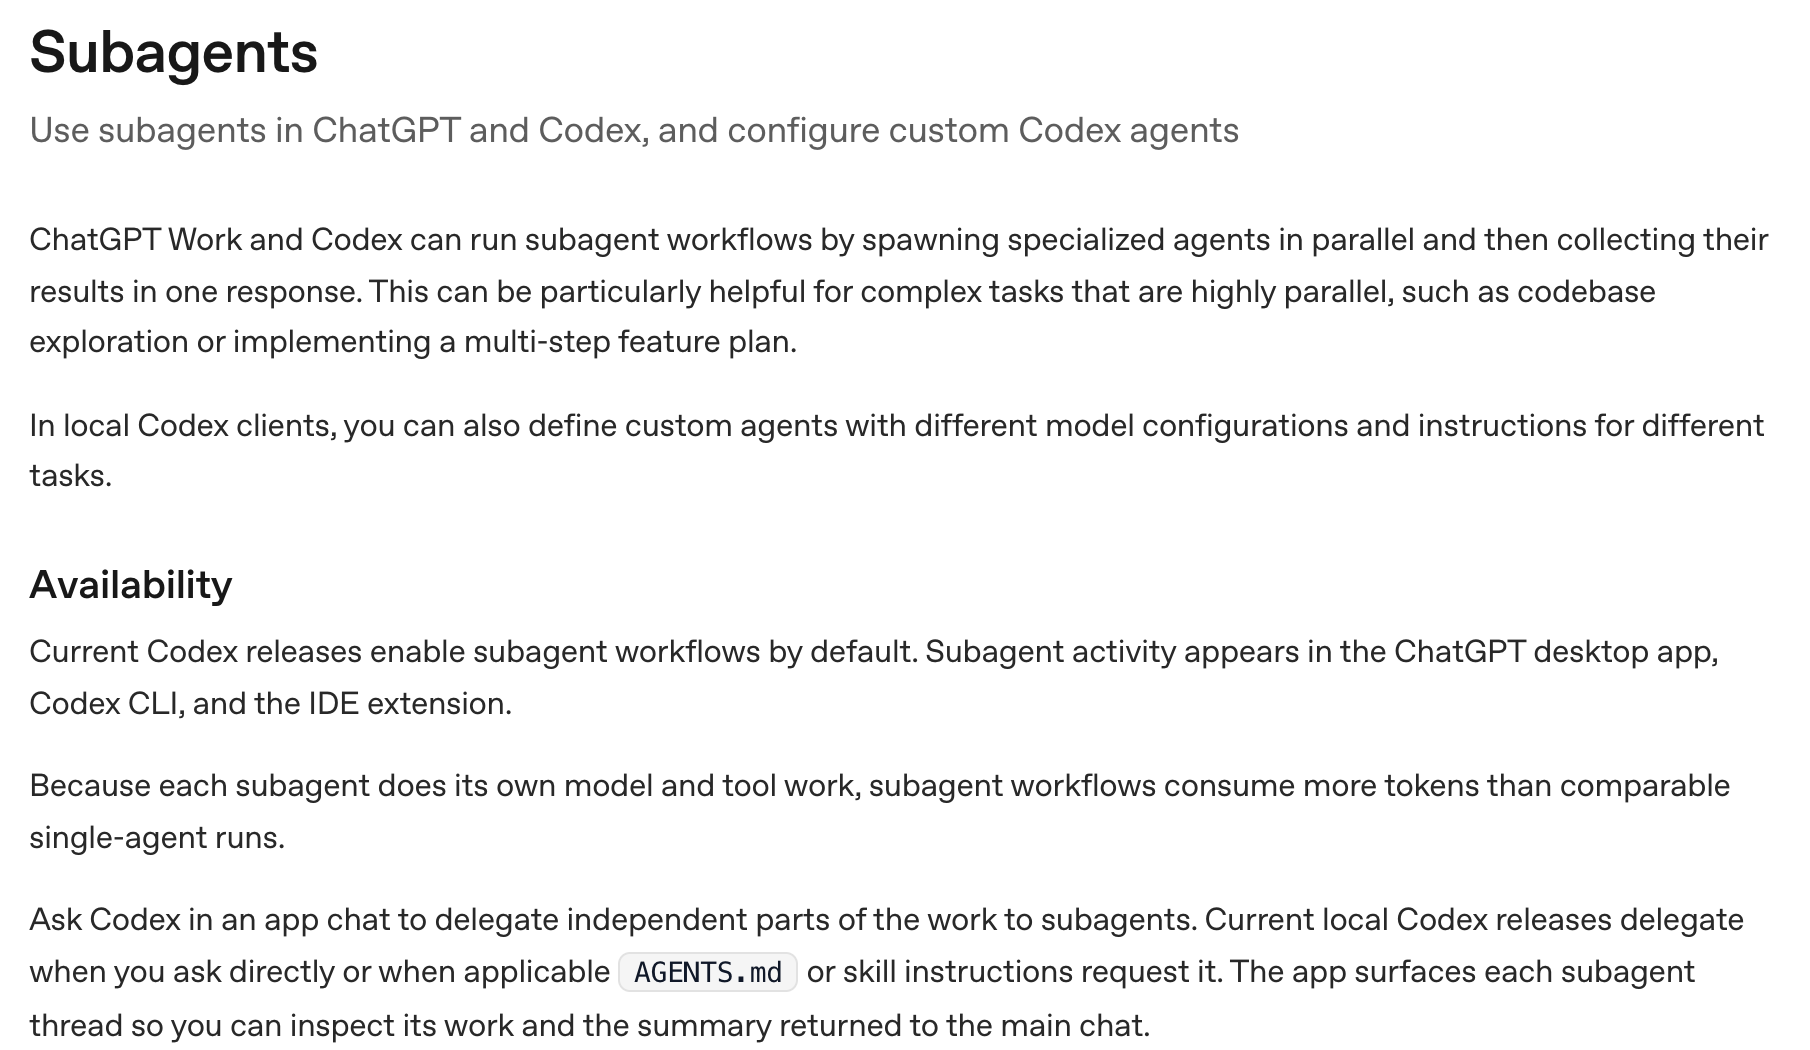
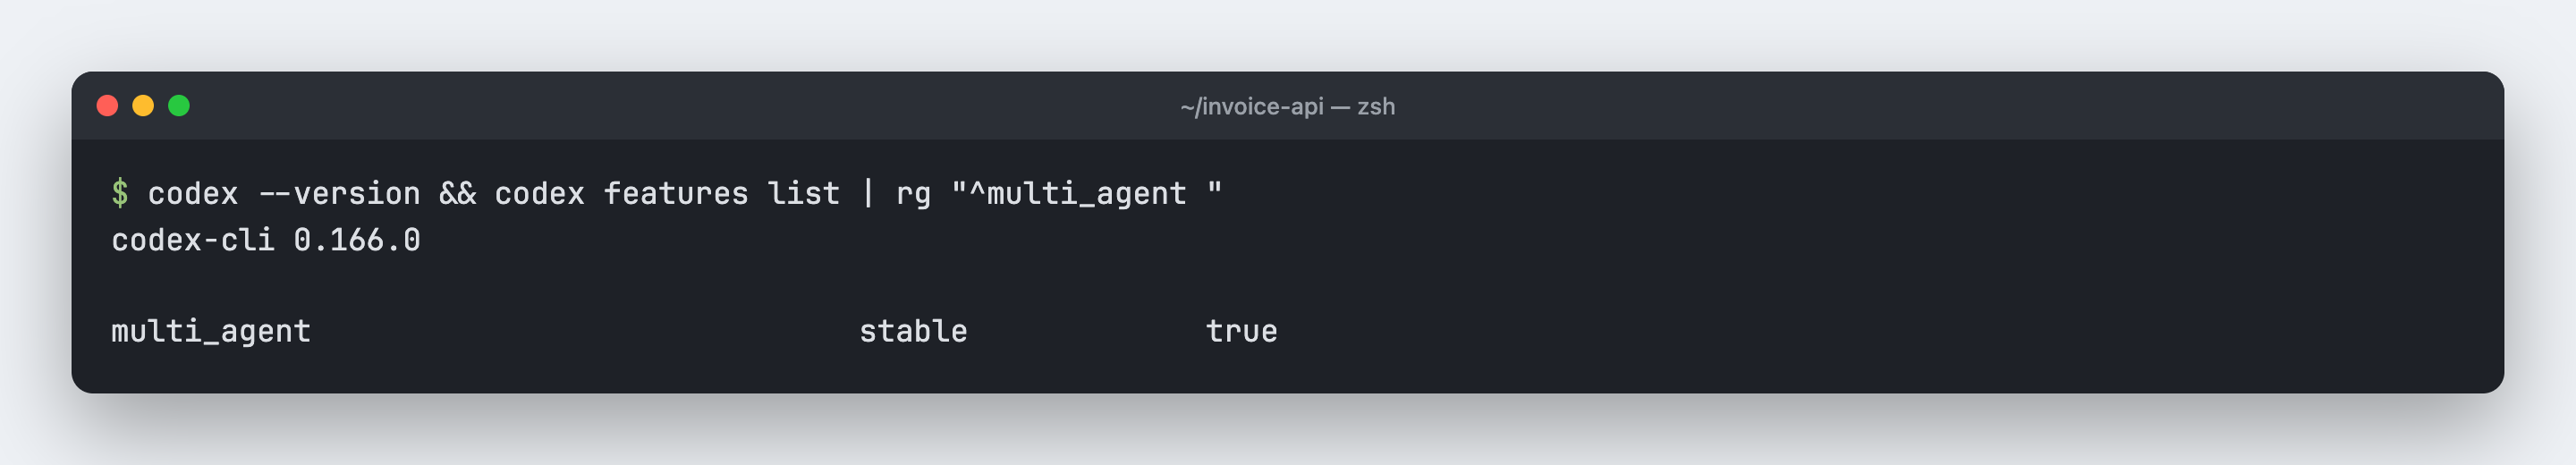
По документации OpenAI субагенты сейчас видны в трёх клиентах: в ChatGPT desktop app, в Codex CLI и в IDE-расширении. В веб-версии ChatGPT Work они тоже есть, но там своих агентов не опишешь, только попросишь распараллелить работу. Флаг в CLI проверяется одной командой.
Субагенты удобнее всего на задачах чтения: исследование кода, ревью, разбор логов, прогон тестов. С параллельной записью сложнее, об этом ниже. А когда хватает одного агента и цепочки шагов, я разбирал в статье про паттерны воркфлоу AI-агентов.
Как запустить встроенных агентов без настройки
В Codex есть три встроенных агента, и для первого запуска хватит их:
default— агент общего назначения, на него Codex откатывается по умолчанию;worker— исполнитель, правит код и чинит баги;explorer— читает и исследует кодовую базу.
Обычно Codex сам субагентов не запускает: нужна прямая просьба в промпте или инструкция в AGENTS.md либо в скилле. Хороший промпт объясняет, как поделить работу, ждать ли всех агентов и в каком виде вернуть итог. Вот пример, который я использую для ревью ветки:
Пока агенты работают, в CLI набери /subagents: откроется список потоков, и в любой можно провалиться, чтобы посмотреть, что агент делает. В приложении и IDE-расширении то же самое показывает панель над полем ввода. Остановить агента, перенаправить или закрыть готовые потоки можно обычной просьбой в чате.
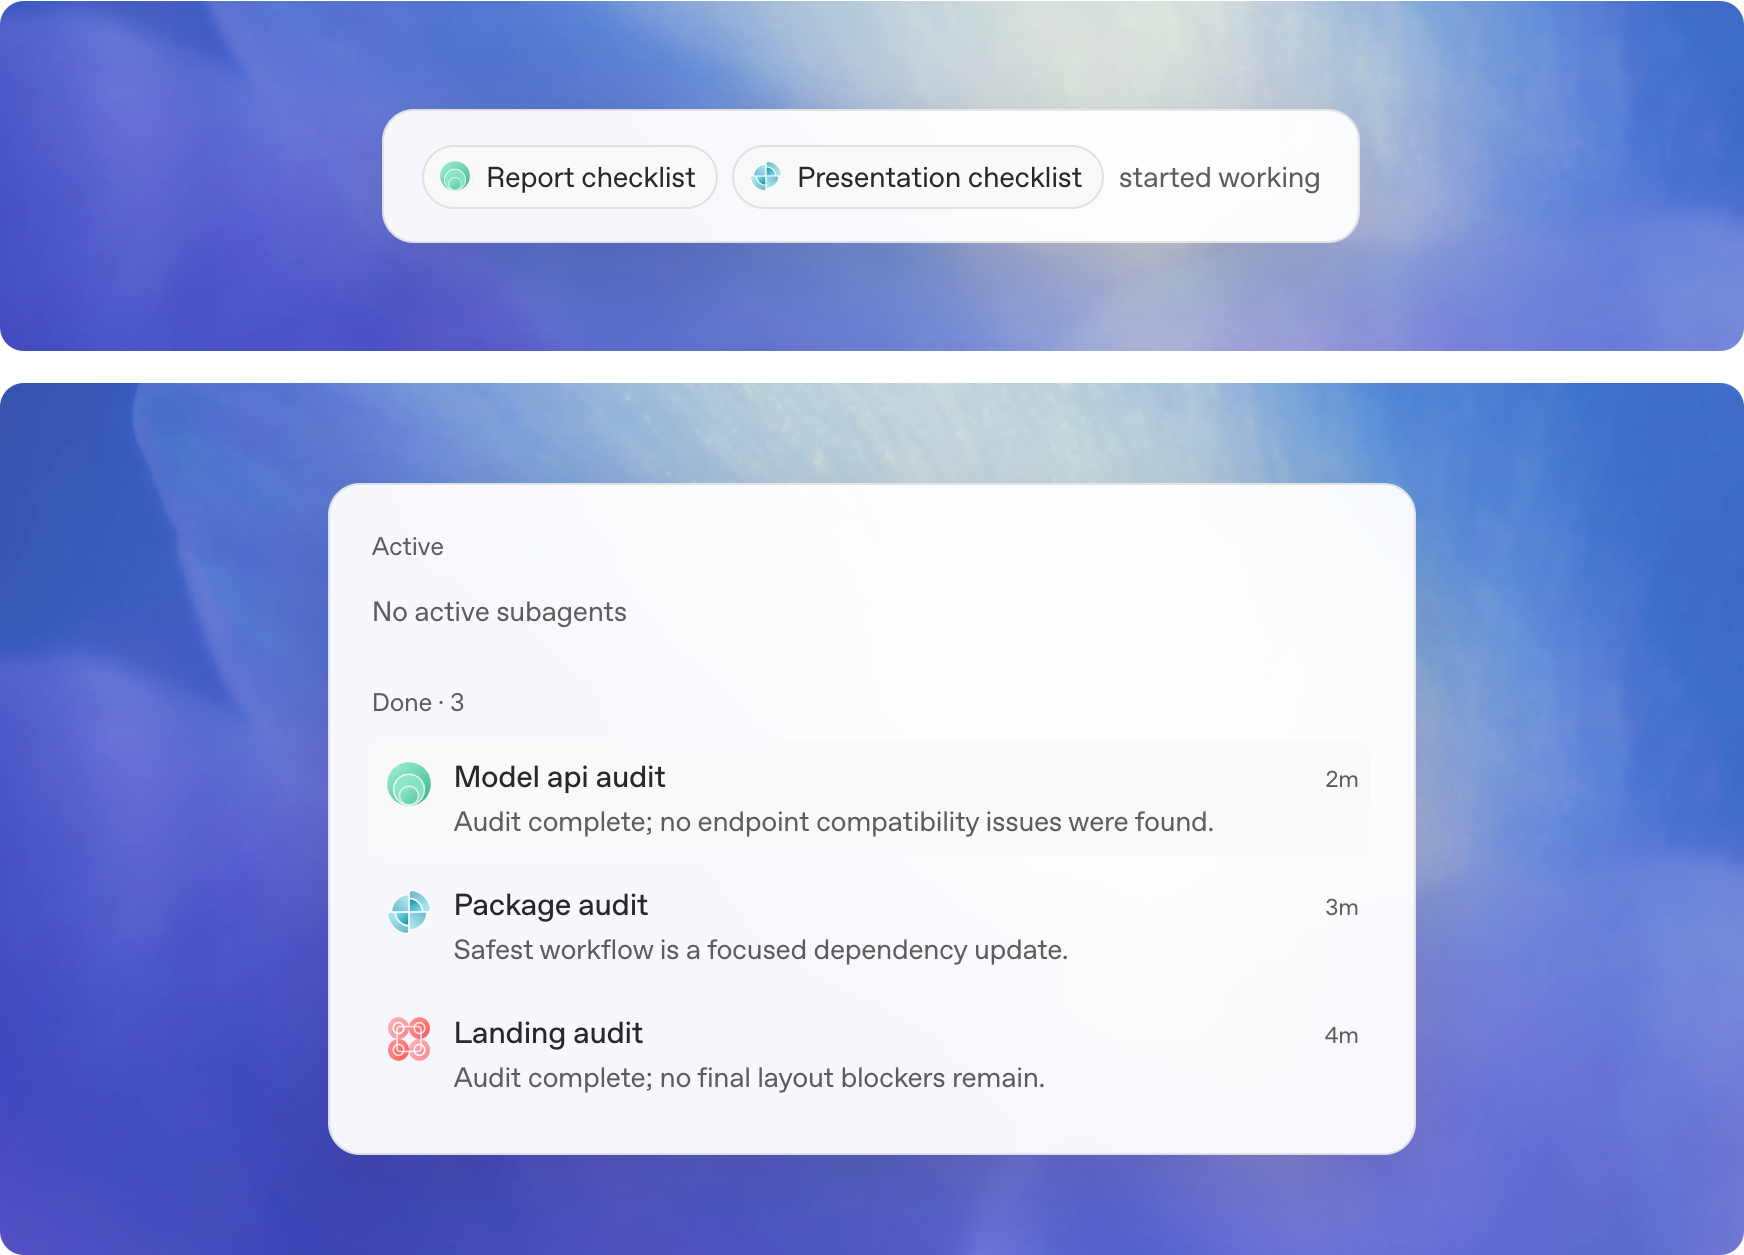
Отдельно скажу про режим Ultra. Это самый высокий уровень рассуждения, и, по странице моделей, в нём Codex сам раскидывает подходящую работу по субагентам, без отдельной просьбы. На остальных уровнях просить приходится явно.
Как создать своих агентов для Codex в TOML
Встроенных агентов хватает для старта, но польза появляется, когда у каждого агента узкая роль. Каждый свой агент описывается отдельным TOML-файлом:
~/.codex/agents/— личные агенты, работают во всех проектах;.codex/agents/— агенты проекта, их коммитят в репозиторий, и они достаются всей команде.
Обязательных полей три: name, description и developer_instructions. Codex узнаёт агента по полю name, а не по имени файла, хотя называть файл так же удобнее. Если имя совпадает со встроенным (например, explorer), твой агент его перекроет.
Для демо я описал трёх агентов. Разведчик читает код на быстрой модели:
# .codex/agents/pr-explorer.toml
name = "pr_explorer"
description = "Читает код и собирает факты перед ревью. Ничего не правит."
model = "gpt-6-luna"
model_reasoning_effort = "high"
developer_instructions = """
Режим исследования. Файлы не меняй.
Пройди по реальным путям выполнения, называй файлы и функции.
Фиксы не предлагай, если родительский агент не попросит.
"""
Ревьюер работает на модели посильнее:
# .codex/agents/reviewer.toml
name = "reviewer"
description = "Ревьюер PR: корректность, безопасность, пропущенные тесты."
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
developer_instructions = """
Ревьюй код как владелец проекта. Файлы не меняй.
Приоритет: корректность, безопасность, регрессии, пропущенные тесты.
Каждая находка с файлом, строкой и шагом воспроизведения.
Замечания по стилю только если за ними прячется баг.
"""
Третий, test_writer, единственный правит файлы: пишет тесты в tests/ и не трогает код приложения. Его файл устроен так же, поэтому не привожу.
Кроме модели и уровня рассуждения в файле агента можно задать model_reasoning_summary и model_verbosity, а лишние возможности отключить: features.shell_tool = false, features.apps = false и так далее. Скиллы агент наследует от родителя, ненужные выключаются через skills.config.
Общие настройки субагентов живут в секции [agents] файла config.toml. Вот конфиг демо-проекта:
# .codex/config.toml
[agents]
max_concurrent_threads_per_session = 4
default_subagent_model = "gpt-6-luna"
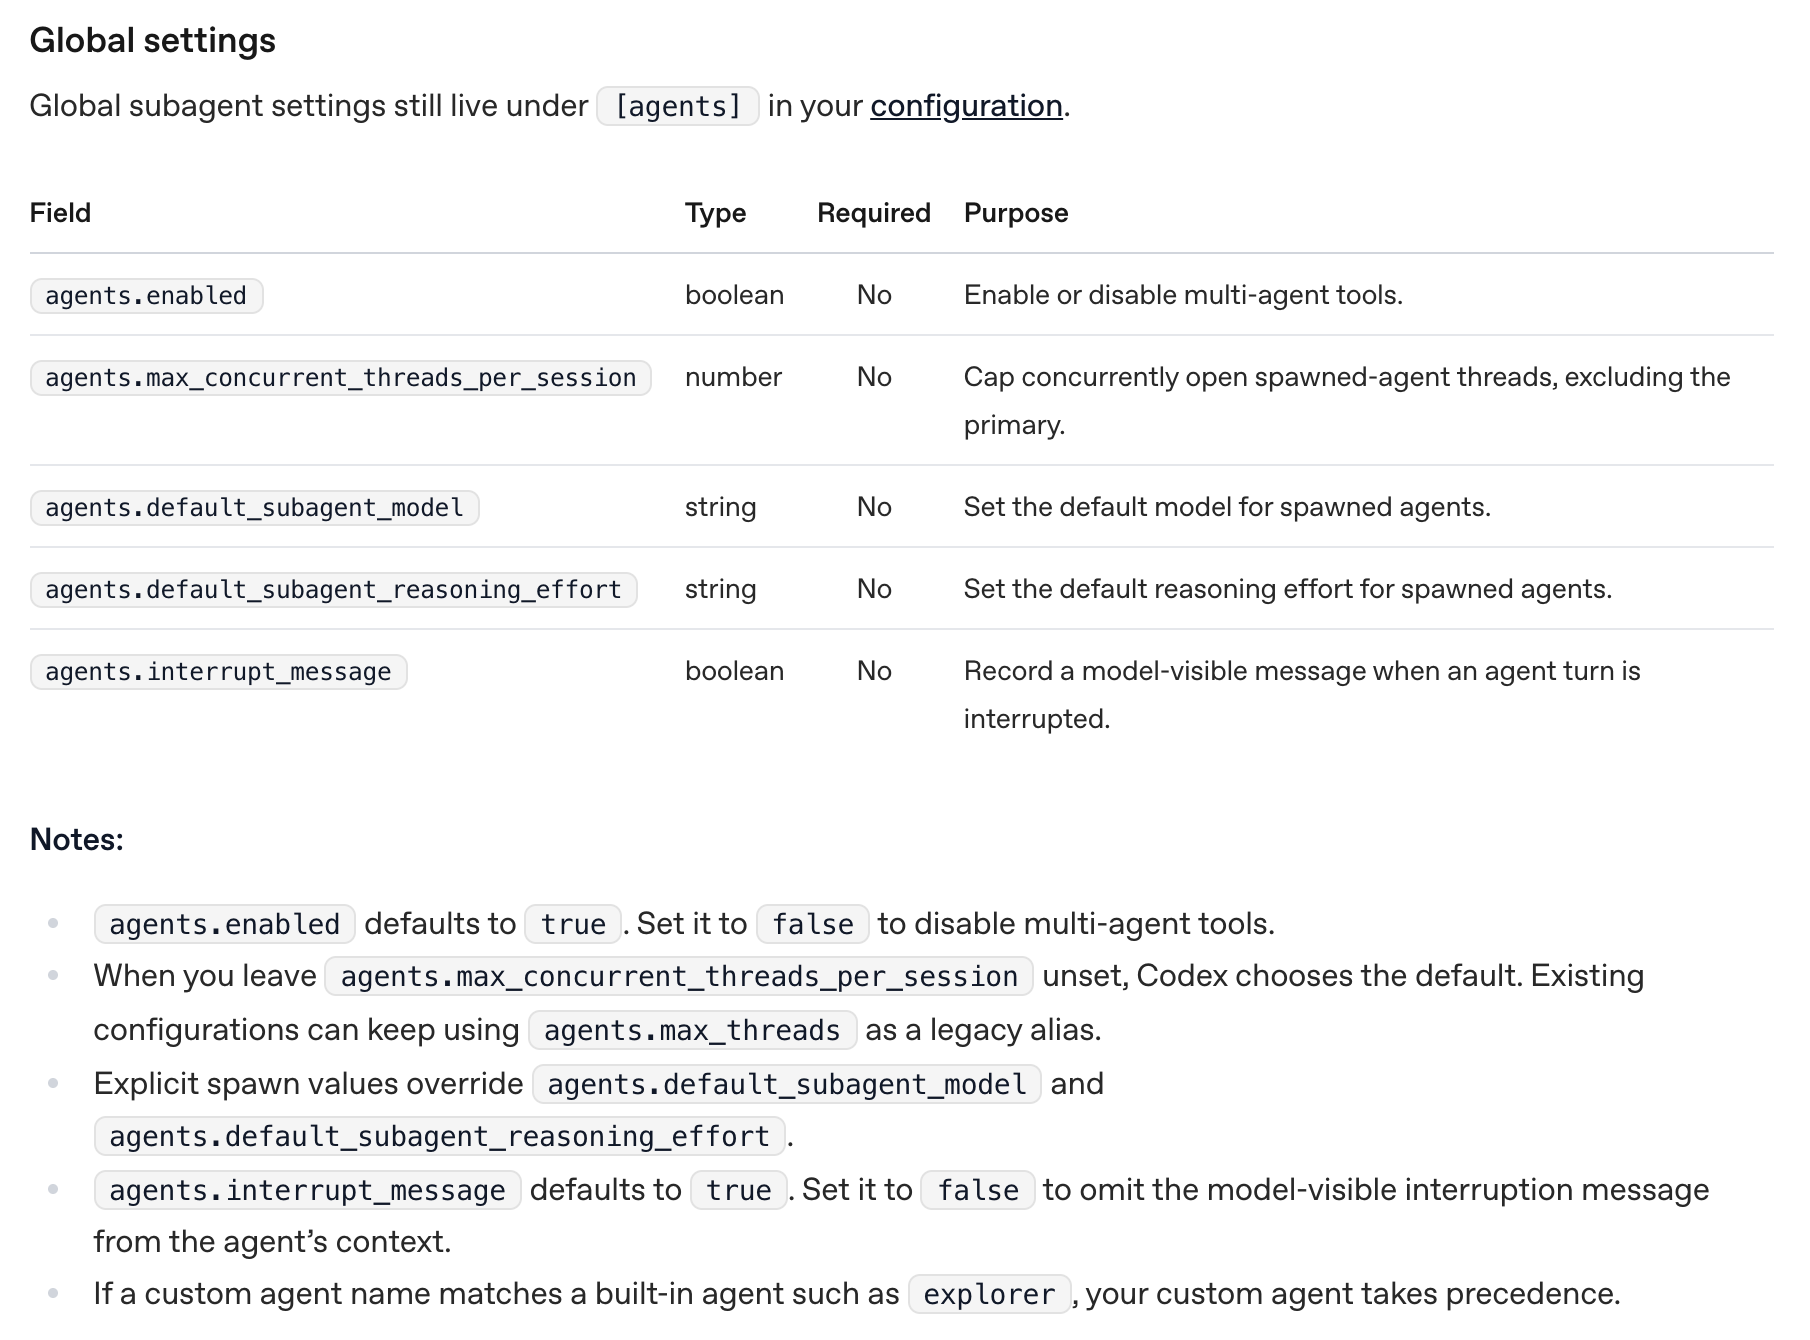
max_concurrent_threads_per_session ограничивает число одновременно открытых потоков субагентов, основной поток в него не входит. Если параметр не задан, лимит выбирает Codex. default_subagent_model и default_subagent_reasoning_effort задают модель для всех агентов, у которых своей нет. Полный список ключей в справочнике конфигурации.
Как агенты Codex разобрали ветку с тремя багами
Чтобы проверить инструкцию, я собрал маленький проект invoice-api: расчёт счёта с НДС и API, который берёт корзину из SQLite. В ветке feature/promo я добавил промокоды и специально заложил три ошибки: SQL-запрос со склейкой строки, KeyError на неизвестном промокоде и переход с Decimal на float в денежном расчёте. Тест в проекте один, и он эти ошибки не ловит.
Первый прогон я сделал в интерактивном Codex CLI с двумя агентами. Codex запустил два потока, дождался обоих и собрал ответ.
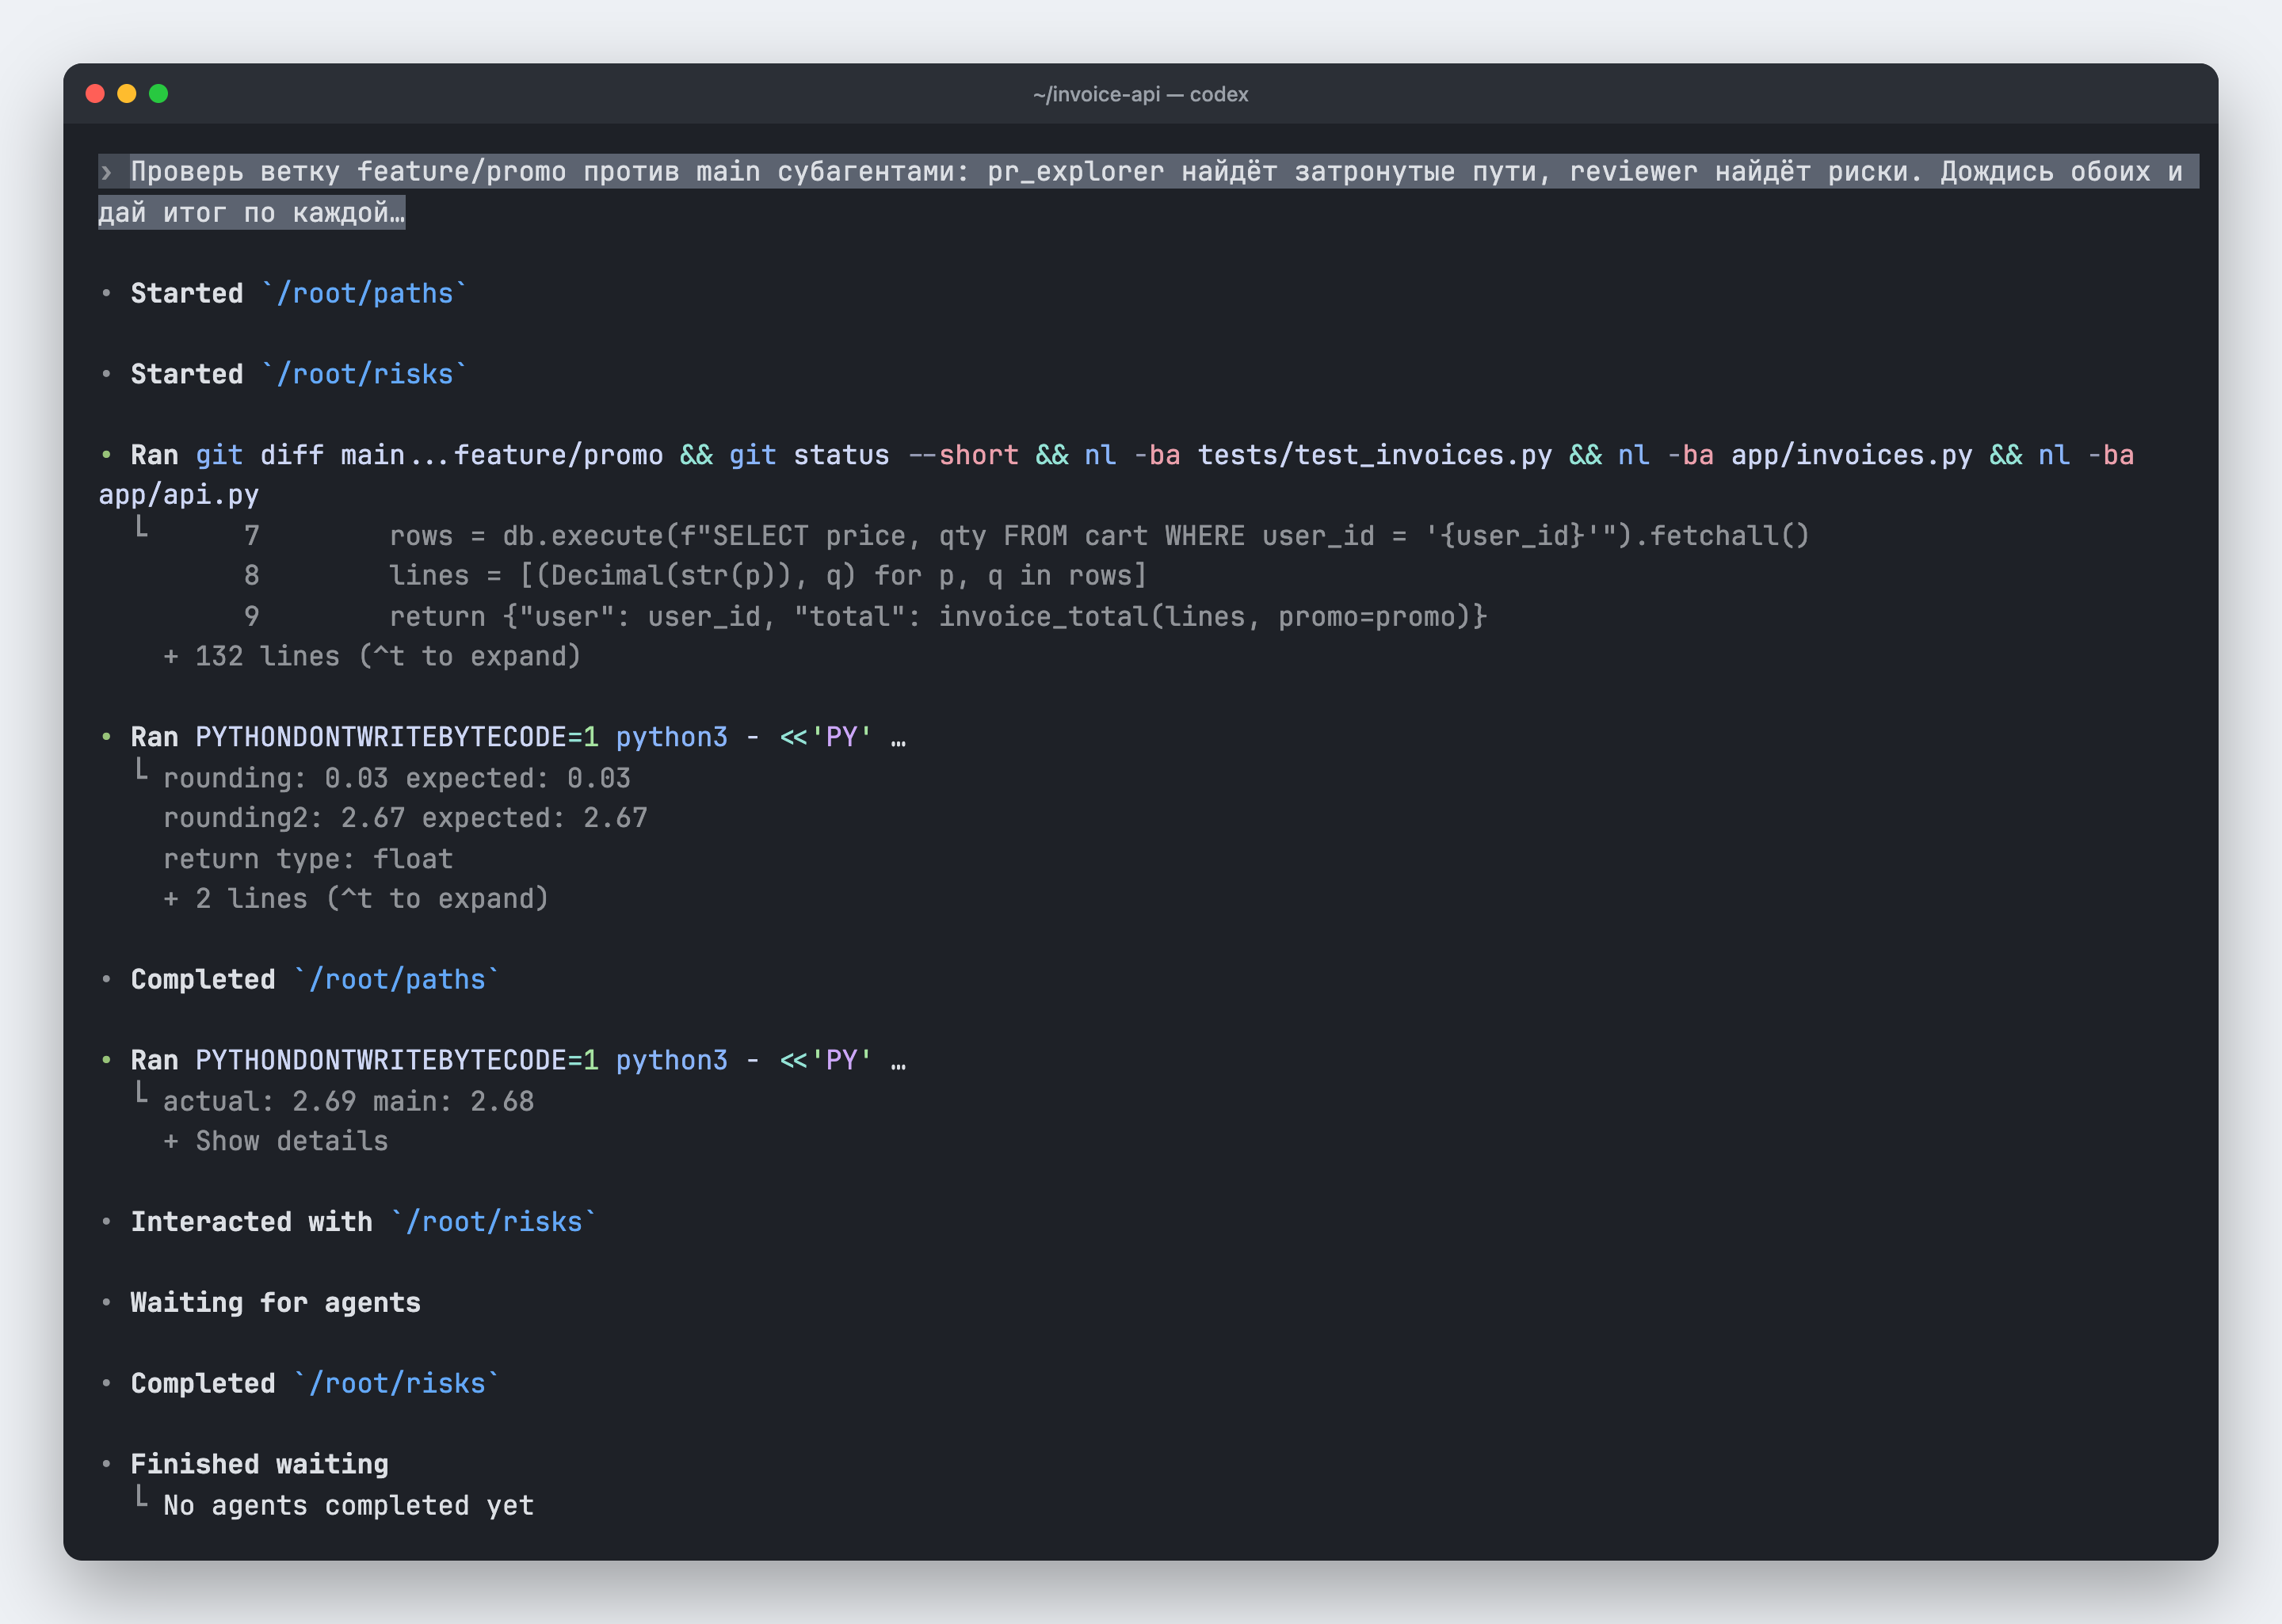
Вся проверка заняла 1 минуту 25 секунд. Итог пришёл одним сообщением, а под ним команда /subagents показала список потоков.
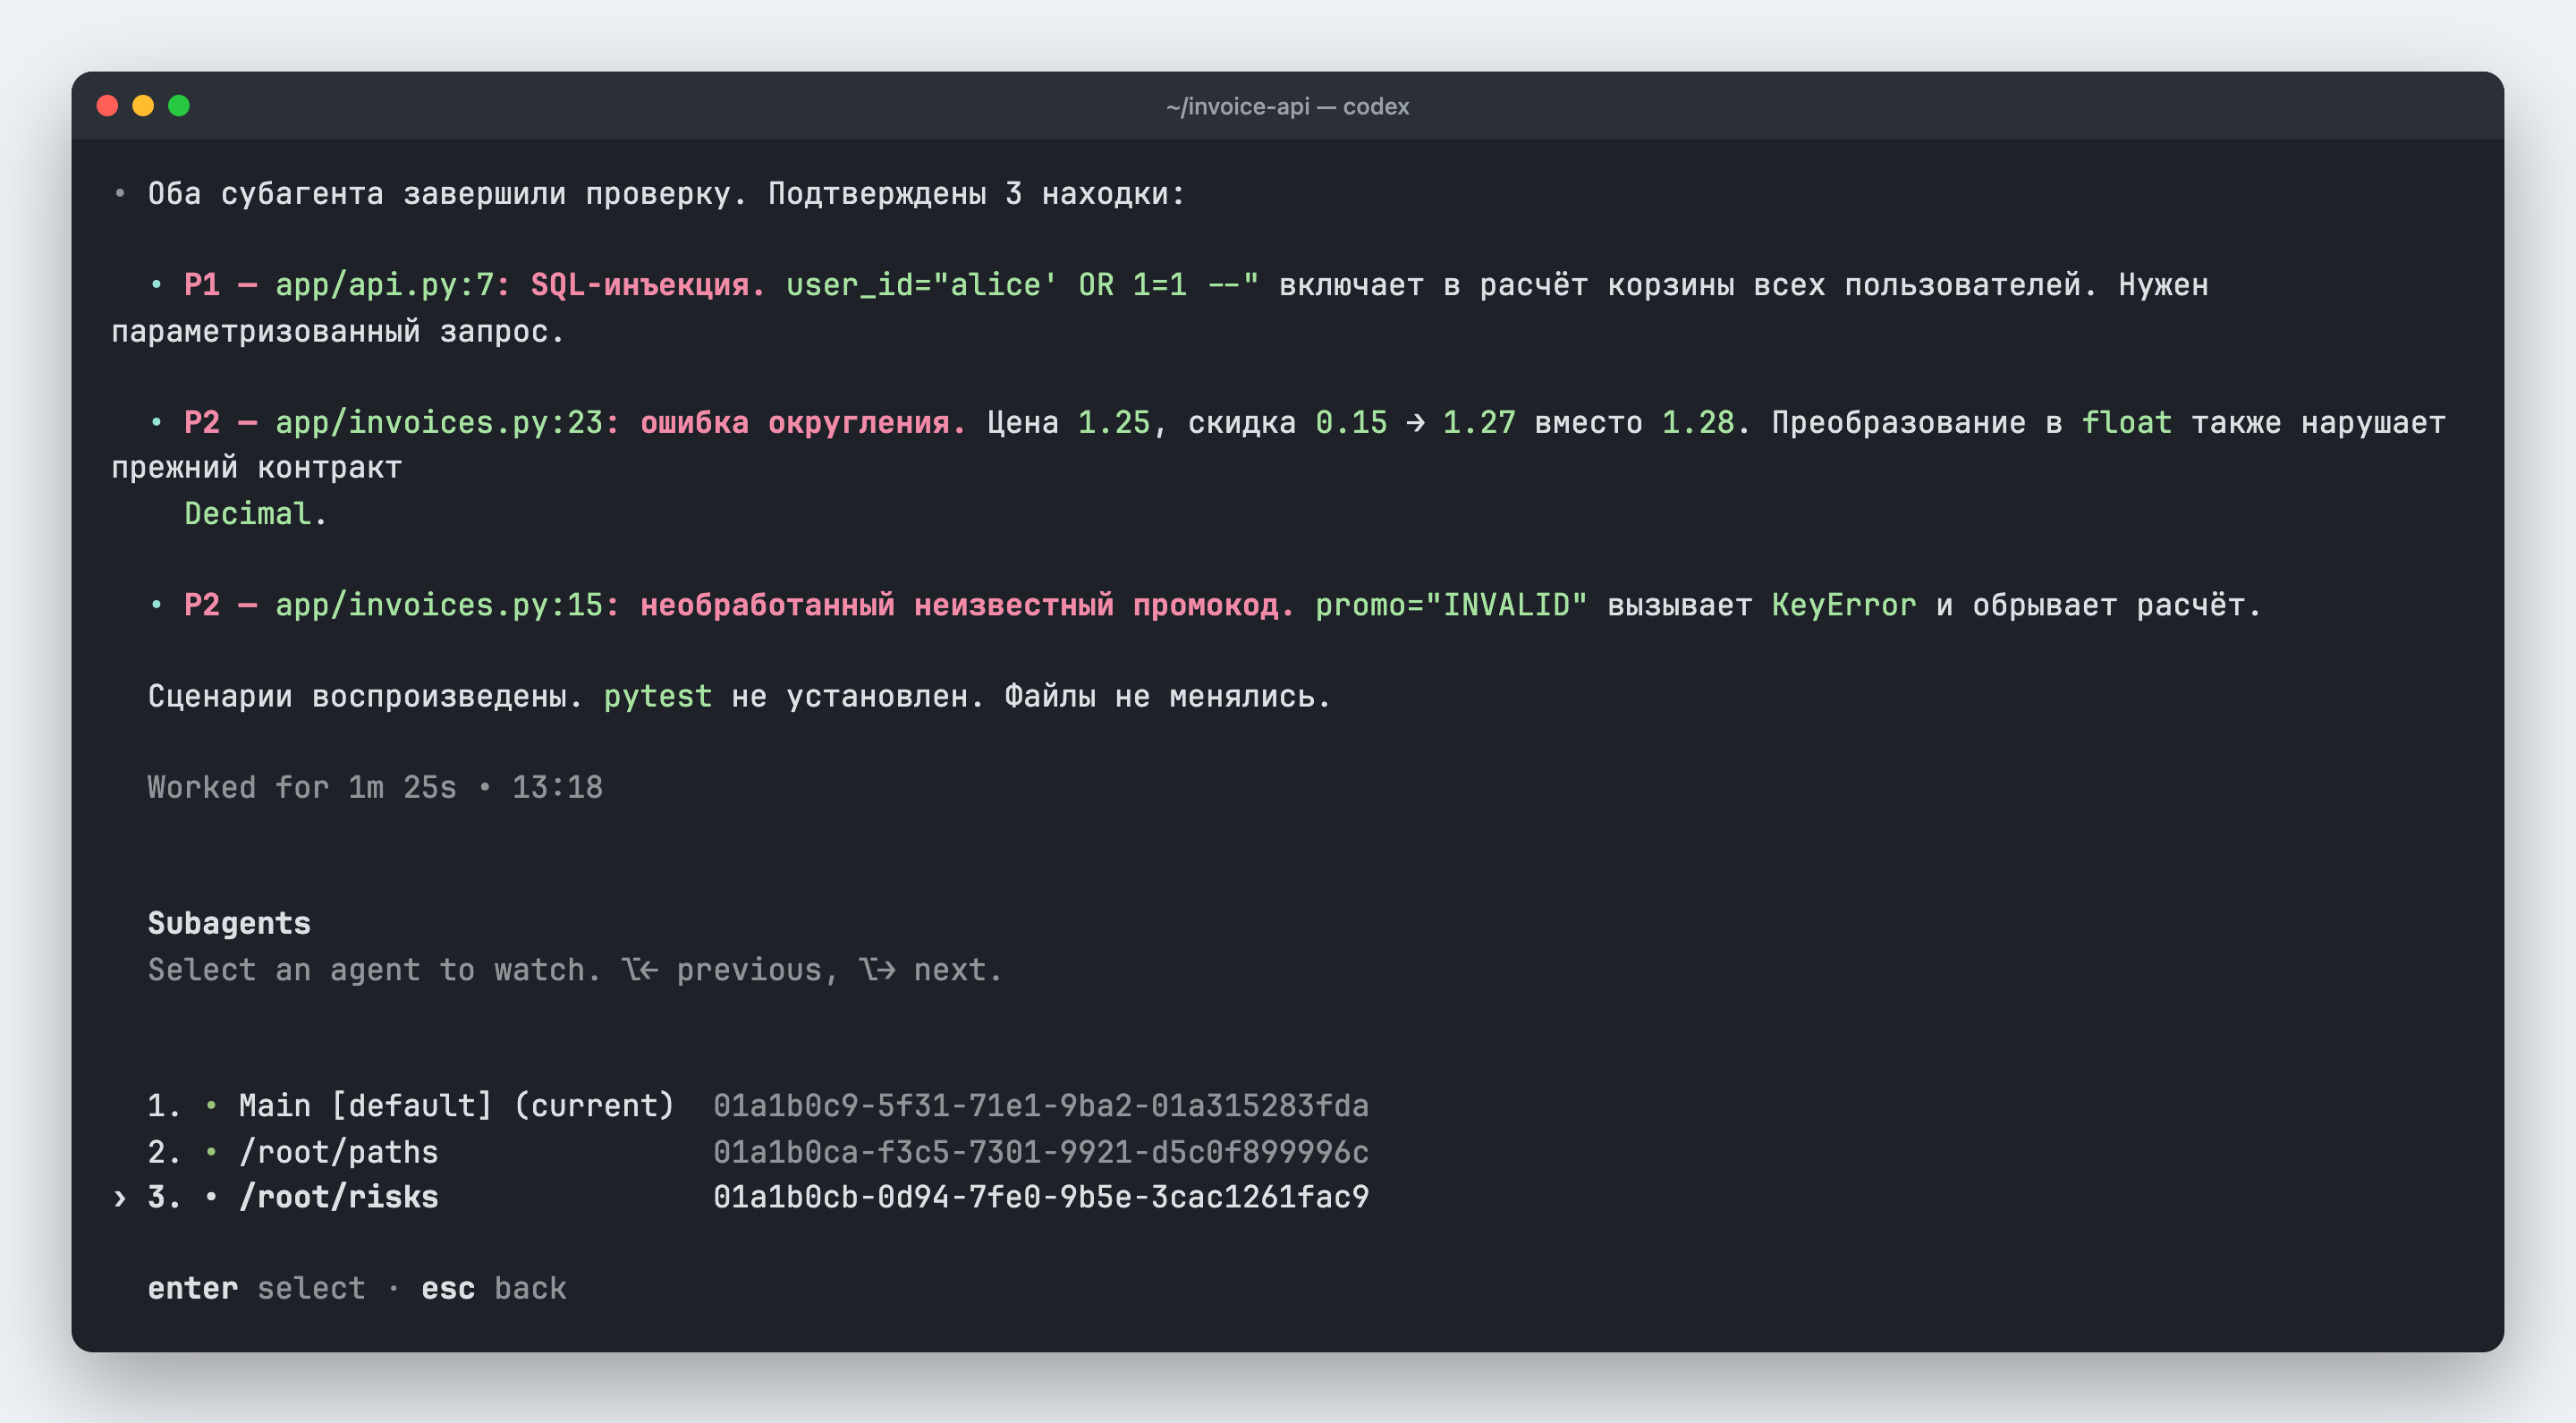
Если провалиться в поток, видно, что агент делал и на какой модели. Разведчик отработал за 22 секунды на GPT-6-Luna, ревьюер за 37 секунд на GPT-6.1-Sol, как и было прописано в их TOML.
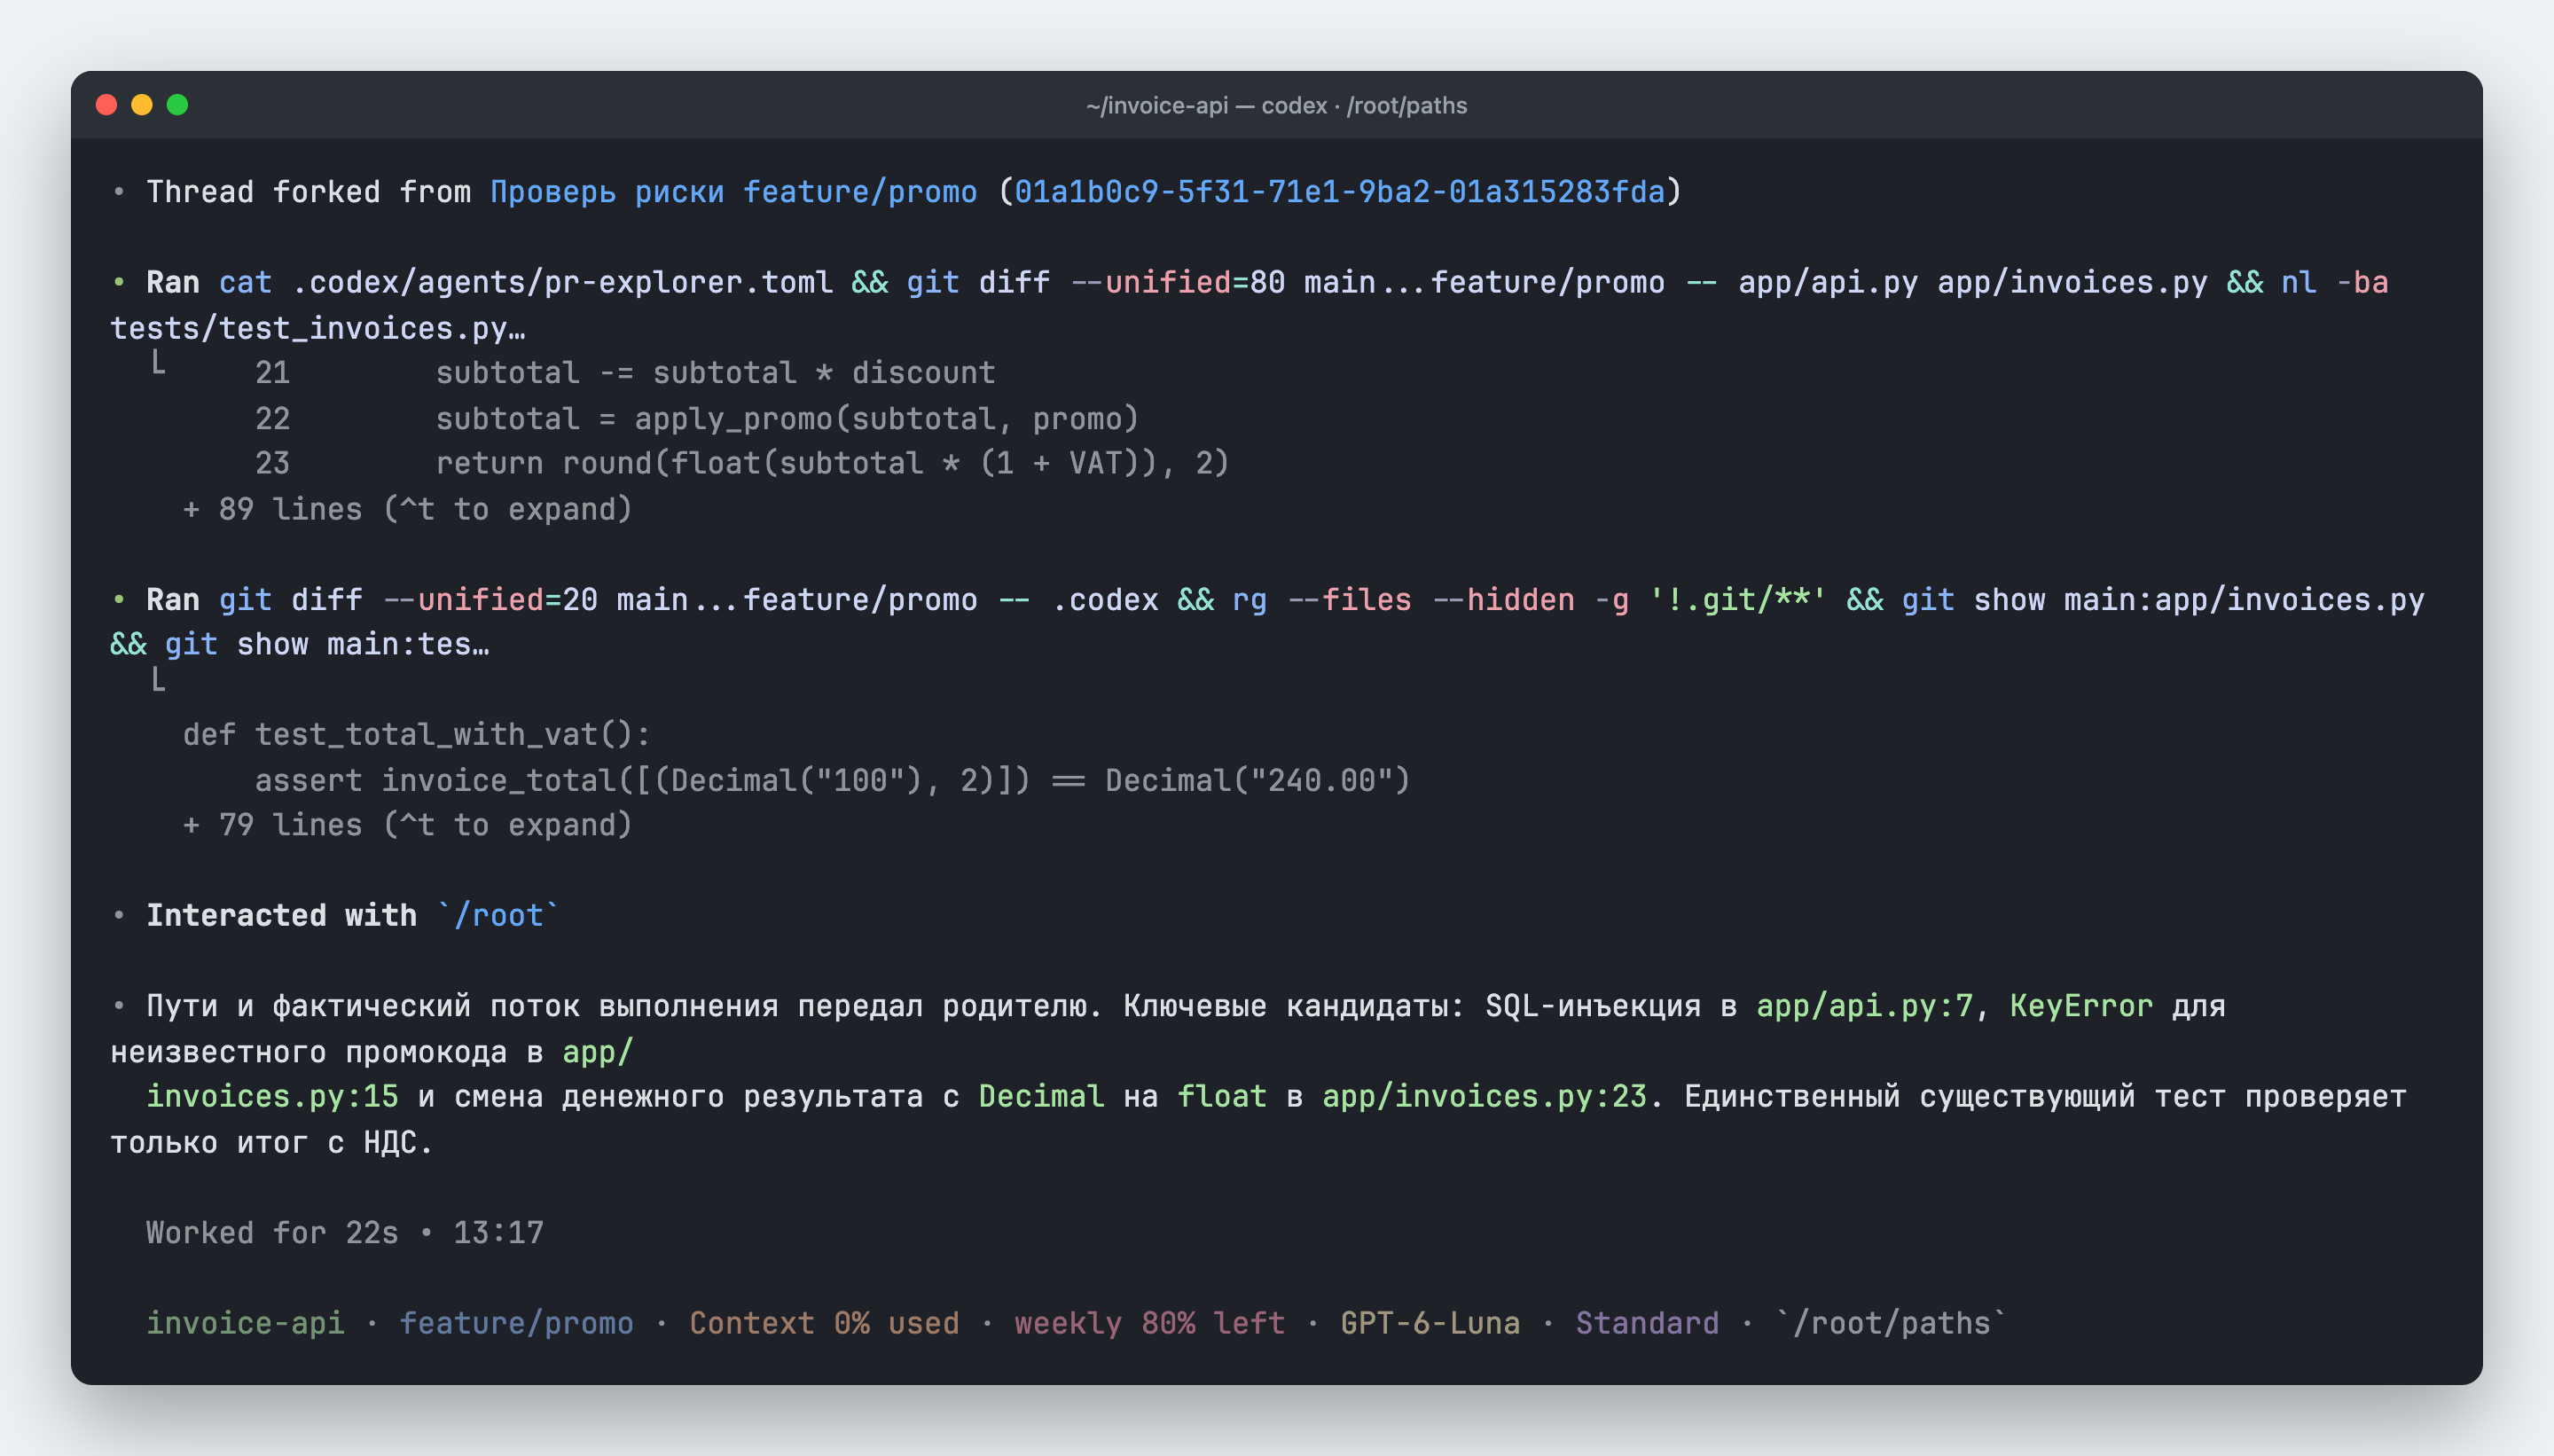
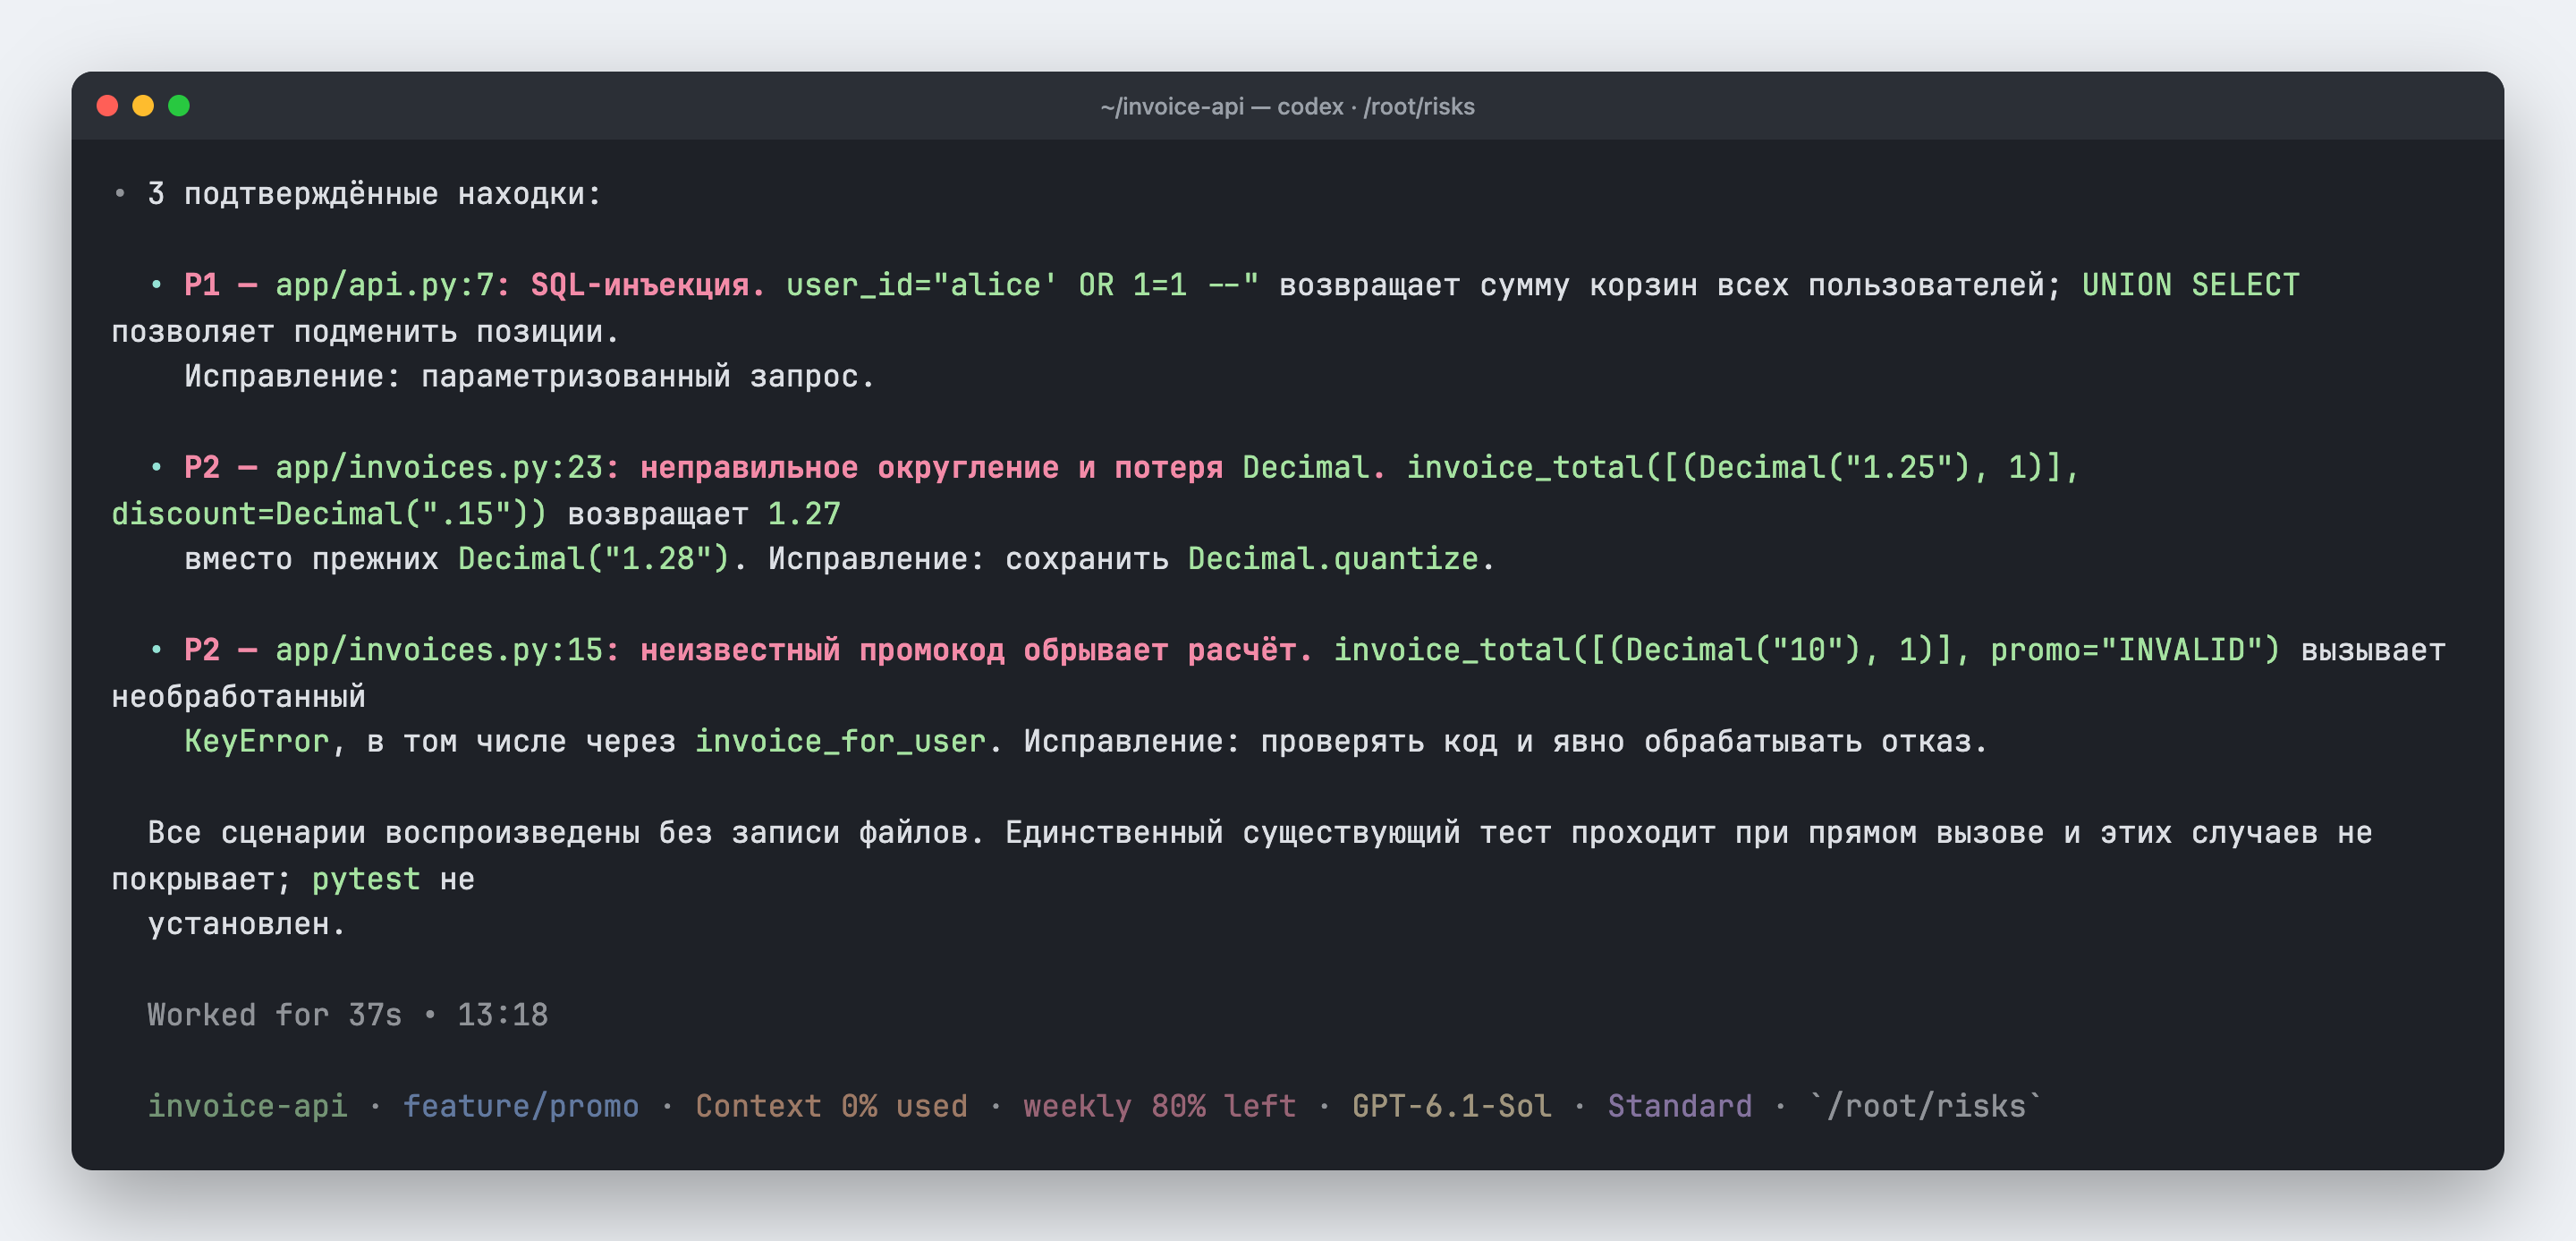
Разведчик прошёл по diff и передал родителю три кандидата в баги за 22 секунды на GPT-6-Luna. Ревьюер воспроизвёл каждую ошибку скриптом и предложил исправления за 37 секунд на GPT-6.1-Sol. Скриншоты: терминал / matveev.tech
Второй прогон я сделал через codex exec со всеми тремя агентами, включая test_writer. На него ушло около 3,5 минуты и 45 328 токенов. Агент дописал в tests/test_invoices.py пять тестов, и три из них упали ровно на заложенных ошибках.
def test_invoice_for_user_does_not_return_other_users_cart_rows():
    db = sqlite3.connect(":memory:")
    db.execute("CREATE TABLE cart (user_id TEXT, price TEXT, qty INTEGER)")
    db.executemany(
        "INSERT INTO cart VALUES (?, ?, ?)",
        [("alice", "10.00", 1), ("bob", "100.00", 1)],
    )

    result = invoice_for_user(db, "' OR '1'='1")

    assert result["total"] == Decimal("0.00")
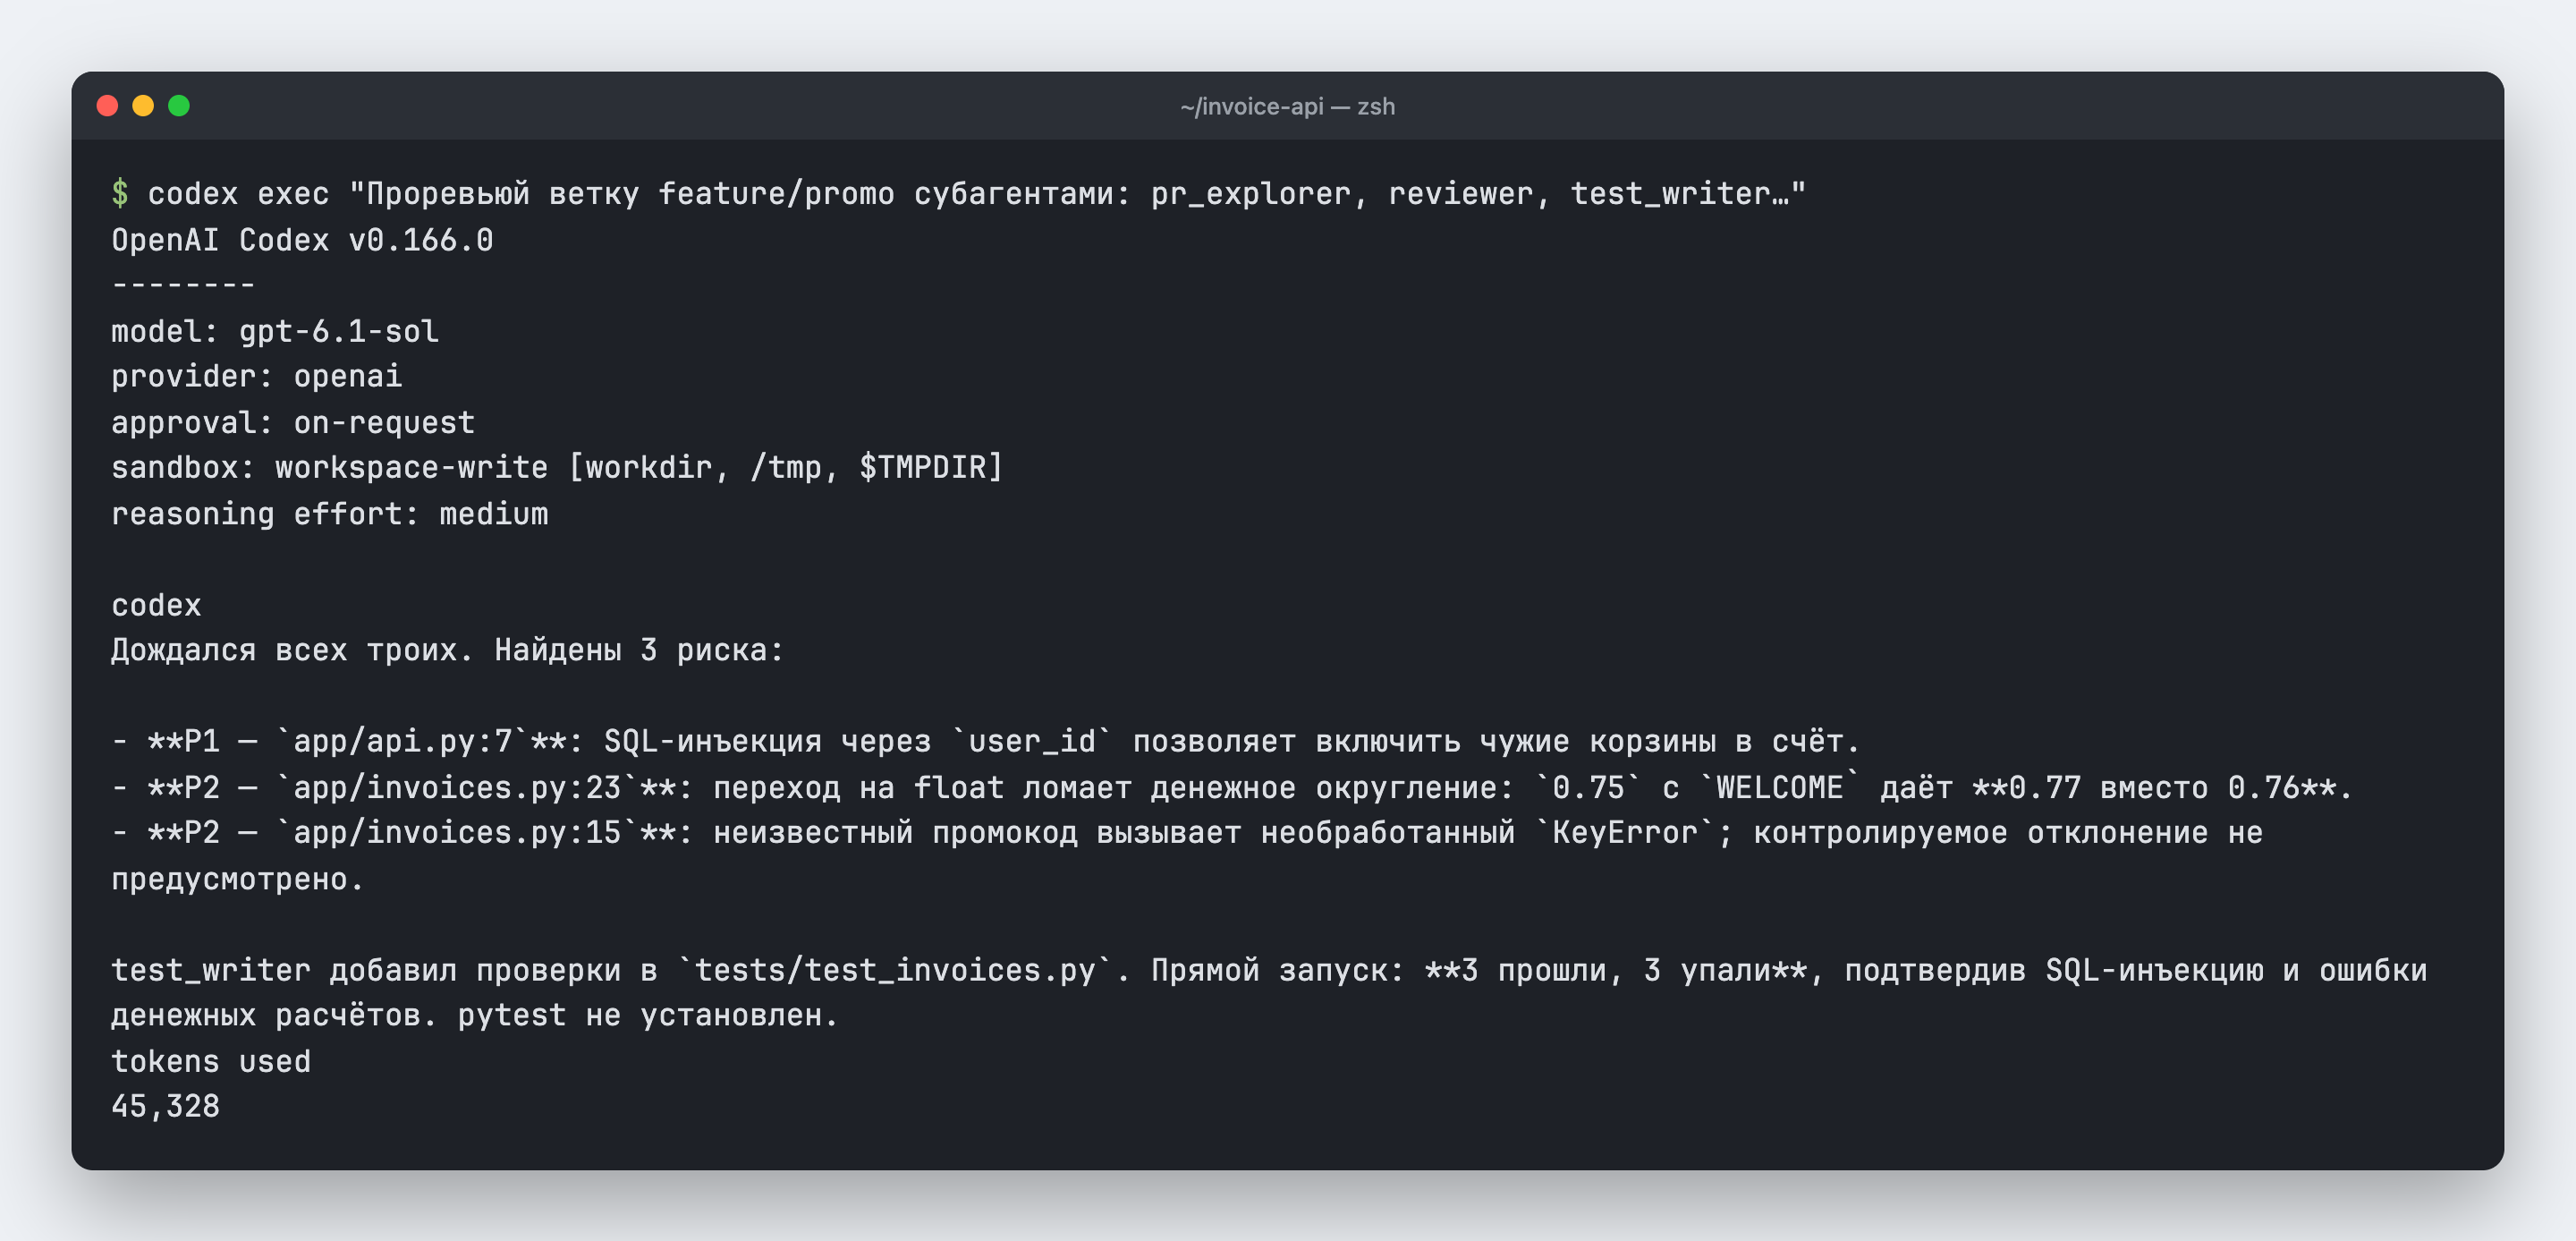
Что я вынес из прогона. Субагенты нашли всё, что я заложил, и ни разу не полезли в чужую зону. Но основной агент тоже не сидел без дела и сам перепроверял находки скриптами. Это хорошо для качества и плохо для токенов: часть работы сделана дважды.
Какую модель дать каждому агенту
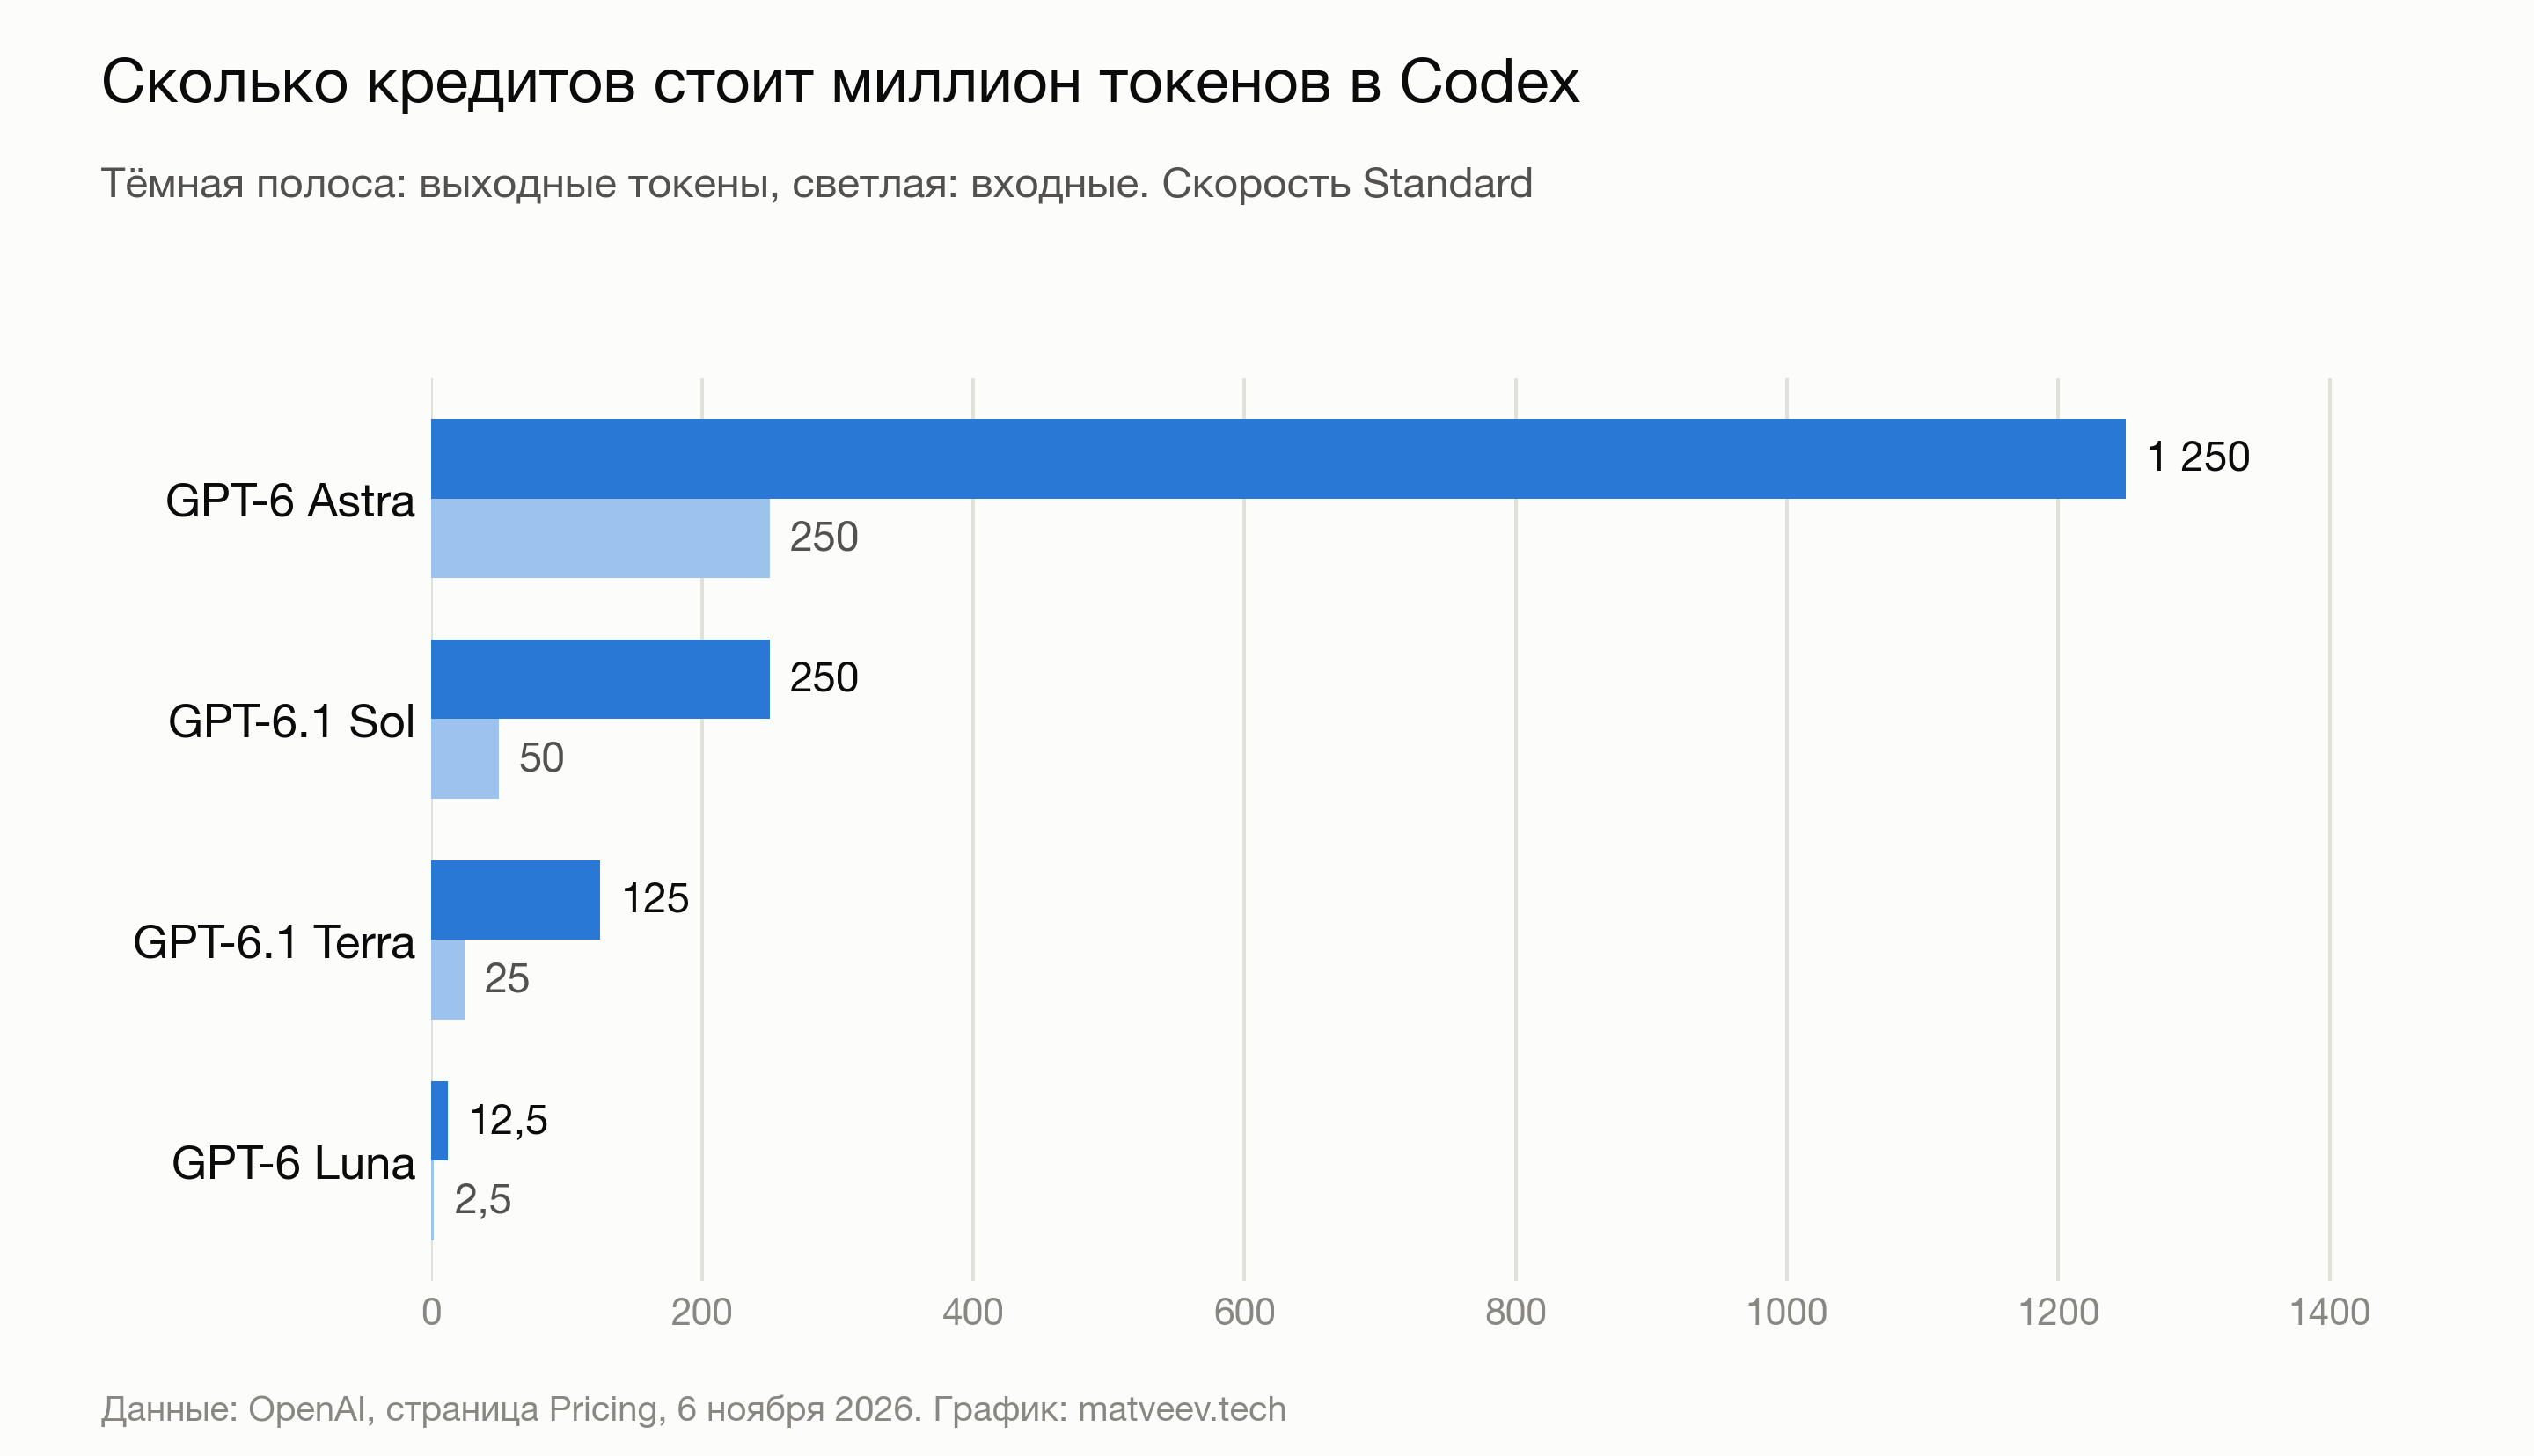
Если модель в файле агента не указана, субагент берёт модель и уровень рассуждения родителя. Порядок такой: значение из запроса на запуск, потом [agents] в конфиге, потом родитель, а поле model из файла агента перекрывает всё это. OpenAI советуют начинать с GPT-6.1 Sol для сложных агентов и брать GPT-6 Luna для быстрых и узких задач.
| Модель | Для каких агентов | Кредитов за 1 млн токенов (вход / выход) | Сообщений на Plus за 5 часов |
|---|---|---|---|
gpt-6-astra |
Самые тяжёлые задачи, редко нужна субагенту | 250 / 1250 | 5–45 |
gpt-6.1-sol |
Ревьюер, планировщик, всё неоднозначное | 50 / 250 | 15–160 |
gpt-6.1-terra |
Быстрые задачи с текстом и картинками | 25 / 125 | 35–285 |
gpt-6-luna |
Разведчик, поиск по коду, однотипная работа | 2,5 / 12,5 | 350–3000 |
Цифры взяты со страницы цен Codex на 6 ноября 2026 года. Число сообщений там дано как оценка для тарифов Plus и Business, а не жёсткий лимит.
По уровню рассуждения (model_reasoning_effort) правило простое. low подходит, когда задача прямолинейная и важна скорость, medium годится почти для всего остального, а high нужен ревьюеру и агенту по безопасности. У новых моделей есть ещё xhigh, max и ultra, но их держи для главного агента: субагент на максимуме съедает лимит очень быстро.
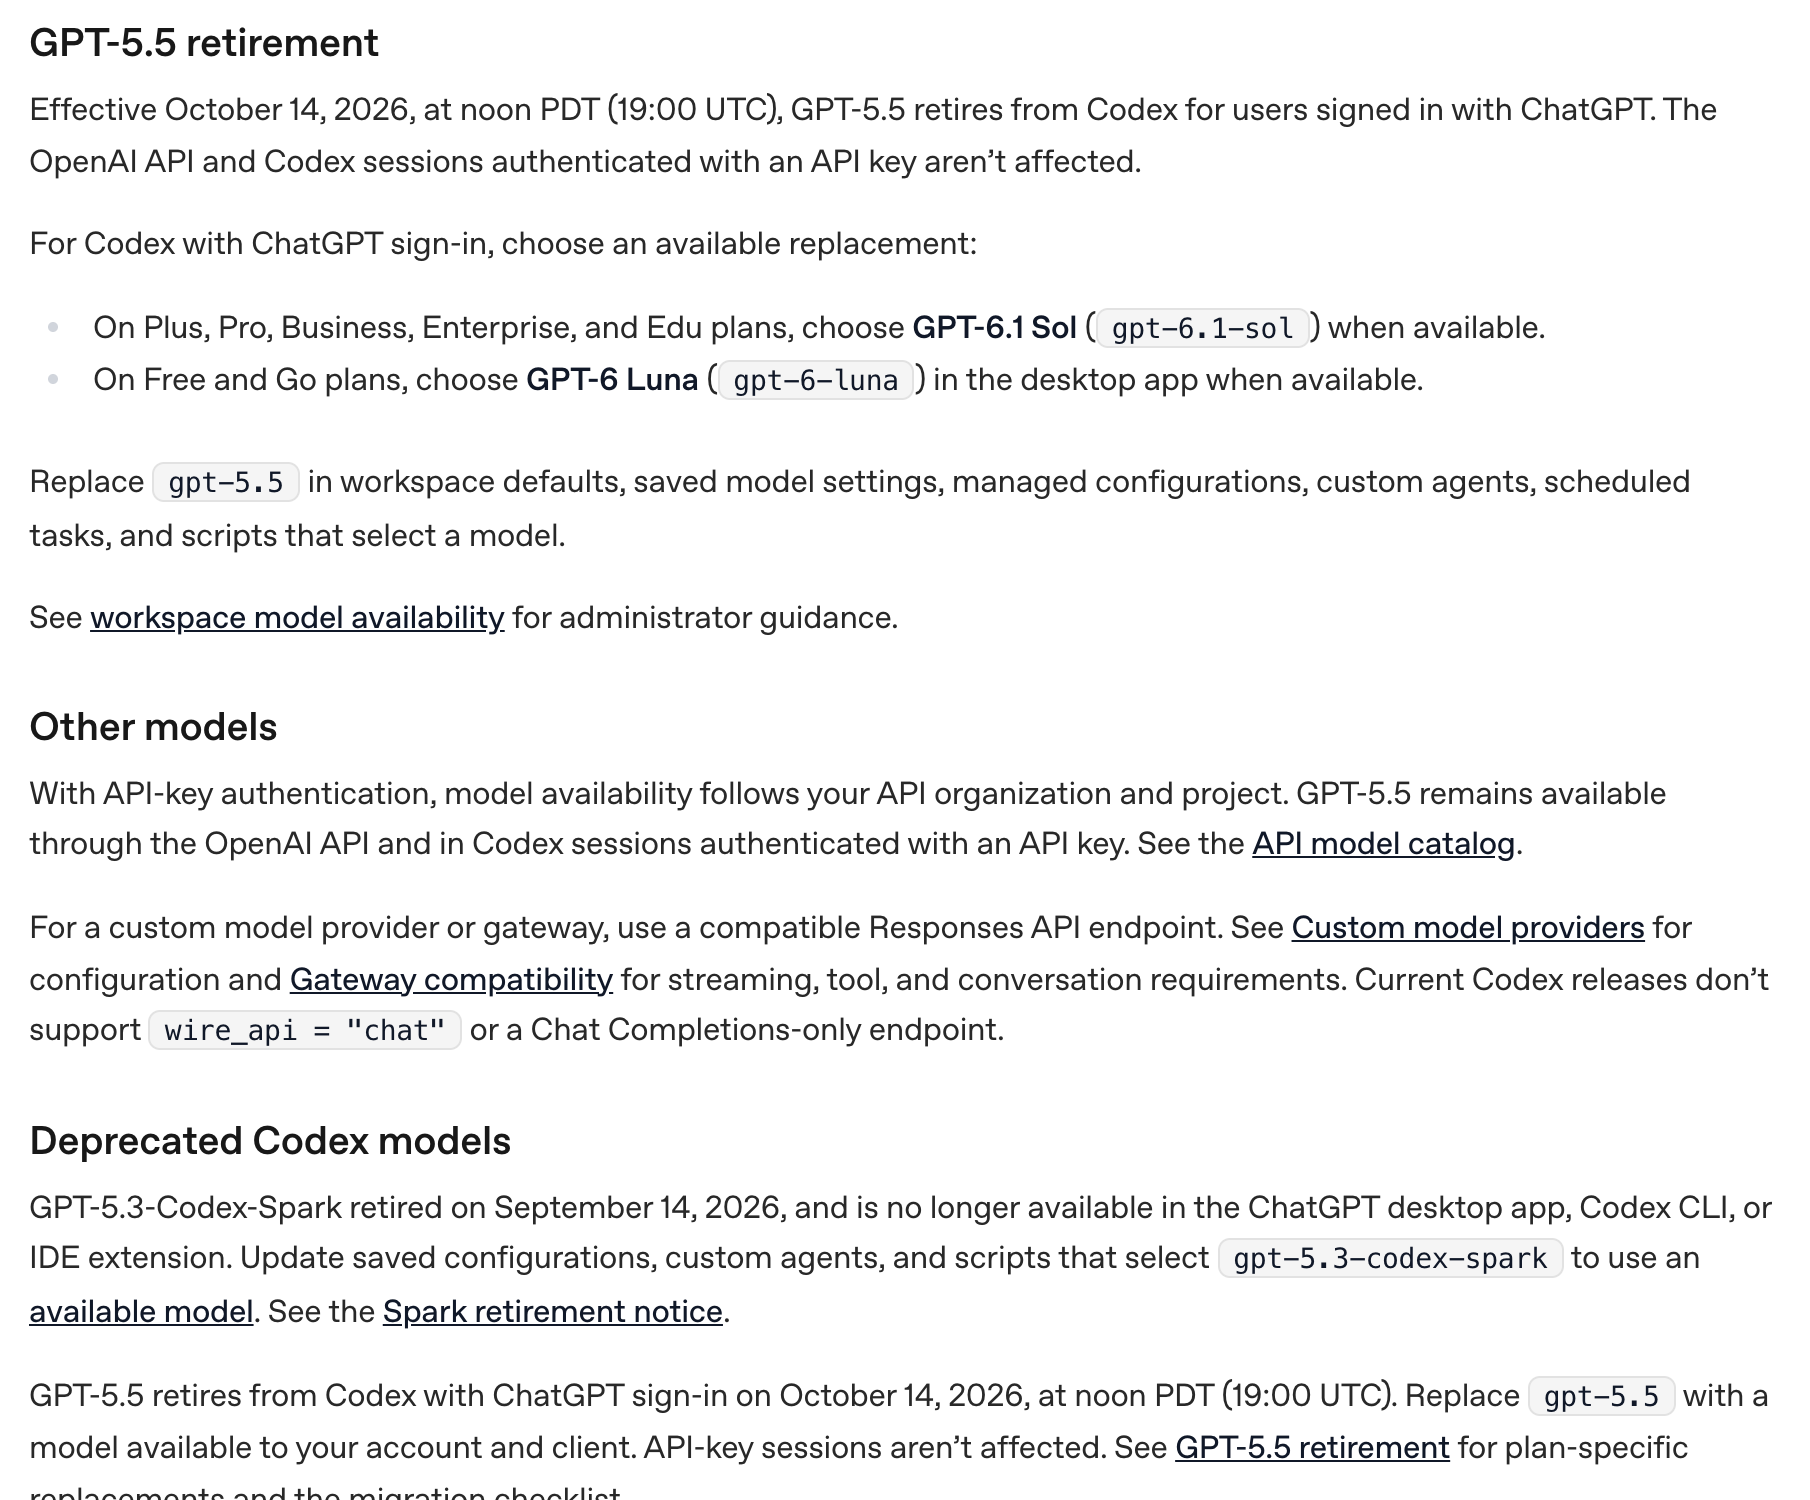
Если у тебя остались конфиги с весны, проверь в них названия моделей. gpt-5.4 и gpt-5.4-mini сняли с Codex 31 августа, gpt-5.3-codex-spark — 14 сентября, gpt-5.5 — 14 октября 2026 года. gpt-5.3-codex тоже помечена устаревшей. Всё это касается входа через ChatGPT, по API-ключу старые модели пока доступны. Я проверил: codex exec -m gpt-5.4 сейчас падает с ошибкой «The 'gpt-5.4' model is not supported when using Codex with a ChatGPT account».
Подробнее про текущую линейку я писал в обзоре GPT-6 Astra, а про то, как OpenAI пришли к названиям Sol, Terra и Luna, в статье о GPT-5.6.
Что изменилось в агентах Codex с марта 2026 года
OpenAI вывели субагентов из превью 16 марта 2026 года. С тех пор поменялось вот что.
Команда /agent стала /subagents. Старая команда для переключения потоков в документации больше не упоминается.
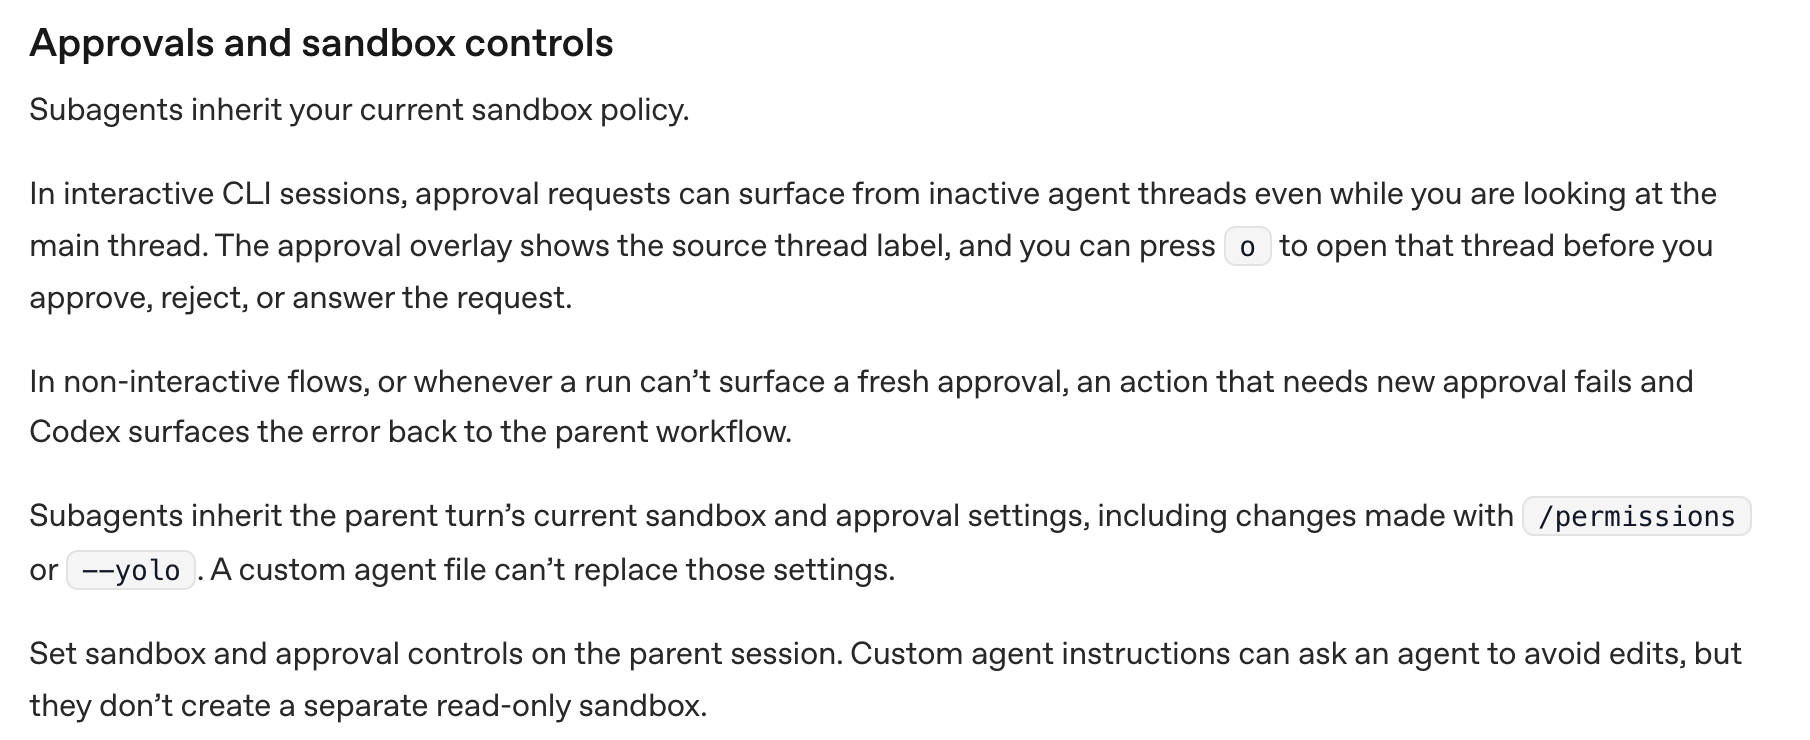
Песочницу больше нельзя задать в файле агента. Весной я советовал ставить sandbox_mode = "read-only" исследователям. Теперь sandbox_mode, approval_policy, model_provider и mcp_servers в файле агента не переопределяют настройки родителя. Субагент получает песочницу и режим подтверждений основной сессии, включая изменения через /permissions и --yolo. Мне этого не хватает: раньше разведчик физически не мог ничего сломать, а теперь это держится только на его инструкции.
MCP-серверы подключаются только у родителя. Секция [mcp_servers] в файле агента больше не работает: сервер нужно описать в config.toml основной сессии, и агент его унаследует.
Лимит потоков переименовали. agents.max_threads теперь псевдоним для agents.max_concurrent_threads_per_session. Появились default_subagent_model и default_subagent_reasoning_effort.
CSV-батчи убрали. Экспериментального инструмента spawn_agents_on_csv нет ни в документации, ни в бинарнике CLI 0.166.0: я проверил строки в самом файле. Поле nickname_candidates в коде пока осталось, но из документации пропало, так что я бы на него не опирался.
Субагенты появились в IDE-расширении и ChatGPT Work. В марте их не было нигде, кроме CLI и приложения.
Какие ошибки ломают работу субагентов
Большинство проблем, которые я ловил, повторяются. Вот самые частые.
Ждать, что Codex сам распараллелит работу. Без явной просьбы или инструкции в AGENTS.md локальный Codex работает одним агентом. Сам он делегирует только в режиме Ultra. Пиши прямо: «запусти по субагенту на каждый пункт» или «делегируй это двум агентам параллельно».
Полагаться на «только чтение» из инструкции. В моём демо сессия работала в workspace-write, и права на запись были у всех трёх агентов. Разведчик и ревьюер не правили файлы только потому, что так написано в их инструкциях. Если запись опасна, ставь песочницу на всю сессию.
Пускать нескольких агентов писать в одни файлы. Два агента, которые правят один модуль, создадут конфликты, и основной агент потратит время на их разбор. Я оставляю право записи одному агенту, как test_writer в демо, а остальным даю задачи на чтение.
Оставлять в TOML снятые модели. Агент с gpt-5.4 или gpt-5.3-codex-spark в файле упрётся в ту же ошибку «model is not supported», что и прямой запуск. Пройдись по ~/.codex/agents/ и .codex/agents/ и замени модели на актуальные.
Забывать про расход токенов. Каждый субагент — отдельная модельная сессия со своими вызовами инструментов. Ревью маленькой ветки тремя агентами стоило мне 45 328 токенов. На большом проекте умножай на размер diff и число агентов, а лимит держи через max_concurrent_threads_per_session. Общие приёмы экономии собраны в гайде как экономить токены в Cursor и Claude Code, к Codex они подходят почти без изменений.
Частые вопросы о субагентах в Codex
Работают ли субагенты в IDE-расширении Codex?
Да. В текущих версиях активные субагенты показываются над полем ввода в панели фоновых агентов. Оттуда видно статус, можно остановить всех или открыть поток конкретного агента. Своих агентов из .codex/agents/ расширение подхватывает так же, как CLI. Как поставить Codex в среду JetBrains, я показывал в гайде по Codex в JetBrains IDE.
Можно ли подключить MCP-сервер к отдельному агенту?
Нет, теперь нельзя. Агент наследует MCP-серверы родительской сессии, а секция [mcp_servers] в его TOML ничего не переопределяет. Подключи сервер в config.toml и в инструкции агента напиши, когда им пользоваться.
Чем субагенты в Codex отличаются от субагентов Claude Code?
Идея одна: специализированные агенты со своим контекстом. В Claude Code агента описывают Markdown-файлом с заголовком в .claude/agents/, в Codex — TOML-файлом в .codex/agents/. Ещё в Claude Code есть команды агентов (Agent Teams), участники которых общаются между собой напрямую, у Codex такого пока нет.
Сколько субагентов можно запустить одновременно?
Сколько разрешает agents.max_concurrent_threads_per_session. Если параметр не задан, лимит выбирает Codex. Основной поток в лимит не входит. Чем больше потоков, тем быстрее результат, но и лимит подписки тает быстрее.
Чек-лист перед запуском агентов в Codex
Сохрани список и пройдись по нему перед первым прогоном, а потом после каждого обновления Codex.
codex features listпоказываетmulti_agentв статусе stable иtrue.- В промпте или
AGENTS.mdпрямо написано, на какие куски делить работу и в каком виде вернуть итог. - У каждого своего агента в TOML есть
name,descriptionиdeveloper_instructions. - В
~/.codex/agents/и.codex/agents/не осталосьgpt-5.4,gpt-5.5иgpt-5.3-codex-spark. - Разведчики и однотипные воркеры сидят на
gpt-6-luna, ревьюер наgpt-6.1-sol. - Права на запись есть у одного агента, а если запись опасна, песочница задана всей сессии.
- MCP-серверы описаны в
config.tomlосновной сессии, а не в файле агента. max_concurrent_threads_per_sessionзадан под твой лимит подписки.
Больше про Codex, Cursor и другие среды для кода — в разделе Вайб-кодинг.
Читайте также
- Топ-6 AI-агентов для кода в 2026: сравнение Codex с другими агентами для разработки
- Codex в JetBrains IDE: как работать с Codex прямо из IntelliJ и PyCharm
- Что такое харнесс для AI-агента: чем обвязка вокруг модели влияет на работу агентов
- Паттерны воркфлоу AI-агентов: когда хватает одного агента, а когда нужна мультиагентная схема