Voice Standard Bench: какую LLM брать для голосовых задач
AssemblyAI прогнала 52 модели по четырём голосовым задачам на записях от 30 секунд до часа. Разбираю, где хватает модели за полцента, а где без фронтира не обойтись.
· 10 мин
TL;DR: Voice Standard Bench — открытый бенчмарк AssemblyAI, который сравнивает 52 LLM на голосовых задачах: саммари звонка, извлечение фактов, исправление транскрипта и диктовка. Главный вывод: почти везде хватает GPT-6 Luna, она отстаёт от лидеров на 1–3 балла и стоит около полуцента за час аудио. Маленькие открытые модели быстрее, но на записях длиннее двух минут сильно проседают.
Что такое Voice Standard Bench от AssemblyAI?
Голосовой продукт редко заканчивается на транскрипте. После распознавания речи текст почти всегда уходит в LLM: почистить диктовку, сделать саммари звонка, вытащить имя и номер заказа, набросать follow-up. В анонсе бенчмарка AssemblyAI пишет, что на больших объёмах этот шаг быстро становится заметной частью счёта. И часто за него платят по ценам фронтирных моделей там, где они не нужны.
Voice Standard Bench вышел 13 октября 2026 года. Он прогоняет весь каталог LLM Gateway. Это шлюз, через который по одному ключу AssemblyAI доступны модели OpenAI, Anthropic, Google и открытые LLM. Задач четыре:
- извлечение фактов: имена, даты, номера заказов в структурированный ответ;
- саммари разговора;
- исправление транскрипта без изменения смысла: убрать слова-паразиты и фальстарты, поправить пунктуацию;
- диктовка: превратить «запятая», «новый абзац» и другие голосовые команды в готовый текст.
Каждую задачу проверяют на записях четырёх длин: 30 секунд (голосовое сообщение), 2 минуты (короткий звонок), 15 минут (звонок в поддержку) и час (встреча). Диктовку гоняют только на двух коротких. На выходе у каждой модели три цифры: качество от 0 до 100, медианное время ответа и цена за час аудио. В цену входит только LLM-шаг: сколько стоит один раз обработать транскрипт часового разговора.
На 16 октября в рейтинге 52 модели, от крошечной Qwen3.5 4B до GPT-6 Astra и Claude Opus 5.5. Результаты открыты без регистрации, код лежит на GitHub под лицензией MIT.
Какую LLM брать под голосовую задачу?
AssemblyAI свела итог в короткую таблицу. Балл в ней средний по всем длинам записи. Самую дешёвую и самую быструю модель выбирают только среди тех, кто отстаёт от лидера не больше чем на 8 баллов. Иначе побеждала бы модель, которая дёшево и быстро выдаёт мусор.
| Задача | Лучшее качество | Дешевле всех | Быстрее всех |
|---|---|---|---|
| Саммари | Opus 5.5 (98) | GLM-5.3 Flash (91) | Gemini 4 Argon (93) |
| Извлечение фактов | Opus 5 (87) | GPT-6 Luna (86) | GPT-4.1 (79) |
| Исправление текста | GPT-5.6 Sol, GPT-6 Astra, GPT-6.1 Sol (91) | gemma-4-31b (84) | GPT-4.1 (84) |
| Диктовка | Gemini 4 Argon (100) | GLM-5.3 Flash (96) | GPT-4.1 (93) |
| Все задачи | GPT-6 Astra (92) | GPT-6 Luna (90) | GPT-4.1 (84) |
Данные AssemblyAI из анонса от 13 октября 2026.
Разрывы по качеству здесь маленькие. В извлечении фактов GPT-6 Luna отстаёт от Claude Opus 5 на балл, а в саммари GLM-5.3 Flash уступает Claude Opus 5.5 семь баллов при цене в десятки раз ниже. Ещё забавно, что самой быстрой из «годных» в четырёх строках из пяти оказалась GPT-4.1, модель 2025 года.
С чего начать, AssemblyAI советует решать по типу нагрузки. Если вытаскиваешь имена, даты или номера заказов из звонков на минуту-две, бери самые быстрые и дешёвые варианты: на такой длине отставание от больших моделей небольшое, а экономия на потоке звонков набегает быстро. Для саммари звонков поддержки на 2–15 минут сравни рекомендованную и бюджетную модель в колонке «15 минут» и прикинь, окупает ли разница в качестве разницу в цене на твоём объёме. Протоколы часовых встреч лучше сразу отдавать большой модели: неполное саммари длинной встречи потом дорого чинить руками.
Сколько стоит фронтирная модель в голосовых задачах?
По подсчёту AssemblyAI, лидер по качеству стоит в 15–77 раз дороже модели, которая отстаёт от него не больше чем на 2 балла. Только на часовых записях наценка сжимается примерно до 4 раз. На двухминутных звонках это выглядит так: восемь лучших моделей укладываются в 92–94 балла, а по цене расходятся в 76 раз.
| Модель | Качество | $ за час аудио | Медианный ответ |
|---|---|---|---|
| GPT-6 Luna | 92 | 0.005 | 2,4 с |
| GPT-5.6 Luna | 92 | 0.010 | 2,2 с |
| Gemini 4 Argon | 94 | 0.073 | 2,6 с |
| GPT-6.1 Sol | 93 | 0.091 | 6,8 с |
| GPT-5 | 93 | 0.186 | 17,8 с |
| Opus 5.5 | 93 | 0.267 | 5,4 с |
| Opus 5 | 93 | 0.324 | 5,0 с |
| GPT-6 Astra | 94 | 0.374 | 3,8 с |
Страница результатов: все задачи, записи по 2 минуты, данные на 16 октября 2026.
Обрати внимание на GPT-6 Luna. Она самая дешёвая в восьмёрке и отстаёт от лидеров на 2 балла. Секрет в тарифе: по каталогу LLM Gateway на 16 октября Luna стоит $0.10 за миллион входных токенов и $0.50 за миллион выходных, ровно как Qwen3.5 4B Fast на 4 миллиарда параметров. Поэтому открытые модели, как пишет AssemblyAI, редко выигрывают у неё по цене: экономят доли цента и на записях длиннее двух минут теряют от 10 баллов. Слабое место Luna в другом, это время ответа: 1,7 секунды на 30-секундной записи и 15–19 секунд на длинных.
Для масштаба: распознавание часа речи в стриминговой линейке AssemblyAI в июле стоило от $0.15 до $0.45, цены я разбирал в обзоре Universal-3.5. Opus 5.5 на одной задаче добавляет к этому ещё около $0.25 за час, GPT-6 Luna полцента. На тысячах часов звонков в месяц это уже статья бюджета.
Почему маленькие модели сдают на длинных записях?
На коротких записях открытые модели почти не уступают большим: gemma-4-31b на 30-секундных записях набирает 93 балла, Opus 5.5 — 95. Но чем длиннее запись, тем больше разрыв.
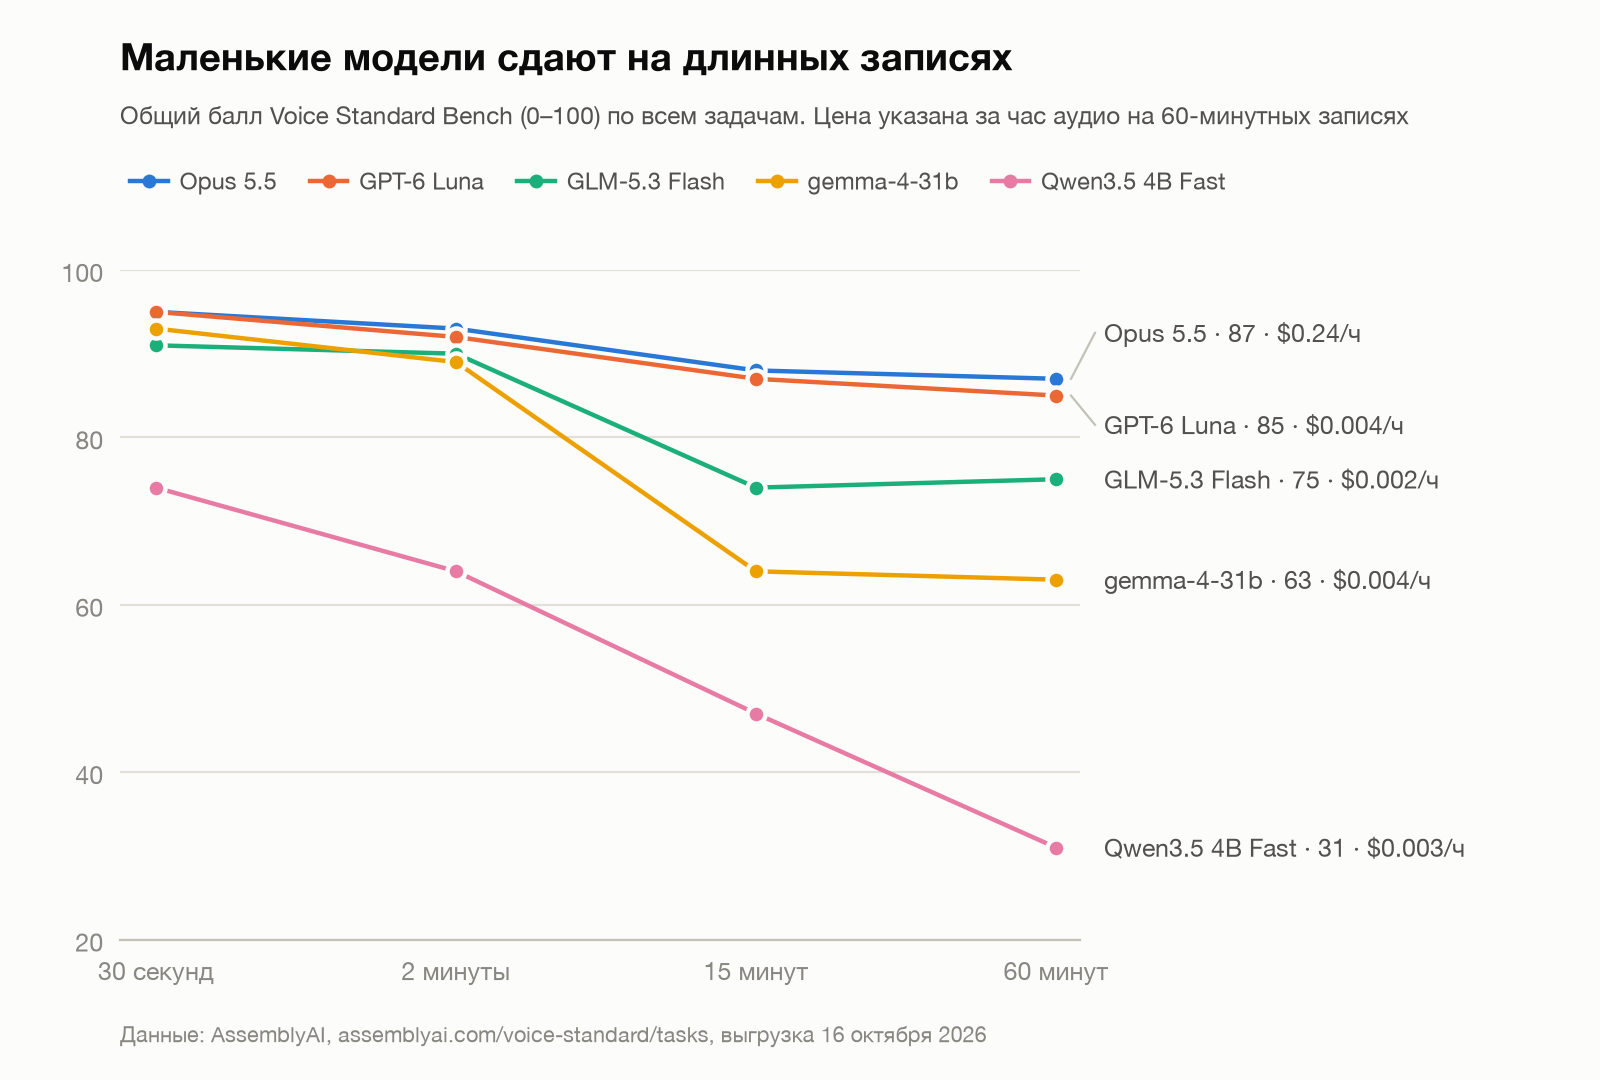
| Модель | 30 с | 2 мин | 15 мин | 60 мин | $ за час (60 мин) |
|---|---|---|---|---|---|
| Opus 5.5 | 95 | 93 | 88 | 87 | 0.240 |
| GPT-6 Luna | 95 | 92 | 87 | 85 | 0.004 |
| GLM-5.3 Flash | 91 | 90 | 74 | 75 | 0.002 |
| gemma-4-31b | 93 | 89 | 64 | 63 | 0.004 |
| Qwen3.5 4B Fast | 74 | 64 | 47 | 31 | 0.003 |
Страница результатов Voice Standard Bench, общий балл по всем задачам, данные на 16 октября 2026.
Сильнее всего маленькие модели проседают на извлечении фактов. У gemma-4-31b (подробнее о семействе в обзоре Gemma 4) оно падает с 88 баллов на 30 секундах до 24 на 15-минутных записях. Саммари держится лучше: та же gemma на часовой записи даёт 83. Размер окна тут ни при чём: у gemma-4-31b 256 тысяч токенов контекста, часовой разговор занимает в разы меньше. Похоже, пересказать общий смысл длинного текста маленькой модели проще, чем не потерять в нём конкретные имена и цифры.
Qwen3.5 4B Fast (про семейство писал в обзоре Qwen3.5) теряет 43 балла, с 74 до 31. А самый странный профиль у Nemotron Lightning 3.5 30B A3B, я разбирал её в обзоре Nemotron 3.5 Lightning. Она набирает 98 в саммари на 30 секундах и 100 в извлечении фактов на двухминутных звонках, но в исправлении текста получает 31, 27, 2 и 4 балла по длинам. И отвечает за 9–18 секунд, для модели с Lightning в названии это медленно. С таким разбросом её стоит проверить на своих данных, прежде чем ставить в прод.
У больших моделей падение мягче: Opus 5.5 и GPT-6 Luna теряют 8–10 баллов от 30 секунд до часа. На часовых встречах впереди GPT-6 Astra с 88 баллами, за ней Opus 5.5 и GPT-6.1 Sol с 87.
Какая LLM быстрее всех отвечает голосовому агенту?
Для голосового агента время ответа важнее пары баллов качества: человек на линии ждёт. Часть открытых моделей, например Qwen3.5 4B Fast, AssemblyAI запускает на собственных GPU. По её словам, те же семейства у других провайдеров отвечают за 10–20 секунд. На 30-секундных записях быстрее всех такие модели:
| Модель | Медианный ответ | Качество | $ за час аудио |
|---|---|---|---|
| Qwen3.5 4B Fast | 0,28 с | 74 | 0.003 |
| Gemini 2.5 Flash Lite | 0,70 с | 88 | 0.003 |
| GPT-4.1 | 0,85 с | 91 | 0.049 |
| gemma-4-31b | 0,88 с | 93 | 0.003 |
| Gemini 3.1 Flash Lite | 0,89 с | 90 | 0.008 |
| GPT-6 Luna | 1,69 с | 95 | 0.004 |
Страница результатов Voice Standard Bench, все задачи, записи по 30 секунд, данные на 16 октября 2026.
Для коротких реплик в реальном времени я бы смотрел на gemma-4-31b: меньше секунды на ответ, 93 балла и треть цента за час. На двухминутном звонке она отвечает за 1,5 секунды с 89 баллами, GPT-6 Luna — за 2,4 секунды с 92. Если нужна скорость при похожем качестве, посмотри ещё на Gemini 3.1 Flash Lite и старую GPT-4.1.
На другом краю модели, которые для живого диалога не годятся. Kimi K3 думает 13,7 секунды над 30-секундной записью и 140 секунд над часовой, Grok 4.7 — 15 и 200 секунд. DeepSeek V4.1 Flash тоже медленная: от 6 секунд на коротких записях до полутора минут на длинных. Зато в саммари часовых встреч у неё лучший балл в рейтинге, 96, и цена около цента за час. Для ночной пакетной обработки записей это находка. Про линейку V4 я писал в обзоре DeepSeek V4 Pro.
Насколько можно доверять Voice Standard Bench?
Бенчмарк сделан аккуратно, но четыре вещи я бы держал в голове.
Выборка маленькая. По методологии на каждую задачу и длину берут 10 транскриптов, для диктовки 20. Причём записи для диктовки синтетические, их сгенерировала LLM.
Оценки ставят LLM. Два судьи, Claude Opus 5.5 и GPT-5.6 Sol, проверяют ответы по рубрике и сверяют их с исходным транскриптом, эталонного ответа нет. У подхода LLM-as-a-judge известные перекосы. Например, модель склонна хвалить ответы своего семейства, это разбирали ещё в работе Zheng et al., 2023. AssemblyAI этот эффект замерила: каждый судья подсуживает моделям своей компании меньше чем на 0,5 балла. При этом судья Claude в среднем ставит на 4 балла ниже, чем GPT-5.6 Sol, так что абсолютные цифры зависят от судьи. Итоговый балл считают по обоим.
Язык неизвестен. Транскрипты взяты из реальных звонков, которые обработала AssemblyAI, так написано в README. Но язык, тематику и акценты компания не раскрывает, так что на русские звонки я бы рейтинг вслепую не переносил.
Бенчмарк вендорский. AssemblyAI меряет модели в собственном шлюзе: цены взяты из тарифов LLM Gateway (компания заявляет, что это цены провайдеров без наценки), задержки замерены через её инфраструктуру. Бенчмарк заодно работает витриной Gateway, и по тексту анонса это видно.
Из хорошего: кроме баллов, бенчмарк считает отказы, таймауты, ошибки и ответы в неправильном формате. Модели, которые не прошли проверку надёжности, остаются на графиках, но в рекомендации не попадают.
Как прогнать Voice Standard Bench на своих транскриптах?
AssemblyAI прямо пишет, что её транскрипты не твои: у твоих клиентов другие акценты, в твоём домене своя лексика, да и промпты ты пишешь по-своему. Поэтому рейтинг годится для шорт-листа из двух-трёх моделей, а выбирать стоит на своих данных. Способов три.
Быстрее всего проверить в режиме Compare в Playground. Загружаешь запись, получаешь транскрипт и отправляешь один промпт сразу нескольким моделям. Над каждым ответом видно время, токены и стоимость. На странице результатов у рекомендаций есть ссылка «Try in Gateway», она открывает Playground с нужной моделью и промптом задачи.
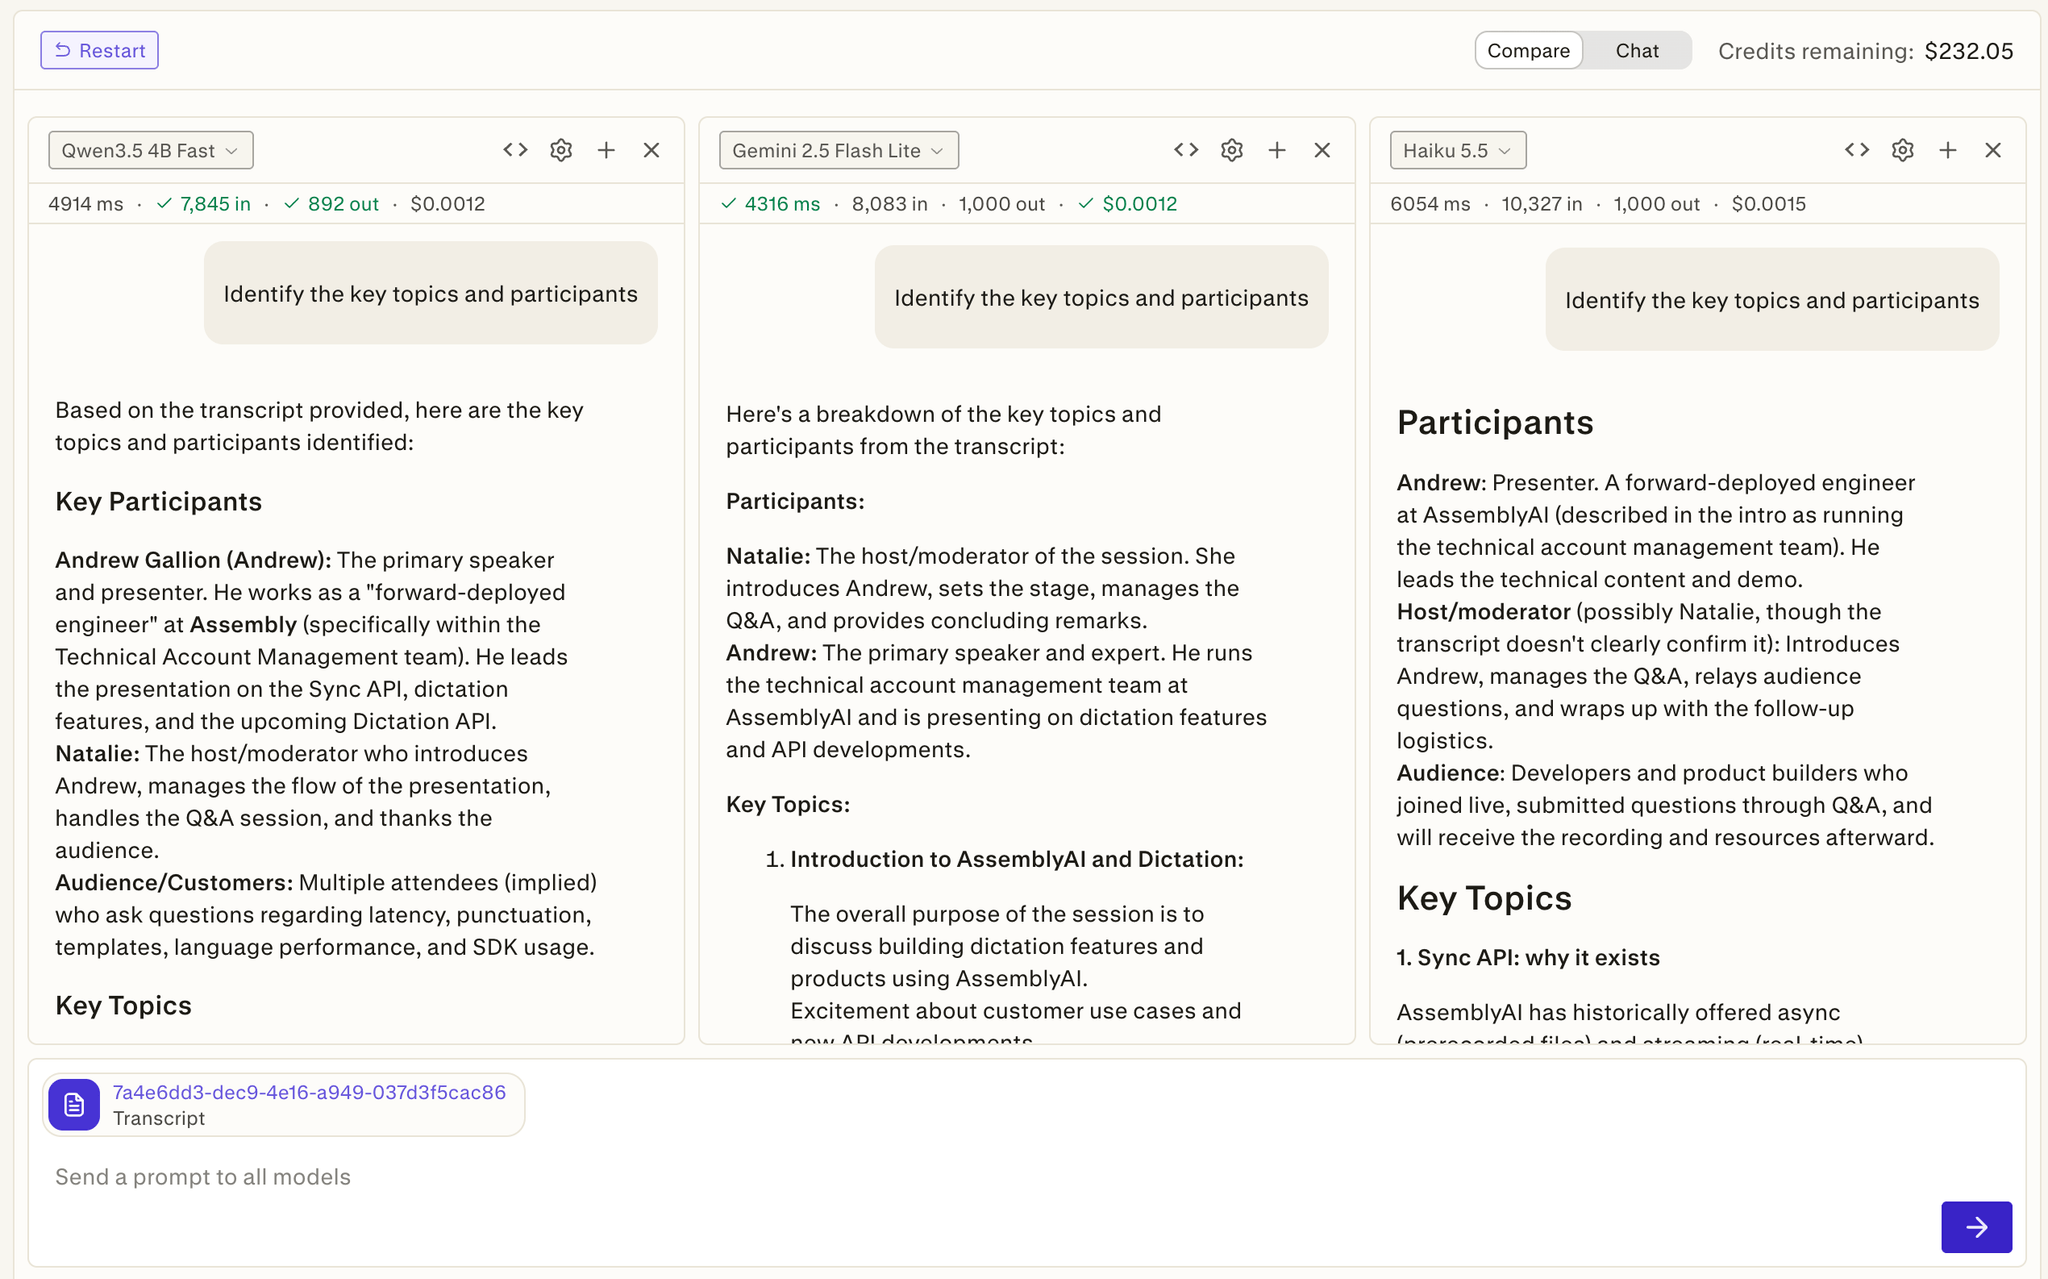
Второй способ: API LLM Gateway. Формат запросов как у OpenAI Chat Completions, так что модель меняется одним параметром. Вот сравнение трёх кандидатов на одном транскрипте:
import requests

API_KEY = "YOUR_ASSEMBLYAI_API_KEY"
transcript = open("call.txt", encoding="utf-8").read()  # текст из Speech-to-Text

for model in ["gpt-6-luna", "gemma-4-31b", "claude-opus-5-5"]:
    response = requests.post(
        "https://llm-gateway.assemblyai.com/v1/chat/completions",
        headers={"authorization": API_KEY},
        json={
            "model": model,
            "messages": [
                {"role": "user", "content": f"Сделай саммари звонка в пяти пунктах:\n\n{transcript}"}
            ],
        },
        timeout=120,
    )
    print(model, response.json()["choices"][0]["message"]["content"], sep="\n")
Третий способ: полный прогон бенчмарка. Это CLI на Go: ключ задаёшь в переменной окружения, свои транскрипты кладёшь в normalized/<задача>/aai_transcripts.jsonl в корне репозитория и запускаешь:
git clone https://github.com/AssemblyAI/voice-standard-bench
cd voice-standard-bench/src
export ASSEMBLY_AI_TOKEN=...
go run . -models gpt-6-luna,gemma-4-31b -tasks summarization -buckets 900s
По умолчанию судья один, claude-opus-5, поменять его можно флагом -judge-model. Шлюз пускает 30 запросов в минуту на модель, поэтому полный прогон по всем моделям займёт время, а вызовы судьи тоже стоят денег. Флаг -skip-judge собирает ответы без оценки, а -replay потом оценивает их без повторных вызовов моделей.
Стоит ли платить за фронтир в голосовых задачах?
Мне Voice Standard Bench нравится тем, что показывает качество, скорость и цену сразу и режет их по длине записи. Обычные лидерборды так не делают, а для голосовых продуктов длина записи меняет выбор модели сильнее, чем бренд. Вывод у меня простой. Для коротких звонков и диктовки фронтир не нужен, gemma-4-31b или GPT-6 Luna закрывают задачу за доли цента. Для часовых встреч разница уже заметна, и тут я бы смотрел на GPT-6.1 Sol: она отстаёт от GPT-6 Astra на балл и стоит вчетверо дешевле.
Минусы тоже есть: бенчмарк вендорский, транскриптов по десять на ячейку, язык неизвестен. Как готовый ответ я бы его не брал. Как способ за полчаса собрать шорт-лист из трёх моделей и прогнать их на своих звонках — вполне. Тем более что код открыт, для вендорских бенчмарков это редкость.
FAQ
Входит ли распознавание речи в цену за час из Voice Standard Bench? Нет. В цену за час входит только LLM-шаг: сколько стоит один раз обработать транскрипт часовой записи. Это оценка по среднему числу токенов, у быстро говорящих людей реальная цена будет выше. Если на каждый звонок у тебя саммари, извлечение фактов и чистка текста, умножай на три.
Нужен ли аккаунт AssemblyAI, чтобы смотреть результаты? Нет, страница результатов открыта без регистрации. На ней есть фильтры по задаче и длине записи и сравнение трёх моделей бок о бок. Ключ AssemblyAI нужен, только чтобы вызывать модели через LLM Gateway или запускать open-source версию бенчмарка на своих данных.
Можно ли добавить в сравнение модель, которой нет в LLM Gateway? Из коробки нет. Бенчмарк берёт список кандидатов из каталога LLM Gateway и вызывает модели через этот шлюз, поэтому свою модель или модель другого провайдера придётся подключать правкой кода. На 16 октября в каталоге 53 модели, новые AssemblyAI добавляет по мере выхода.
Как часто обновляется рейтинг Voice Standard Bench? Новые модели попадают в рейтинг, когда появляются в LLM Gateway, а у каждого прогона на странице результатов стоит дата. Рекомендации пересчитываются вместе с прогоном, поэтому цифры в этой статье зафиксированы на 16 октября 2026. Свежий пример: Gemini 4 Argon, которая сейчас лучше всех в диктовке.
Что ещё почитать
- AssemblyAI Universal-3.5: распознавание речи для агентов — шаг до LLM: стриминговое распознавание от той же AssemblyAI
- Claude Opus 5.5: обзор модели уровня Fable дешевле Opus 5 — лидер Voice Standard Bench в саммари и один из двух судей
- GPT-6 Astra: обзор модели OpenAI — лучший общий балл в бенчмарке и самая дорогая модель восьмёрки
- Soniox v5 Real-Time: распознавание речи для агентов — альтернатива AssemblyAI на этапе распознавания