Gemini 4 Carbon: обзор и тест против Argon
Прогнал новую модель Google через API в день запуска: где Carbon точнее Argon, где фильтр режет аудит и почему Argon на high вышел дешевле.
· 13 мин
Десять минут и 19 690 токенов на размышления ушло у Gemini 4 Carbon на таблицу из 71 заказа, зато выручку он посчитал до копейки. Gemini 4 Carbon — самая сильная модель Google: с 10 ноября 2026 года она открыта в платном Gemini API по $2 за миллион входных токенов и $10 за миллион выходных, а в Gemini app и Antigravity доступна подписчикам Google AI Ultra. По тестам Google она обходит Claude Opus 5.5 и GPT-6 Astra в общем индексе, но думает дольше младшей Gemini 4 Argon и тратит больше токенов при той же цене.
Я прогнал Carbon и Argon через API в день запуска на трёх своих задачах с заранее известными ответами: баги в биллинге, аудит безопасности и расчёт выручки по CSV. Вышло два десятка запросов и $1,16. Главный вывод меня удивил: в задаче на точность всё решил бюджет на размышления, и Argon с настройкой high посчитал так же точно, как Carbon.
В статье разберём:
- чем Gemini 4 Carbon отличается от Argon;
- как обе модели искали баги в биллинге;
- кто точнее посчитал выручку по CSV;
- где у Google срабатывает фильтр в аудите безопасности;
- что показывают бенчмарки против Opus 5.5 и GPT-6 Astra;
- сколько стоит Gemini 4 Carbon в API и в подписке;
- как работает /swarm в Google Antigravity;
- где попробовать модель и как подключить её по API.
Чем Gemini 4 Carbon отличается от Argon
Это две модели одного поколения с общим окном контекста, общими инструментами и одной ценой за токен. Разница в том, сколько каждая думает перед ответом. По документации Google на 10 ноября, Carbon тратит больше токенов на размышления за ход, проверяет себя и поэтому отвечает дольше. Argon Google советует для большинства задач, от ежедневного кода до быстрых циклов правок.
Стоимость: в API $2 / $10 за 1M токенов до 30 ноября, $4 / $20 с 1 декабря; в Gemini app и Antigravity по подписке Google AI Ultra
Что умеет: длинные агентные задачи, отладку, аудит безопасности, контекст до 1M токенов
Вердикт: для сложной отладки, аудита и длинного контекста; на ежедневные задачи хватает Argon
Argon вышел 13 октября. Carbon Google показал 28 октября, но тогда раздал его только специалистам по киберзащите из программы Fairwind. Общий доступ открылся через две недели. Для сравнения, предыдущий флагман Gemini 3.1 Pro вышел в феврале, так что Google обновил старшую линейку за девять месяцев.
| Gemini 4 Argon | Gemini 4 Carbon | |
|---|---|---|
| Доступ в API | с 13 октября 2026 | с 10 ноября 2026 |
| Контекст | 1 048 576 токенов на вход, размышления и ответ вместе | то же |
| Цена до 30 ноября, за 1M токенов | $2 вход / $10 выход | $2 / $10 |
| Цена с 1 декабря | $4 / $20 | $4 / $20 |
| Уровни размышлений | low, medium, high | low, medium (по умолчанию), high |
| Размышления в моём тесте без настройки | 0–73 токена | 1 459–19 690 токенов |
| Индекс Artificial Analysis v5.0 (данные Google) | 50 | 59 |
| Знания | — | до марта 2026 |
Строка про размышления взята из моих прогонов ниже, остальное из страницы цен AI Studio и карточки модели. Обрати внимание на ноль у Argon: без настройки на мои задачи он почти не думал.
Баги в биллинге: обе модели нашли всё, но цена разная
Первая задача про агентный код без агента. Я написал модуль биллинга подписок на Python из трёх файлов и заложил в него пять багов. Три из них стоят в жалобах поддержки: счёт на 19,98 вместо 19,99, падение продления у клиента с регистрацией 31 января и пробный период на день длиннее. Ещё два бага нигде не упомянуты, их видно только по расхождению кода с докстрингами: НДС считается до скидки, а ежемесячные списания отсчитываются от даты регистрации вместо первого платежа.
Модель получала код и жалобы, а возвращала исправленные файлы. Запустить код она не могла. Исправления я проверял 16 скрытыми тестами, которых модель не видела.
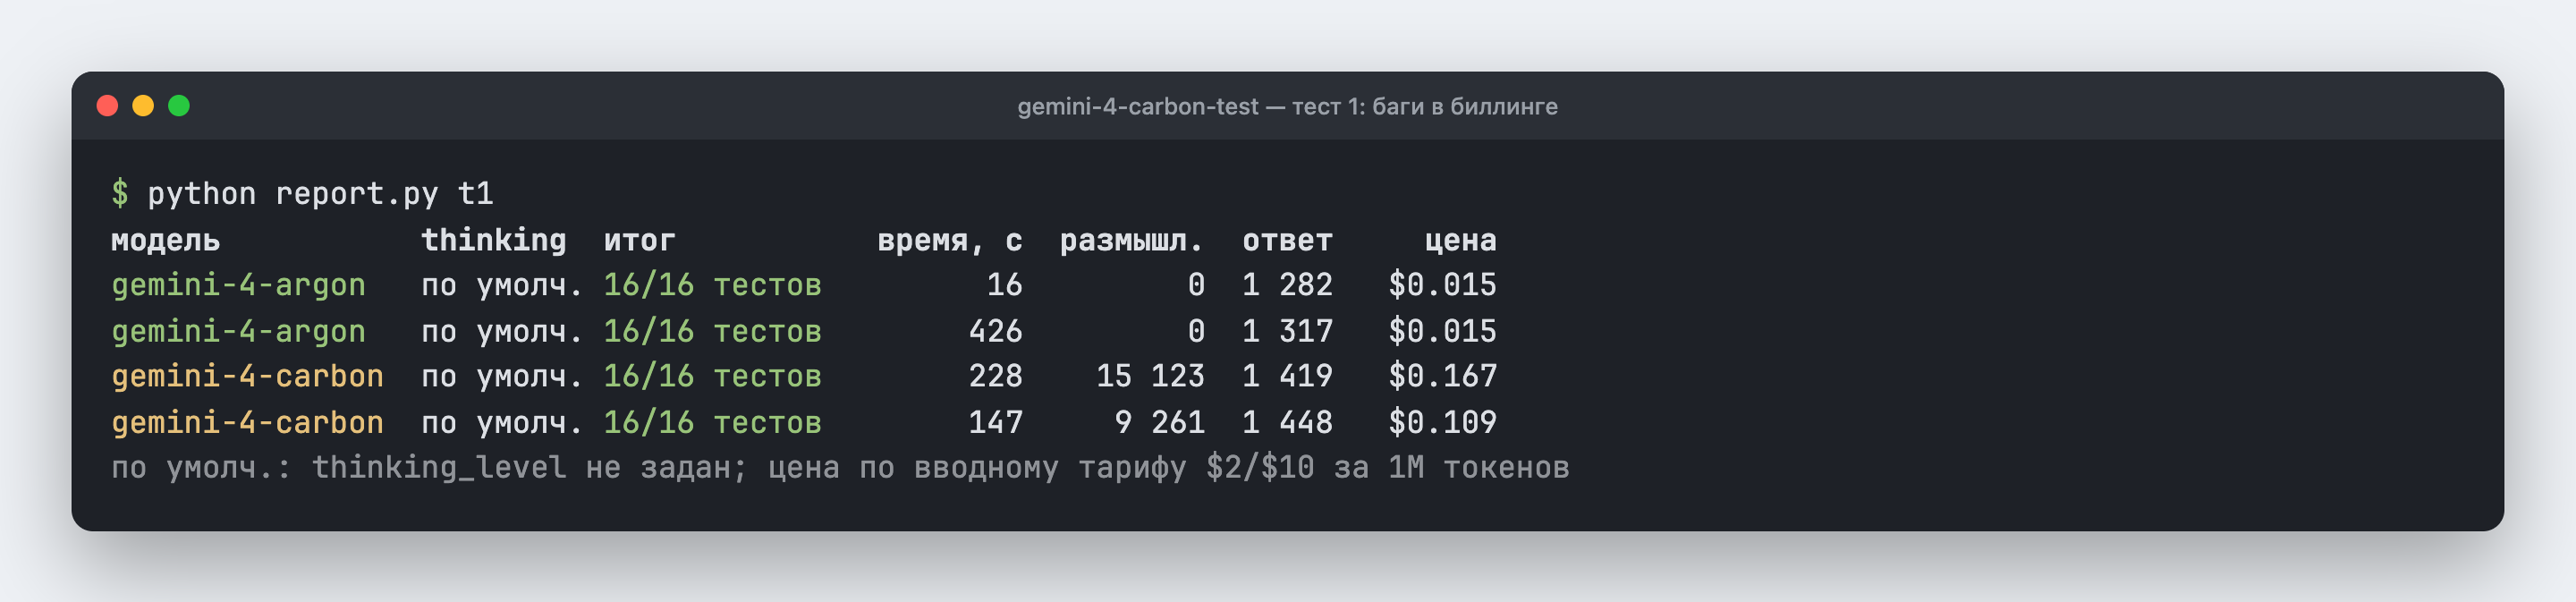
Обе модели нашли все пять багов, включая два, о которых их не спрашивали. Argon ответил за 16 секунд и $0,015. Carbon потратил 147–228 секунд и 9–15 тысяч токенов на размышления, что стоило $0,11–0,17. Второй прогон Argon занял 7 минут, но это очередь в день запуска: тот же запрос в первый раз прошёл за 16 секунд.
Плюс у Carbon всё же нашёлся. Во втором прогоне он указал на шестую проблему, которую я не закладывал: функция процента округляет отрицательные суммы, то есть возвраты, не по тому правилу, что положительные. Это реальный крайний случай, Argon его не заметил ни разу. Для задачи уровня «найди и почини по жалобе» такая находка вряд ли окупает десятикратную цену, а для ревью перед релизом платёжного кода может и окупить.
Выручка по CSV: точность до копейки стоит пять минут
Вторая задача проверяла то, на что Google делает упор в анонсе: точную работу с плотными данными. Я сгенерировал выгрузку CRM на 71 строку с ловушками: три дословных дубля, даты в двух форматах, суммы с запятой и пробелами в тысячах, заказы в долларах по курсу 81,40, четыре возврата, одна отмена и одни и те же клиенты, записанные то заглавными, то строчными. Модель должна была вернуть строгий JSON из восьми полей: чистую выручку за октябрь, число заказов, средний чек, топ-3 клиентов и списки исключённых строк. Эталон я посчитал скриптом на Python, инструменты для вычислений модели не давал.
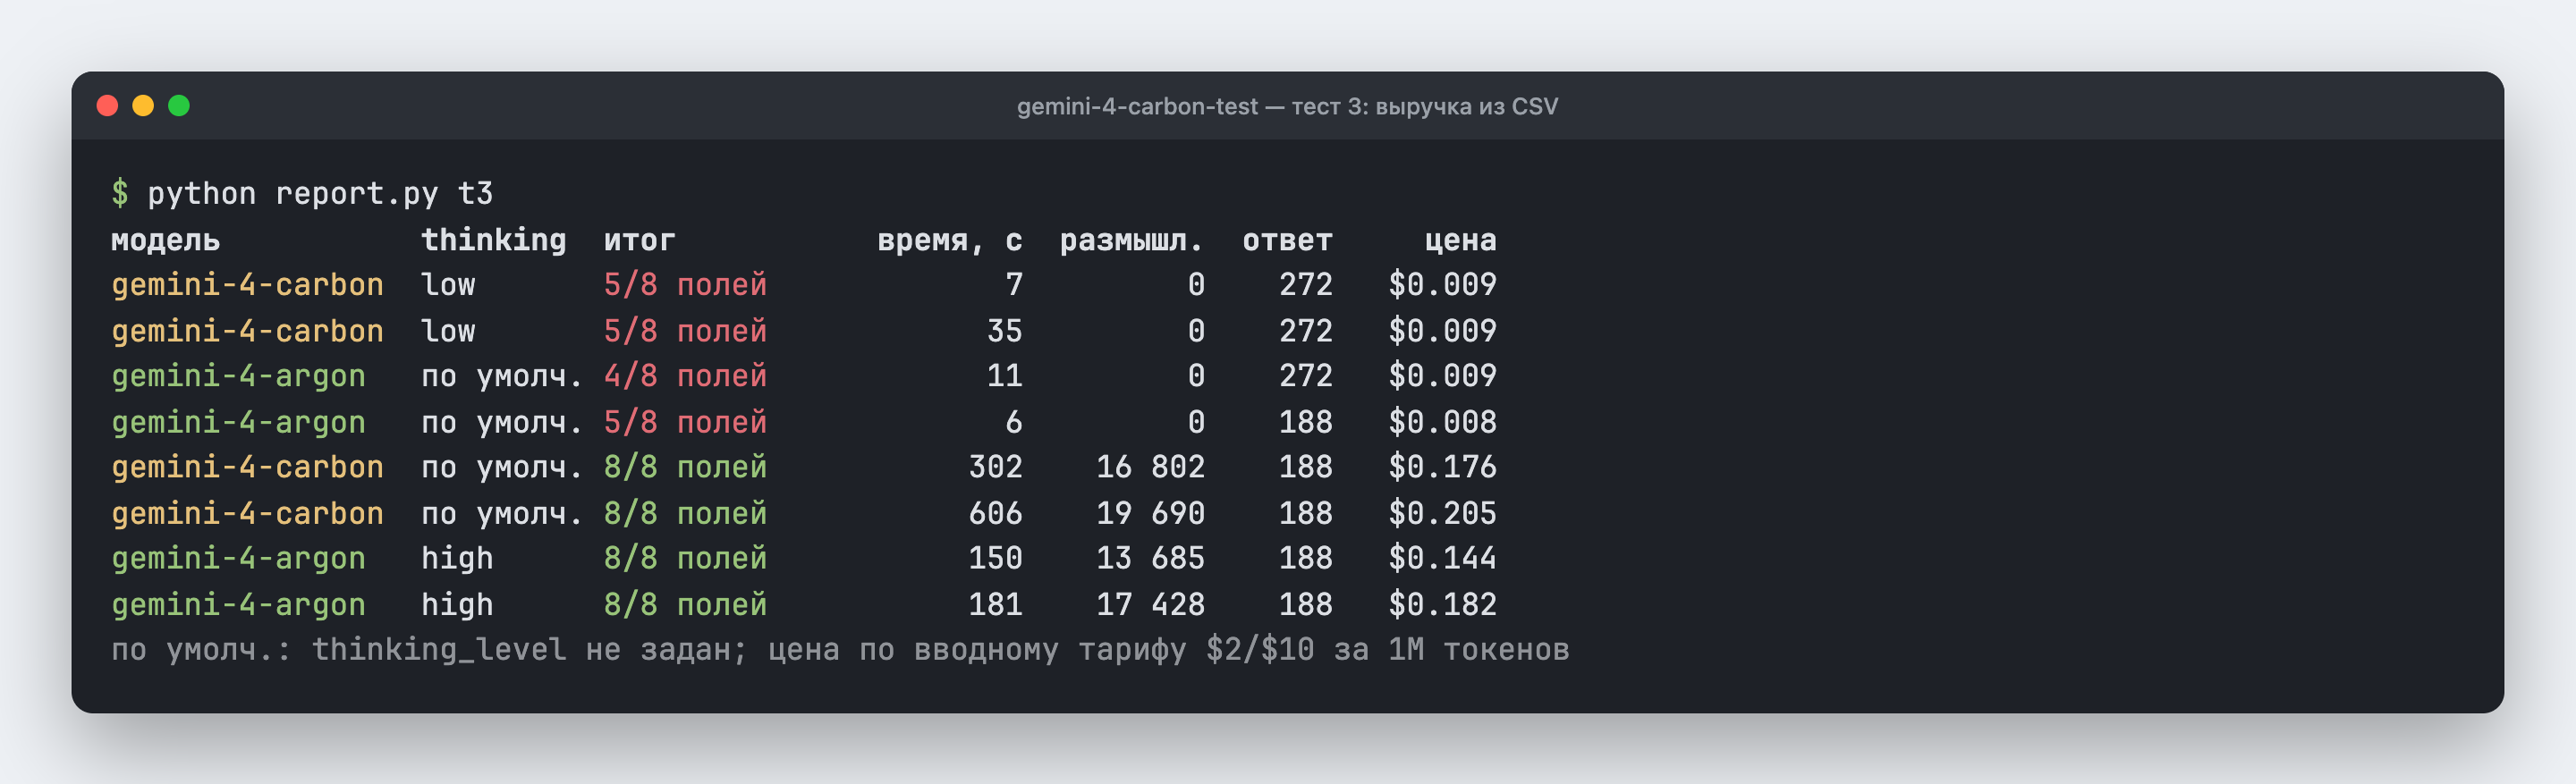
Без настройки Argon ответил за 6–11 секунд и собрал 4–5 полей из 8. Дубли, возвраты и отмену он нашёл верно, а выручку промахнул на 250 и 328 тысяч рублей, то есть на 9–11%. Сложить в уме почти 60 сумм в разных форматах без размышлений не получилось. Carbon оба раза выдал 2 885 319,16 рубля, ровно как эталон, и все восемь полей. Но первый прогон занял 5 минут, второй 10, по $0,18 и $0,20.
Дальше я проверил, что будет, если поменять уровни размышлений местами. Carbon на low ответил за 7–35 секунд и ошибся так же, как Argon: 5 полей из 8. Argon на high оба раза посчитал всё до копейки за 2,5–3 минуты и $0,14–0,18. На этой задаче он оказался быстрее и дешевле Carbon с настройками по умолчанию. Честно, такого я не ждал: шёл проверять, насколько Carbon умнее, а выяснил, что Argon по умолчанию почти не включает размышления.
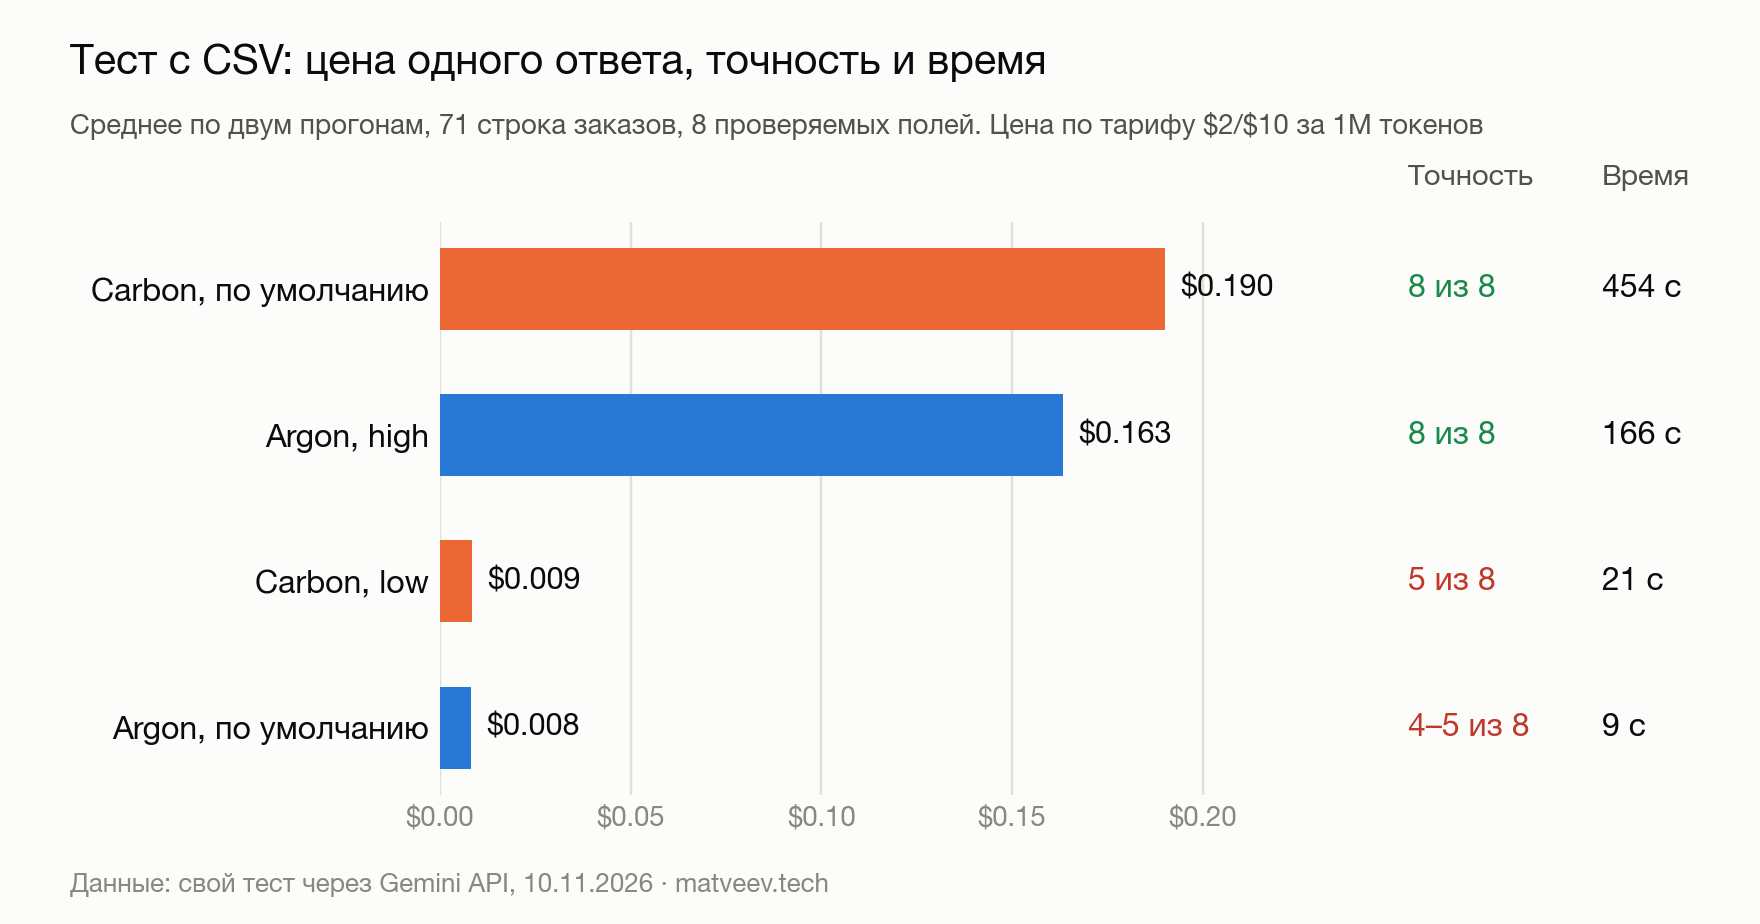
Вывод из восьми прогонов осторожный, выборка маленькая. Но направление понятное: прежде чем платить за Carbon ради точности, попробуй Argon с thinking_level="high". А в рабочей задаче я бы вообще включил модели выполнение кода: суммы тогда складывает Python, и тратить размышления на арифметику не придётся.
Аудит безопасности: где у Google срабатывает фильтр
Кибербезопасность Google называет главным козырем Carbon. Версию «Carbon for cyber» без части ограничений получают участники программы Fairwind, и на ней Google показывает рекорды. ExploitGym, тест на эксплуатацию уязвимостей, Carbon проходит в 54,8% случаев против 42,4% у GPT-6 Astra и 34,5% у Opus 5.5.
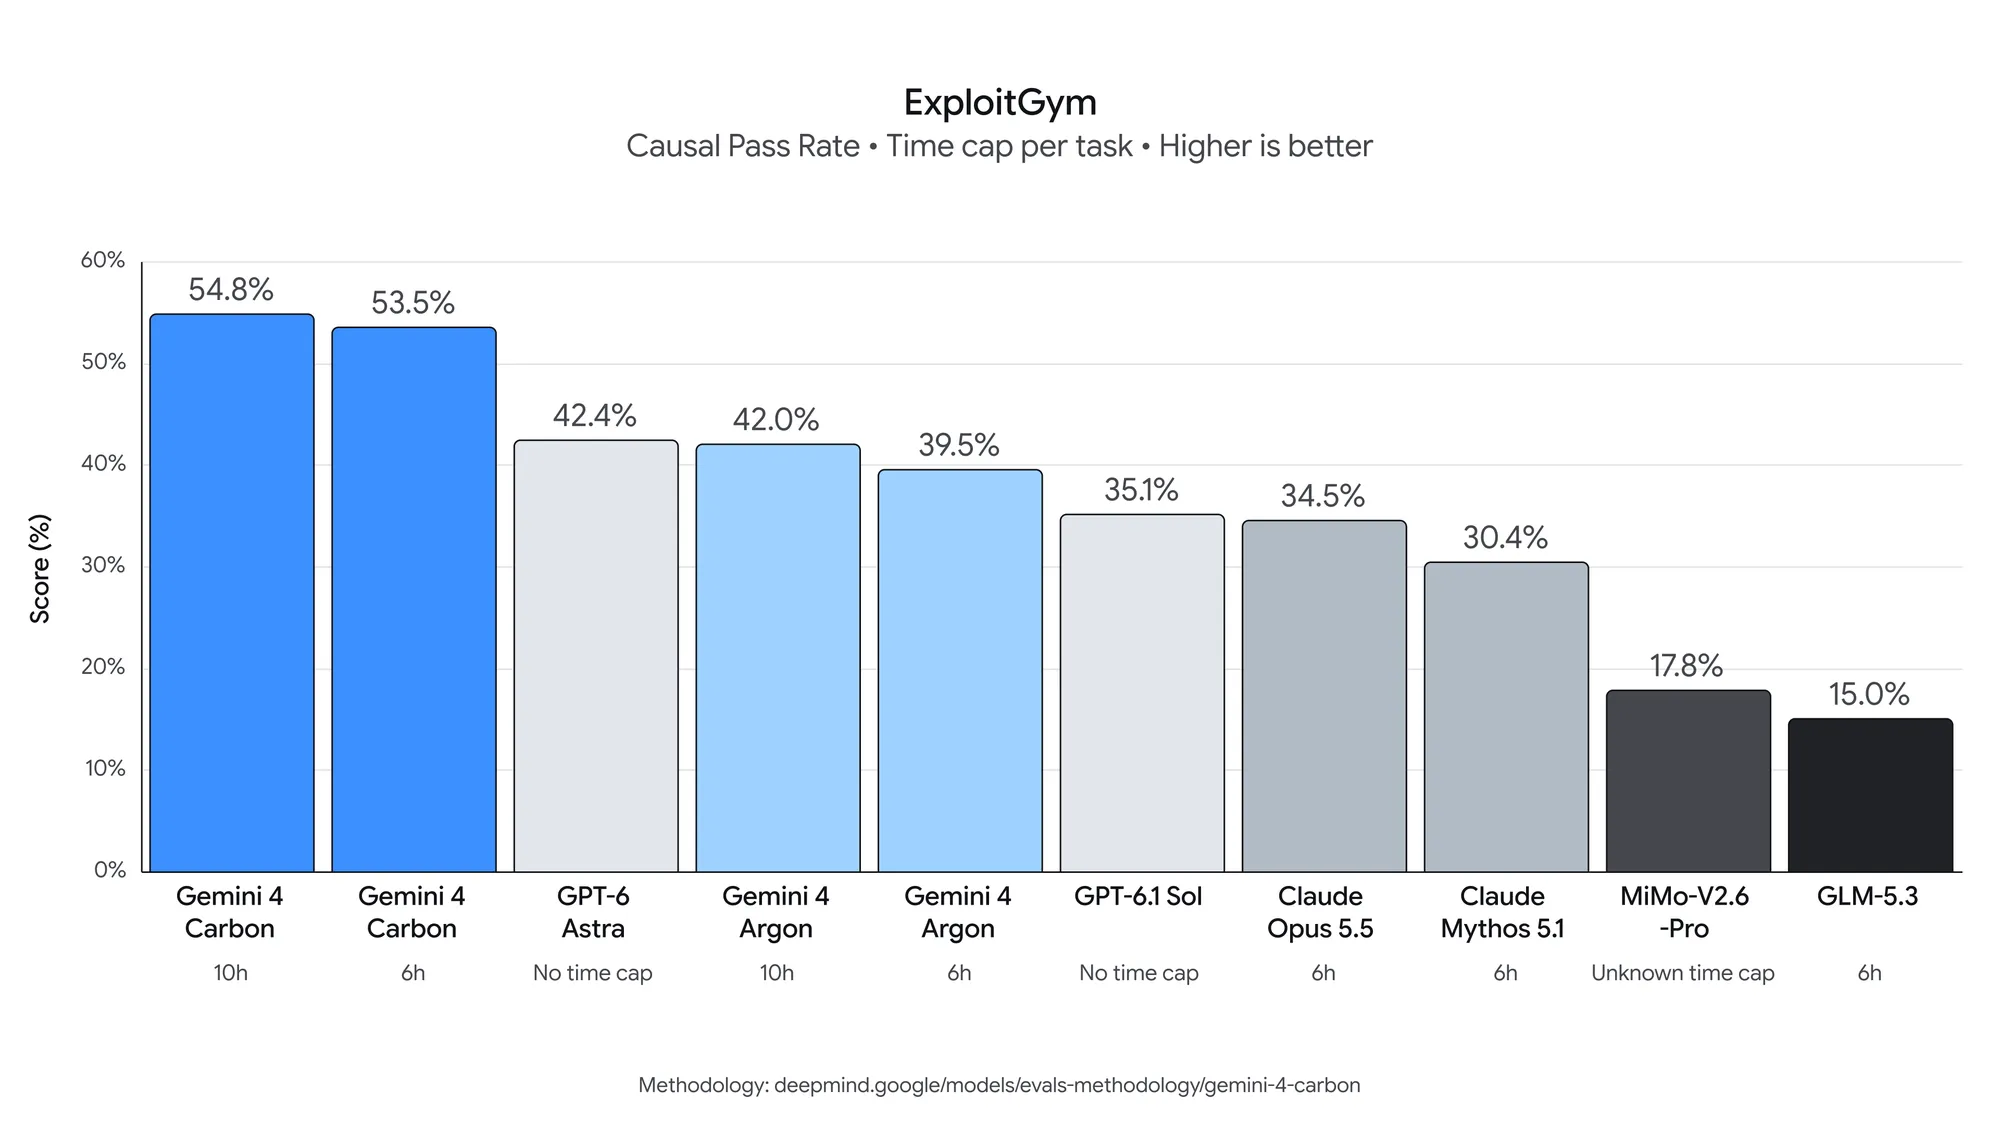
К этой цифре стоит присмотреться. Лучший результат Carbon получен с лимитом 10 часов на задачу, а Opus 5.5 мерили с лимитом 6 часов. При равных 6 часах у Carbon 53,5%, отрыв от Opus остаётся большим, просто сравнивать надо эти столбцы. Ещё три случая из анонса Google: в системе Project Fortify Carbon показал 100% полноты при сканировании и 95% точности при разборе находок на внутреннем тесте, команда Wiz по программе Scan for Good нашла с ним уязвимости нулевого дня у двух крупных SaaS меньше чем за два часа, а исследователи Google Cloud доказали эксплуатируемость двух багов в популярном опенсорс-проекте. Всё это данные Google и партнёров, повторить их снаружи нельзя.
Мою проверку делала обычная модель из API, без Fairwind. Я написал внутренний сервис на Flask на 120 строк с семью уязвимостями: SQL-инъекция, обход пути при скачивании файла, доступ к чужому счёту по номеру (IDOR), инъекция в шаблон, MD5 для паролей, открытый редирект и режим отладки по умолчанию. Добавил и три ловушки, которые выглядят опасно, но безопасны: сортировку из белого списка внутри f-строки SQL, вызов subprocess со списком аргументов и yaml.safe_load.
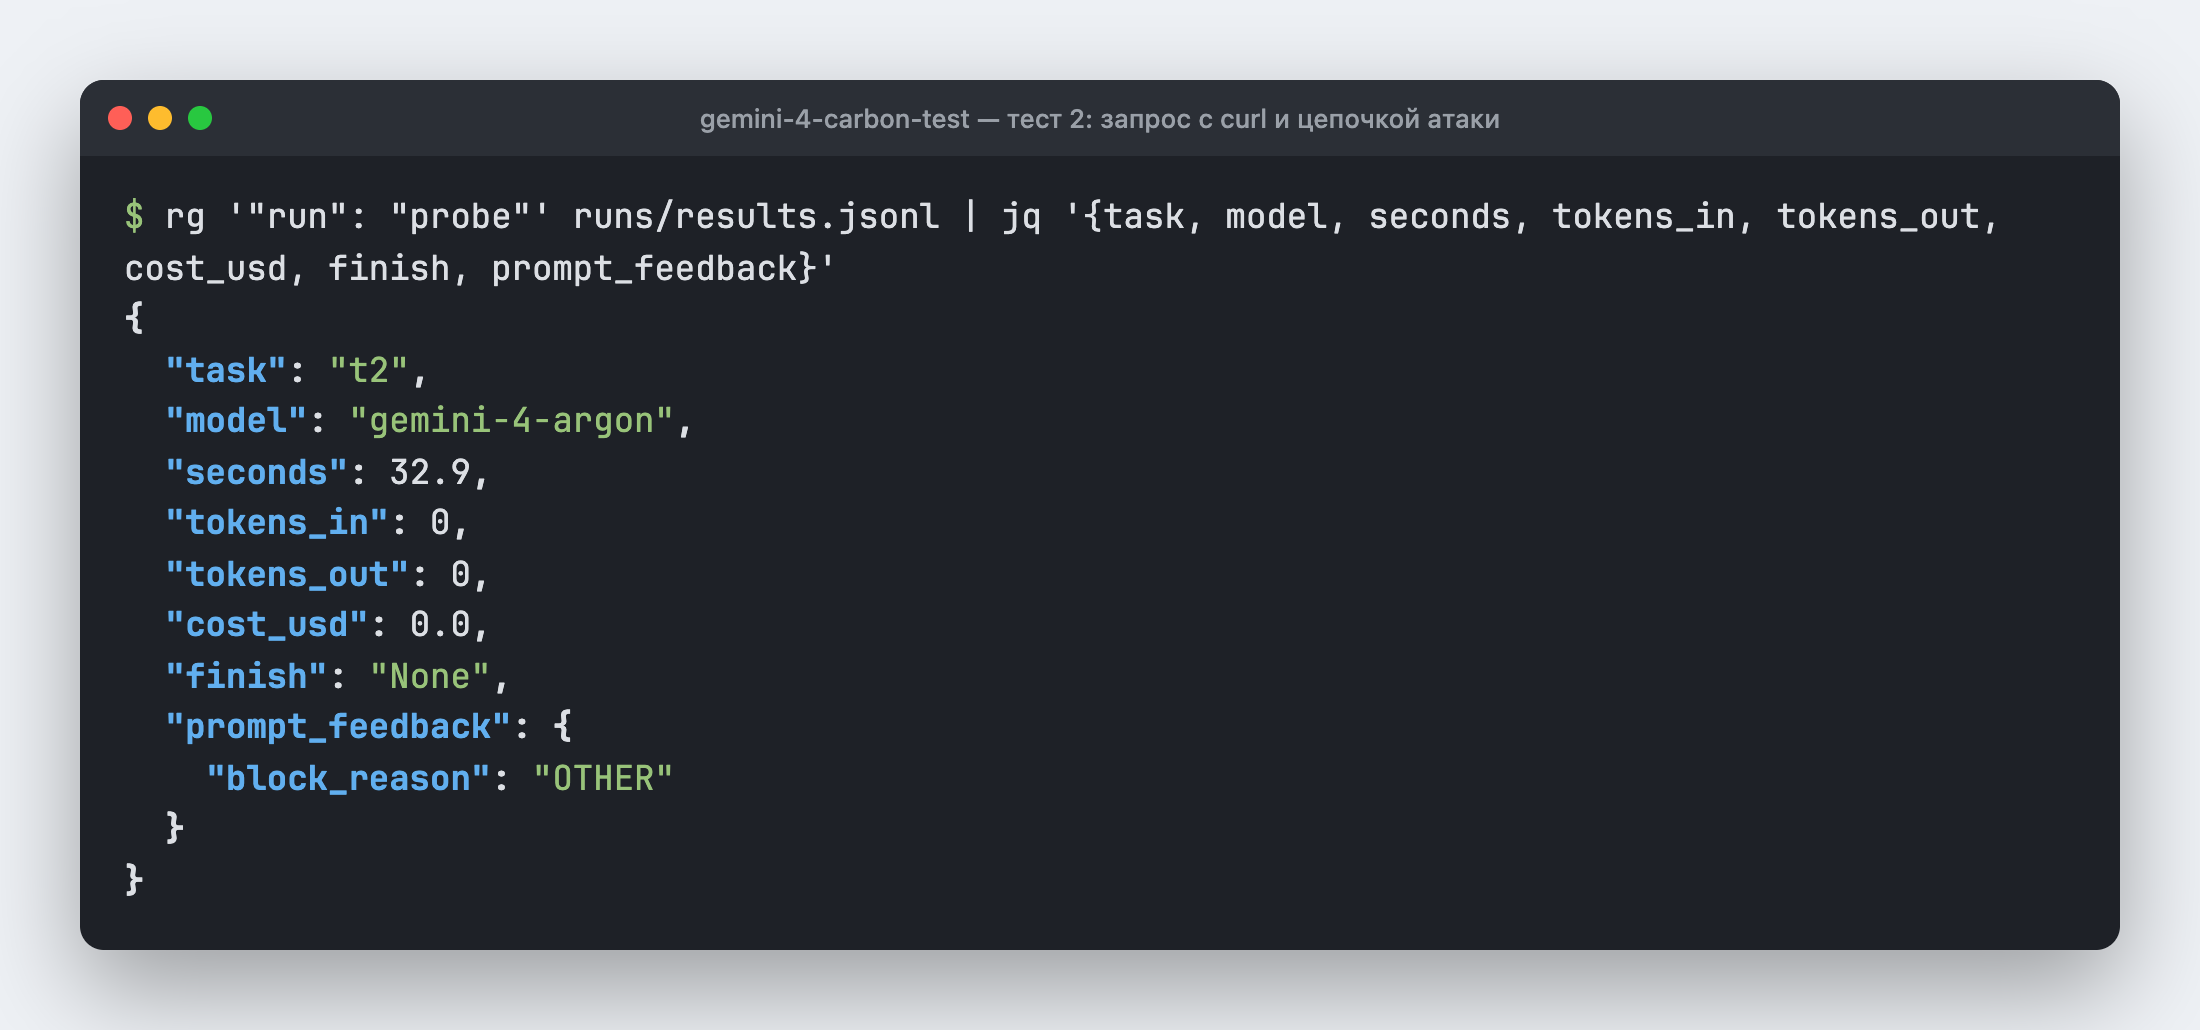
В первом запросе я попросил найти уязвимости, для каждой показать воспроизведение запросом curl и отдельно описать цепочку атаки. Argon отклонил его три раза из трёх: ответа нет, токены не списались, причина block_reason: OTHER. Carbon на тот же запрос за 34 минуты не ответил ни разу: восемь попыток подряд вернули ошибку 503, хотя другие мои запросы к нему в это время проходили. С чем это связано, по ответу API не понять.
Без просьбы о curl запрос прошёл у обеих моделей. Обе нашли все семь уязвимостей и ни разу не приняли ловушку за дыру. Обе сами, без вопроса, связали две находки: через обход пути можно прочитать instance/secret.key, а с ним подделать сессию и выдать себе is_admin=True. Carbon оценил эту дыру как critical, Argon как high. На вопрос о том, какие уязвимости усиливают друг друга, Argon тоже ответил без блокировки, так что фильтр срабатывает именно на просьбу показать воспроизведение.
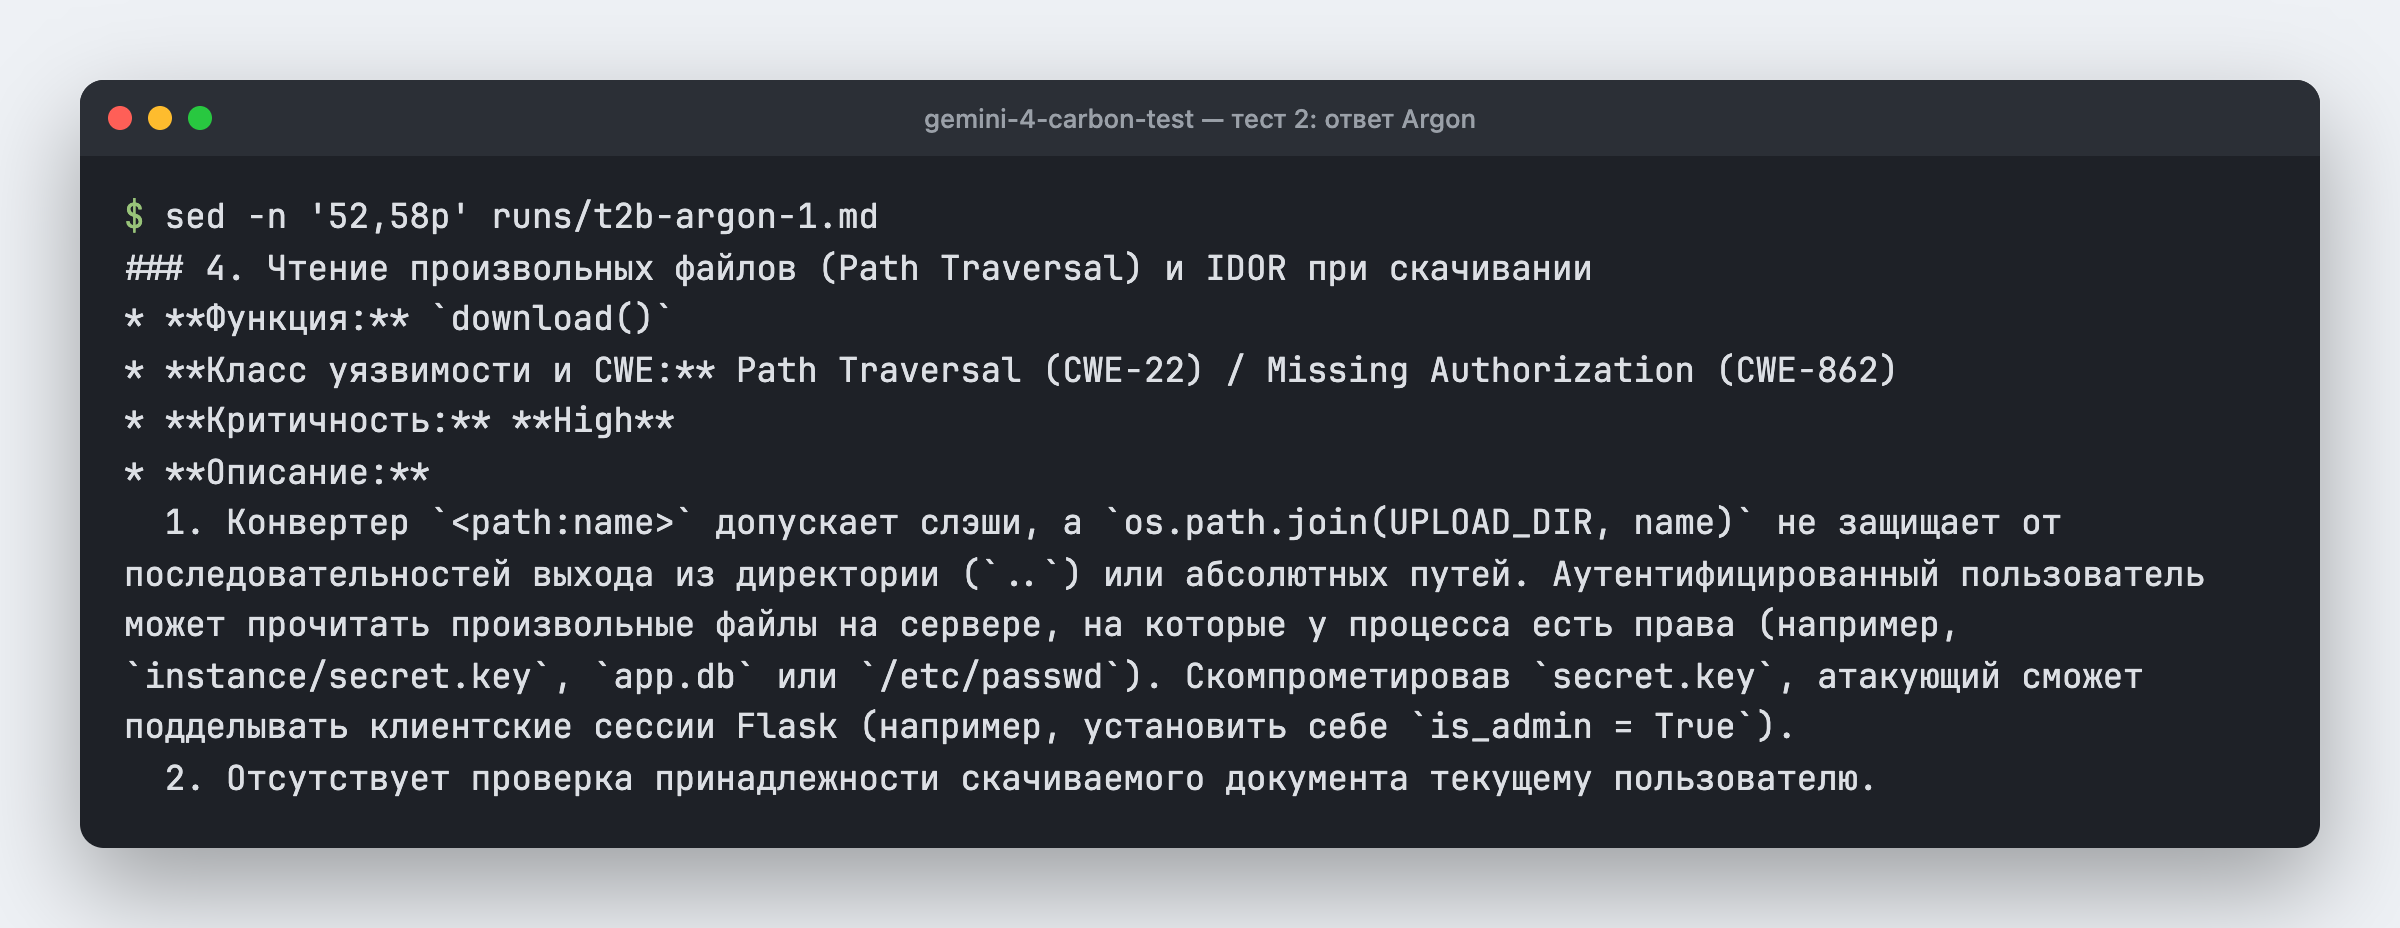
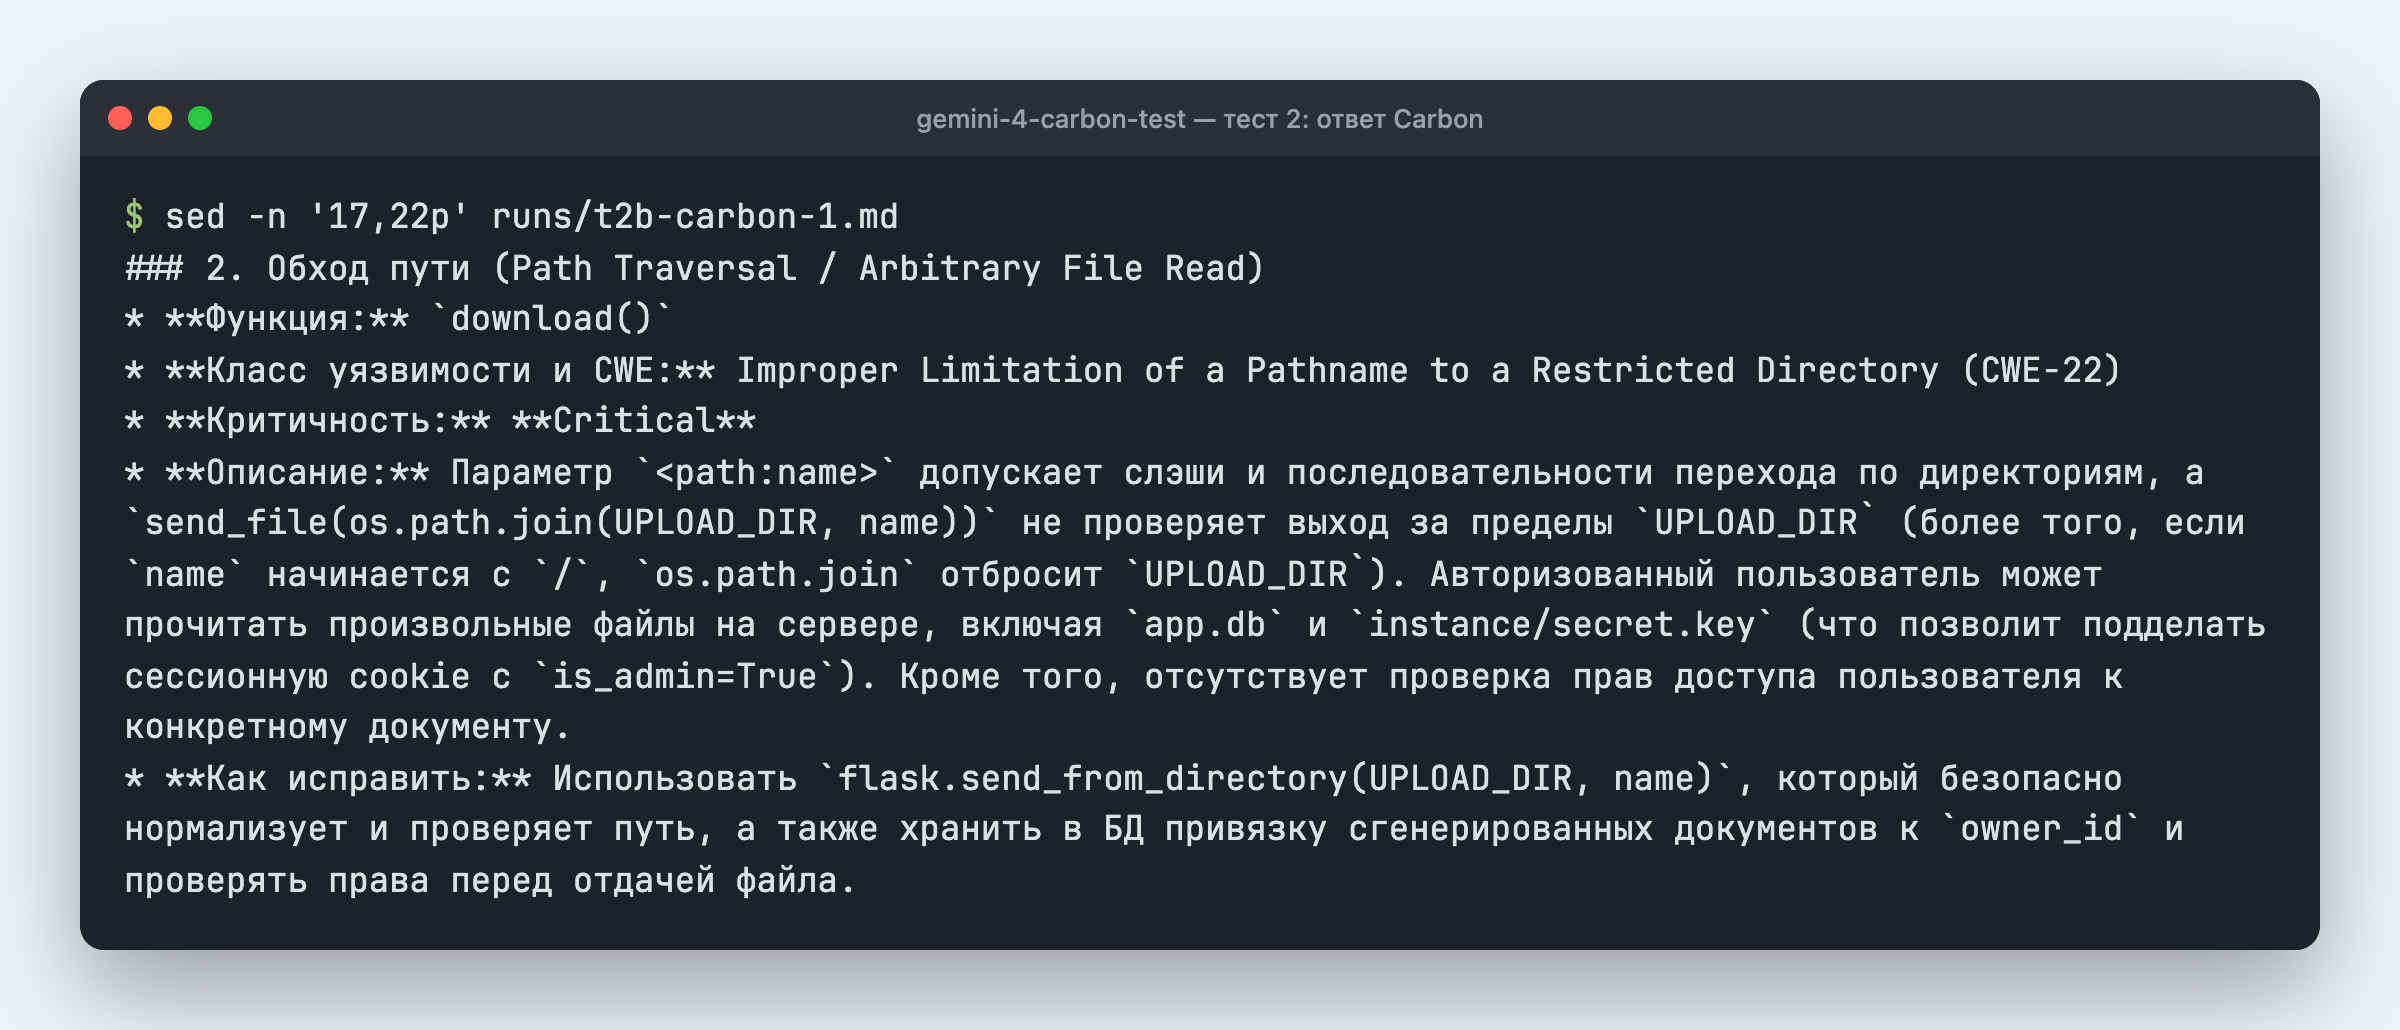
Обе модели сами вывели из обхода пути подделку сессии администратора, а Carbon добавил случай с абсолютным путём в os.path.join. Скриншоты: терминал / matveev.tech
По цене вышло почти поровну: Argon за 41 секунду и $0,035, Carbon за 6,5 минуты и $0,044. На такой задаче Carbon думал сравнительно мало, 1 459 токенов. Перед ответом он шесть раз вернул ошибку 503 «модель перегружена».
Что показывают бенчмарки против Opus 5.5 и GPT-6 Astra
По таблице Google, Carbon впереди в общем зачёте, но не везде. В индексе Artificial Analysis v5.0 у него 59 баллов против 58 у Opus 5.5 и 57 у GPT-6 Astra. В Terminal-Bench 4.0, тесте агентной работы в терминале, у Carbon 65,2% против 59,6% и 59,1%. Сильнее всего отрыв в длинном контексте: GraphWalks на окнах от 256 тысяч до миллиона токенов Carbon проходит на 96,2%, Opus 5.5 на 66,8%.
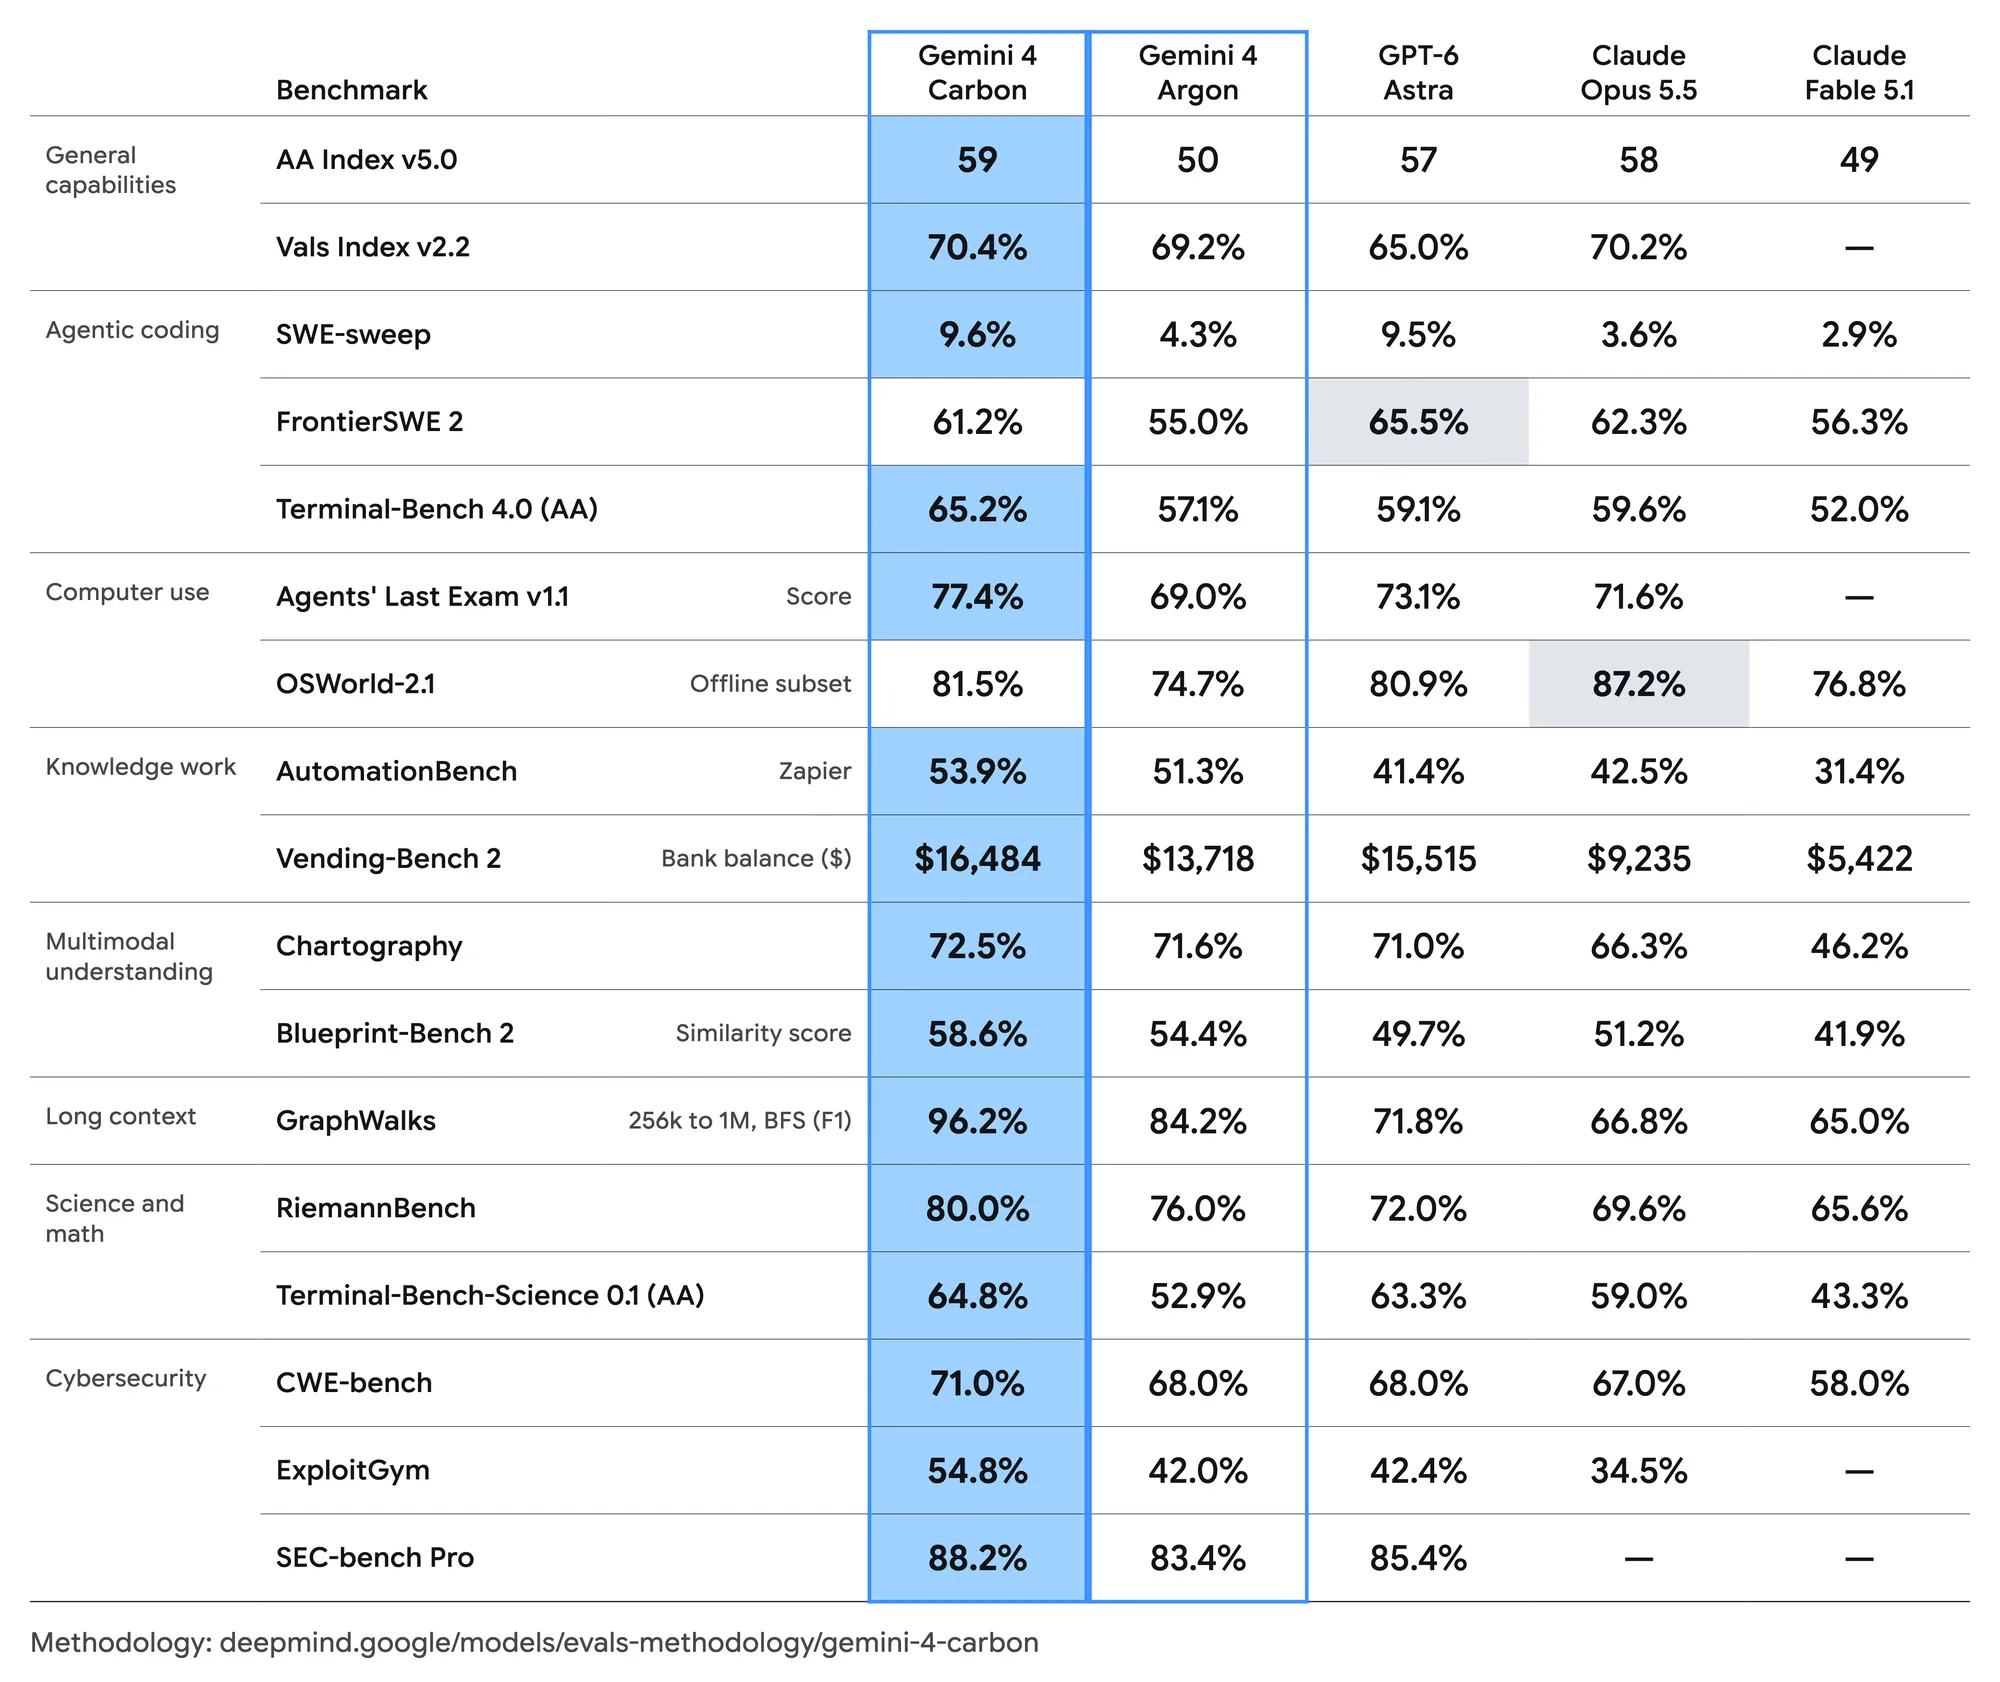
Две строки Google не выделяет, но они важны для выбора. В OSWorld-2.1, где модель управляет компьютером, Opus 5.5 набирает 87,2% против 81,5% у Carbon. В FrontierSWE 2, тесте на сложные инженерные задачи, лидирует GPT-6 Astra: 65,5% против 61,2%. И таблица сравнивает Carbon с Claude Fable 5.1, хотя Fable 5.2 вышла 9 ноября.
Независимая страница Artificial Analysis даёт Carbon уже 60 баллов в обновлённой версии индекса v5.0.1 и добавляет то, чего нет у Google. Чтобы пройти индекс, модель сгенерировала 205 миллионов токенов при медиане 72,8 миллиона и тратила на задачу 25,6 минуты при медиане 12,8. Artificial Analysis прямо называет её многословной и медленной. Первое место Carbon взял за счёт размышлений, и мой тест с CSV показал то же самое в малом масштабе.
Отдельно разберу фразу из анонса: Carbon первый в CursorBench 4.0, WANDR от Perplexity и AutomationBench от Zapier «с вдвое меньшей ценой за задачу», чем у лучшей сторонней модели. Google не пишет, по какой цене считал. До 30 ноября токен Carbon вдвое дешевле токена Opus 5.5, а с 1 декабря они стоят одинаково. Если расчёт сделан по вводной цене, через три недели преимущество в цене за задачу заметно сократится.
Сколько стоит Gemini 4 Carbon в API и в подписке
В API цена за токен у Carbon и Argon одна, и до 30 ноября она вводная. Бесплатного уровня у Carbon нет, а размышления оплачиваются как выходные токены. Вот цены за миллион токенов по официальным страницам Google, Anthropic и OpenAI на 10 ноября:
| Модель | Вход | Выход | Чтение из кэша |
|---|---|---|---|
| Gemini 4 Carbon и Argon, до 30 ноября | $2 | $10 | $0,10 |
| Gemini 4 Carbon и Argon, с 1 декабря | $4 | $20 | $0,20 |
| Gemini 4 Carbon в пакетном режиме, до 30 ноября | $1 | $5 | $0,05 |
| Claude Opus 5.5 | $4 | $20 | $0,20 |
| Claude Fable 5.2 | $8 | $40 | $0,20 |
| GPT-6 Astra | $10 | $50 | $1,00 |
Цена одного запроса считается так: входные токены умножить на цену входа, плюс токены ответа и размышлений, умноженные на цену выхода. Возьмём второй прогон Carbon на задаче с CSV: 2 897 токенов на входе дают $0,0058, а 188 токенов ответа и 19 690 токенов размышлений дают $0,1988. Итого $0,20, из них 97% ушло на размышления, сам JSON стоил меньше цента. С 1 декабря тот же запрос обойдётся в $0,41. Подставь свои числа: если задача короткая, а ответ большой, разница с Argon будет меньше, если задача сложная и ответ короткий, больше.
Отсюда практический совет: считай не цену токена, а цену задачи, и смотри thoughts_token_count в ответе API. Как ещё урезать расход, я собирал в разборе экономии токенов в Cursor и Claude Code, почти всё оттуда применимо и к Gemini. Кэш у Carbon только неявный: Google сам переиспользует повторяющийся префикс промпта от 4 096 токенов со скидкой 95%.
Без API Carbon доступен только по подписке Google AI Ultra: в Gemini app, в поиске в режиме AI Mode и в Antigravity. На моём аккаунте без Ultra в списке моделей Gemini app Carbon нет вовсе. Учёные могут подать заявку на бесплатный доступ к Argon и Carbon в Antigravity на полгода, а специалисты по киберзащите в Fairwind.
Как работает /swarm в Google Antigravity
/swarm — это режим Antigravity, в котором один промпт превращается в команду агентов. По блогу Antigravity, координатор раздаёт задачи воркерам, каждый из них работает в отдельном git worktree, а верификаторы гоняют тесты и пытаются опровергнуть каждый дифф. Все агенты пишут в общую доску сообщений, которую можно только дополнять. Агент, который ждёт своей очереди, токенов не тратит.
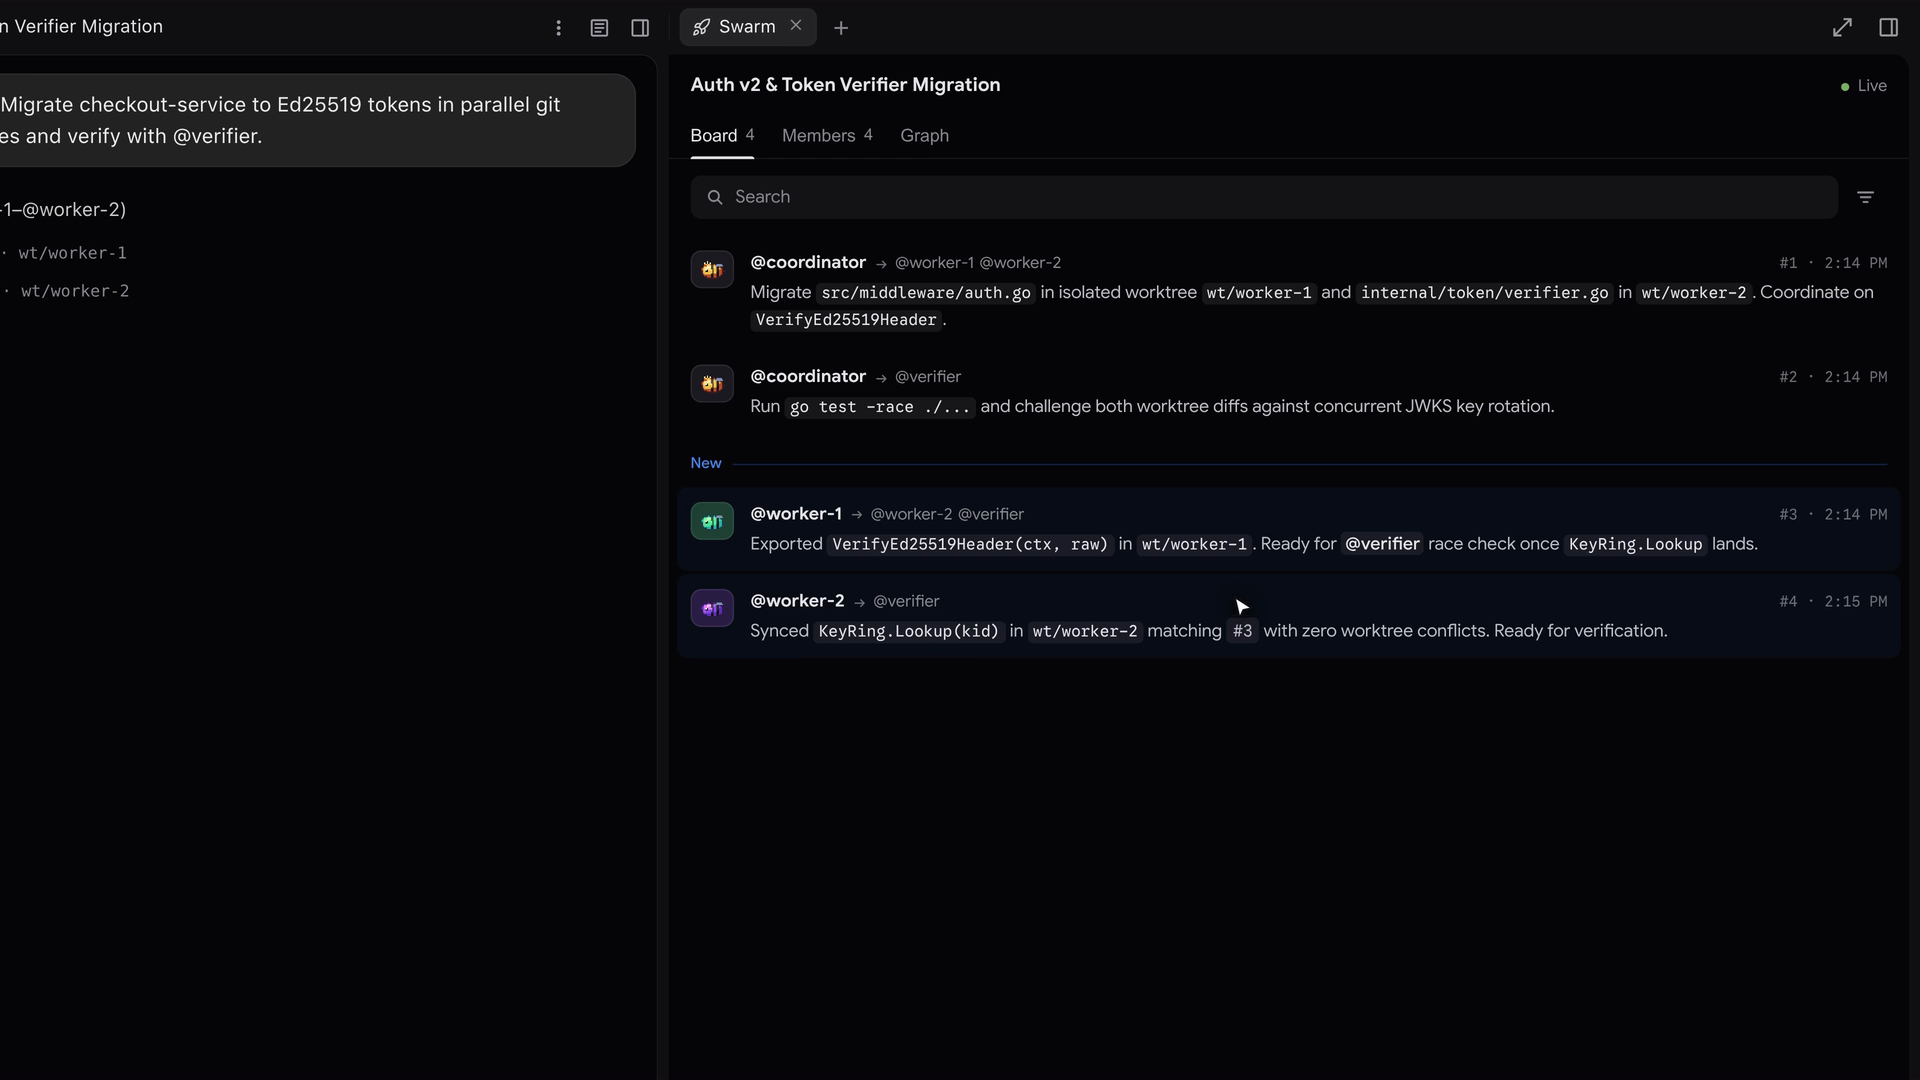
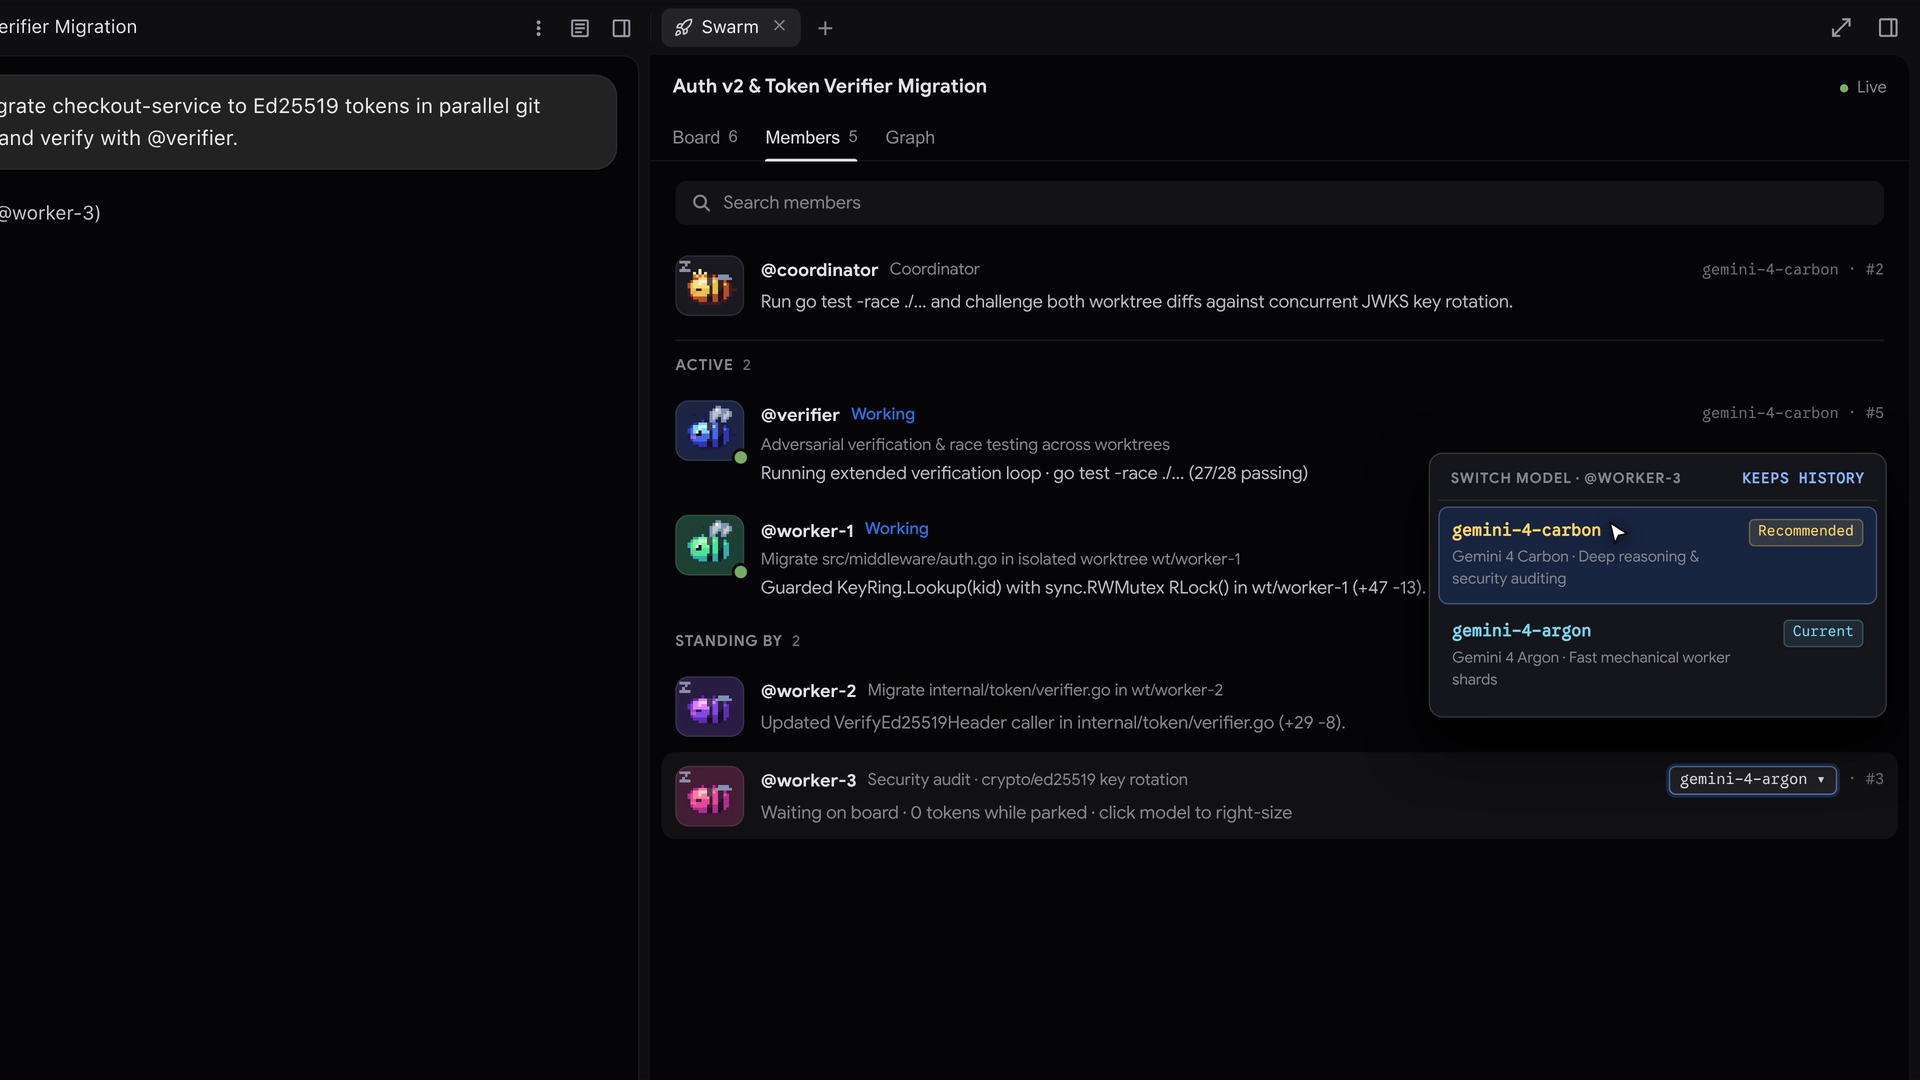
Слева доска, где координатор раздаёт задачи воркерам по worktree, справа выбор модели для каждого агента: Carbon для координации и аудита, Argon для механической работы. Изображения: Google Antigravity
Самое полезное здесь в том, что модель выбирается для каждого агента. Координатор и аудитор получают Carbon, механическую работу делают воркеры на Argon. Мой тест это подтверждает: на простых задачах Argon справляется сам, а дорогие размышления нужны там, где решают и проверяют.
Идея знакомая. Похожим образом устроены команды агентов в Claude Code и мультиагентный режим Codex. Google сам предупреждает, что параллельные агенты расходуют квоту быстрее обычного чата. /swarm пока в превью в приложении Antigravity и в CLI, работает у подписчиков Ultra. Как Antigravity выглядит против Cursor и Claude Code, я сравнивал в подборке ИИ-агентов для кода.
Где попробовать Gemini 4 Carbon и как подключить по API
Быстрее всего через Gemini API, на это уйдёт минут пять. Вот шаги, по которым я запускал тест.
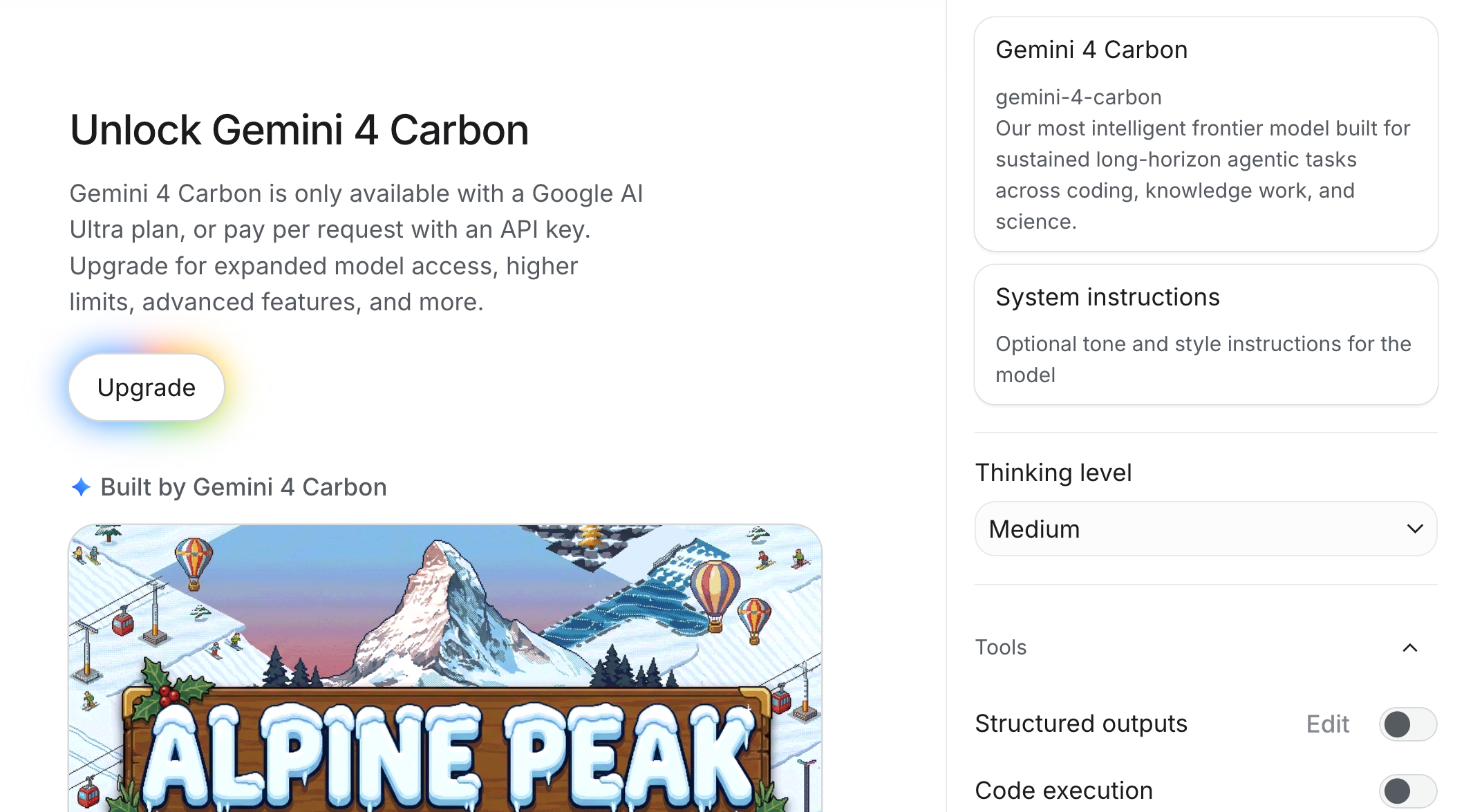
Взять ключ на платном тарифе. На бесплатном аккаунте AI Studio вместо чата с Carbon показывает экран «Unlock Gemini 4 Carbon»: модель доступна только с Ultra или с оплатой запросов по API-ключу. Ключ создаётся в AI Studio, и его проект должен быть на платном тарифе.
Поставить модель и уровень размышлений. Если у тебя уже работает Argon, достаточно поменять строку модели, схема запроса та же. Я вызывал модель через библиотеку google-genai вот так:
from google import genai
from google.genai import types

client = genai.Client()  # ключ берётся из переменной GEMINI_API_KEY
resp = client.models.generate_content(
    model="gemini-4-carbon",
    contents="Найди причину бага и верни исправленный файл: ...",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium"),
    ),
)
print(resp.text)
print(resp.usage_metadata.thoughts_token_count)  # сколько ушло на размышления
Поднять таймауты и лимит ответа. Мой самый долгий запрос шёл 10 минут, а стандартный HTTP-таймаут в минуту оборвёт такой ответ. Синхронный ответ ограничен 65 536 токенами вместе с размышлениями. Для длинной генерации Google советует background=True и max_output_tokens до 131 072 или 262 144, а лимит ниже 32 768 ставить не рекомендует.
Обработать перегрузку. В день запуска API вернул мне 25 ошибок 503 «This model is currently experiencing high demand», в том числе на Argon. Без повторов с паузой первая пачка запросов просто упала. В рабочем коде нужен повтор с нарастающей паузой: у меня хватало от 30 секунд до двух минут.
Проверить, нужен ли вообще Carbon. Прогони ту же задачу на Argon с thinking_level="high" и сравни точность и thoughts_token_count. Если разницы нет, оставь Argon: он отвечает быстрее при той же цене за токен.
Стоит ли переходить на Gemini 4 Carbon
Думаю, для ежедневной работы переходить не стоит. В моих тестах Argon нашёл все баги и все уязвимости за 15–40 секунд и 1,5–3,5 цента, а там, где ошибся, его вытянул уровень размышлений high дешевле и быстрее Carbon. Carbon мне понравился в другом. Он сам находит то, о чём его не спрашивали, вроде округления возвратов в биллинге, и стабильно доводит расчёты до точного ответа без подсказки про настройки. Это ценно там, где ошибка стоит дороже токенов: в ревью платёжного кода перед релизом и в разборе длинных документов, где у него огромный отрыв в GraphWalks.
Кому брать Carbon сейчас: тем, кто строит агентные системы и может отдать ему роль координатора или проверяющего, как в /swarm, и тем, кто работает с контекстом на сотни тысяч токенов. До 30 ноября он ещё и вдвое дешевле Opus 5.5 за токен при том же уровне в общем индексе. С 1 декабря цены сравняются, и выбор между ними будет по задачам: управление компьютером лучше у Opus 5.5, длинный контекст и кибербезопасность у Carbon. Огорчили меня перегрузка в день запуска и фильтр, который режет обычную просьбу воспроизвести уязвимость в собственном коде. Для команд безопасности путь один, программа Fairwind.
Другие обзоры моделей Google, OpenAI и Anthropic собраны в разделе Модели.
Читайте также
- Обзор GPT-6 Astra: главный конкурент Carbon от OpenAI и его цена $10/$50;
- Claude Fable 5.2: чем новая Fable отличается от Opus 5.5 и когда она стоит своих денег;
- Gemini Omni 1.2 Flash: видеомодель Google с тестом на русском;
- Voice Standard Bench: какую LLM брать для голосовых задач по моему замеру.