Память AI-агентов: контекст, RAG, графы и mem0
Пять уровней памяти агента от сжатия контекста до графов знаний: что работает в Claude Code и Codex и когда нужны RAG, mem0 и Graphiti.
· обновлено · 11 мин
Зачем AI-агенту память, если у Claude Opus 5.5 контекстное окно уже миллион токенов? Затем, что длинная сессия всё равно упирается в лимит, а после сжатия агент теряет детали из начала разговора. Память AI-агентов — это способы сохранить нужное между запросами и сессиями: сжатие контекста, субагенты, файлы с заметками, RAG по документам и графы знаний вроде mem0 и Zep.
Каждый уровень решает свою задачу. Для кодинг-агента обычно хватает файлов и сжатия, а графы нужны персональным ассистентам, которые месяцами помнят пользователя.
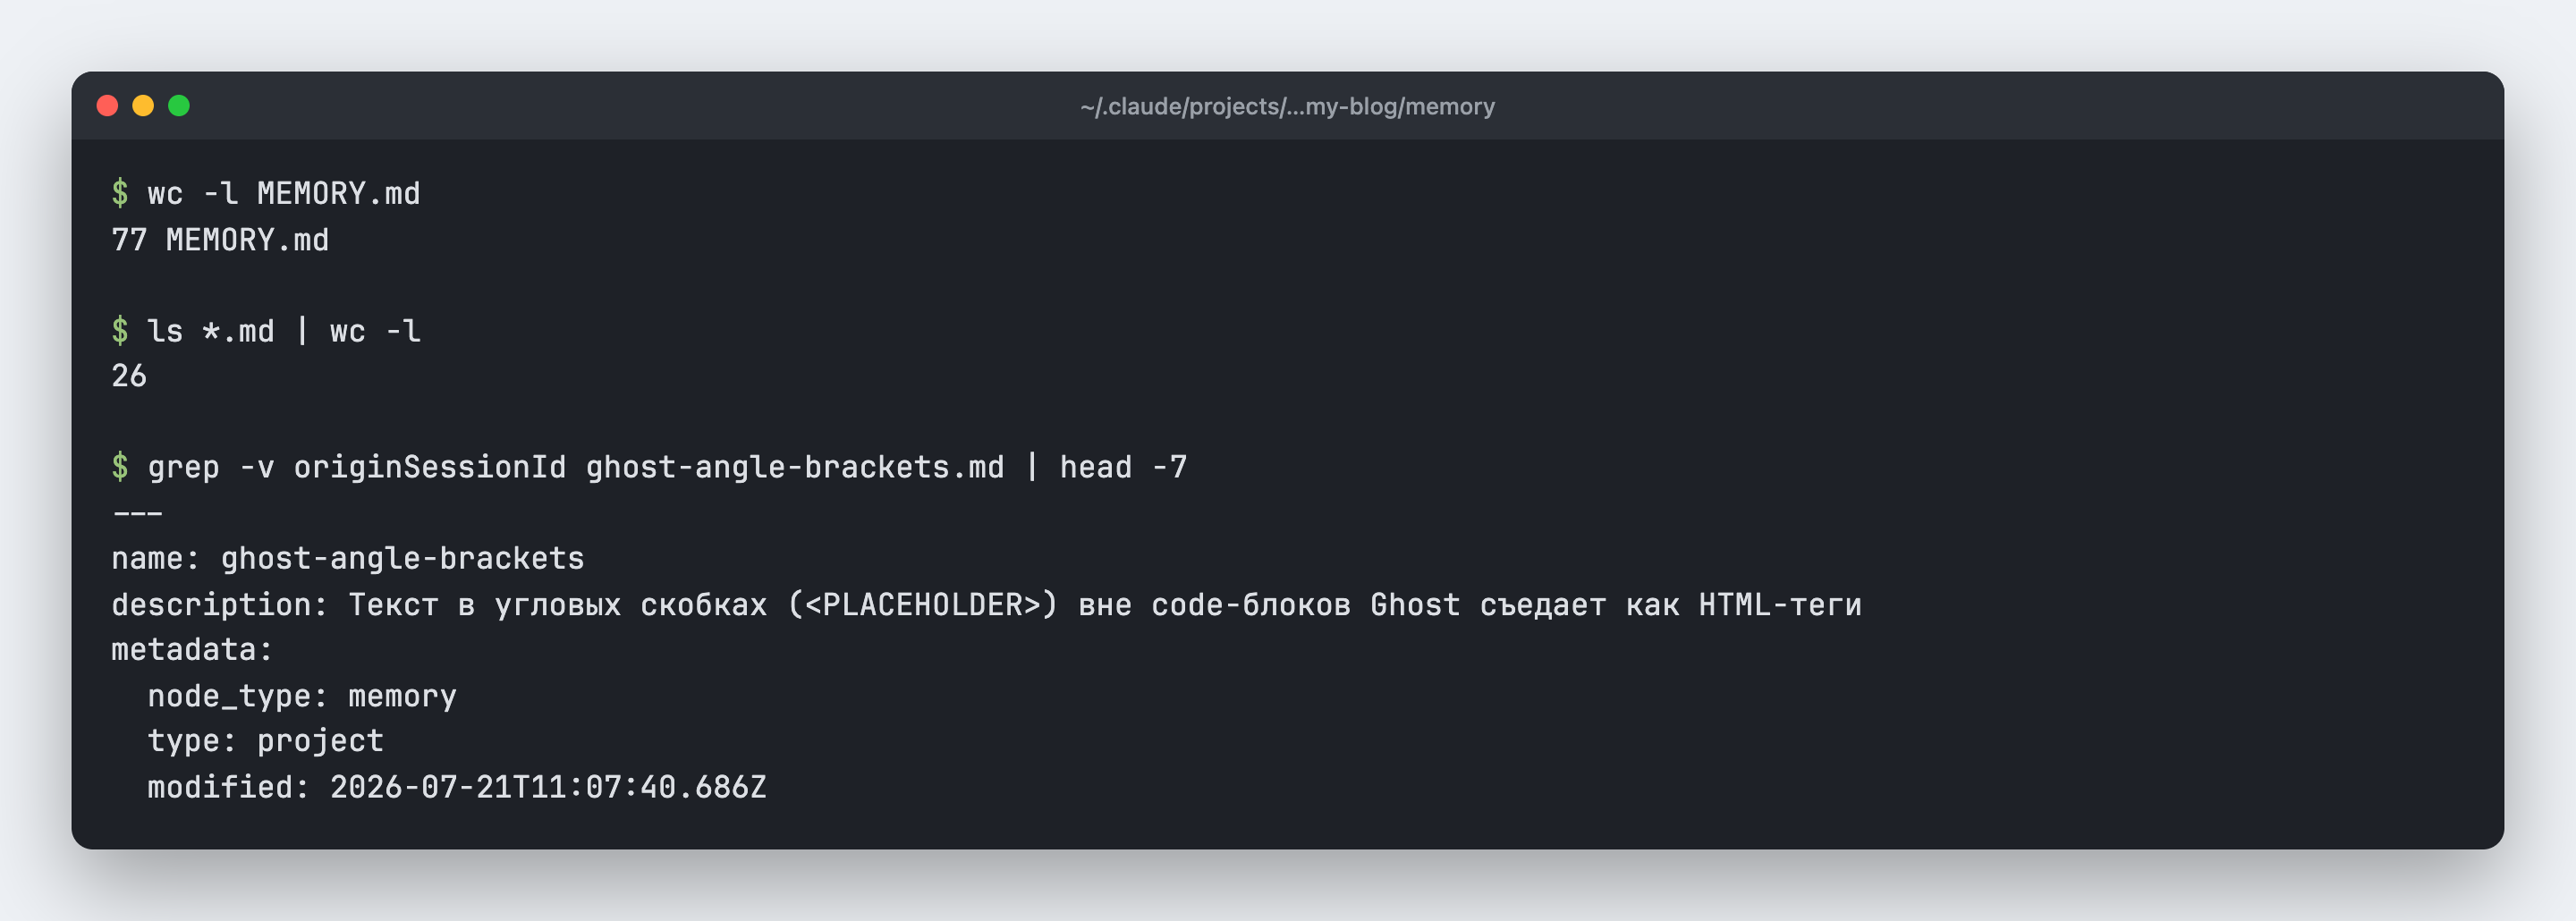
Я каждый день работаю с Claude Code. У этого блога своя папка памяти на 26 заметок, а общую память агентов я держу на своём сервере Hindsight. Статью я написал в марте 2026 года и в ноябре обновил: mem0 убрал графы из open-source версии, у Codex появилась своя память, а Letta переехала в Letta Code.
Зачем AI-агенту память, если контекстное окно уже миллион токенов
Контекстное окно похоже на оперативную память компьютера: это всё, что модель видит за один вызов. Окно не хранит ничего между сессиями. Закрыл чат, и агент начинает с чистого листа.
Большое окно тоже не спасает. В Anthropic описывают эффект context rot: чем больше токенов в окне, тем хуже модель вспоминает конкретный факт из него. Поэтому в Anthropic советуют класть в окно как можно меньше токенов, но только нужных.
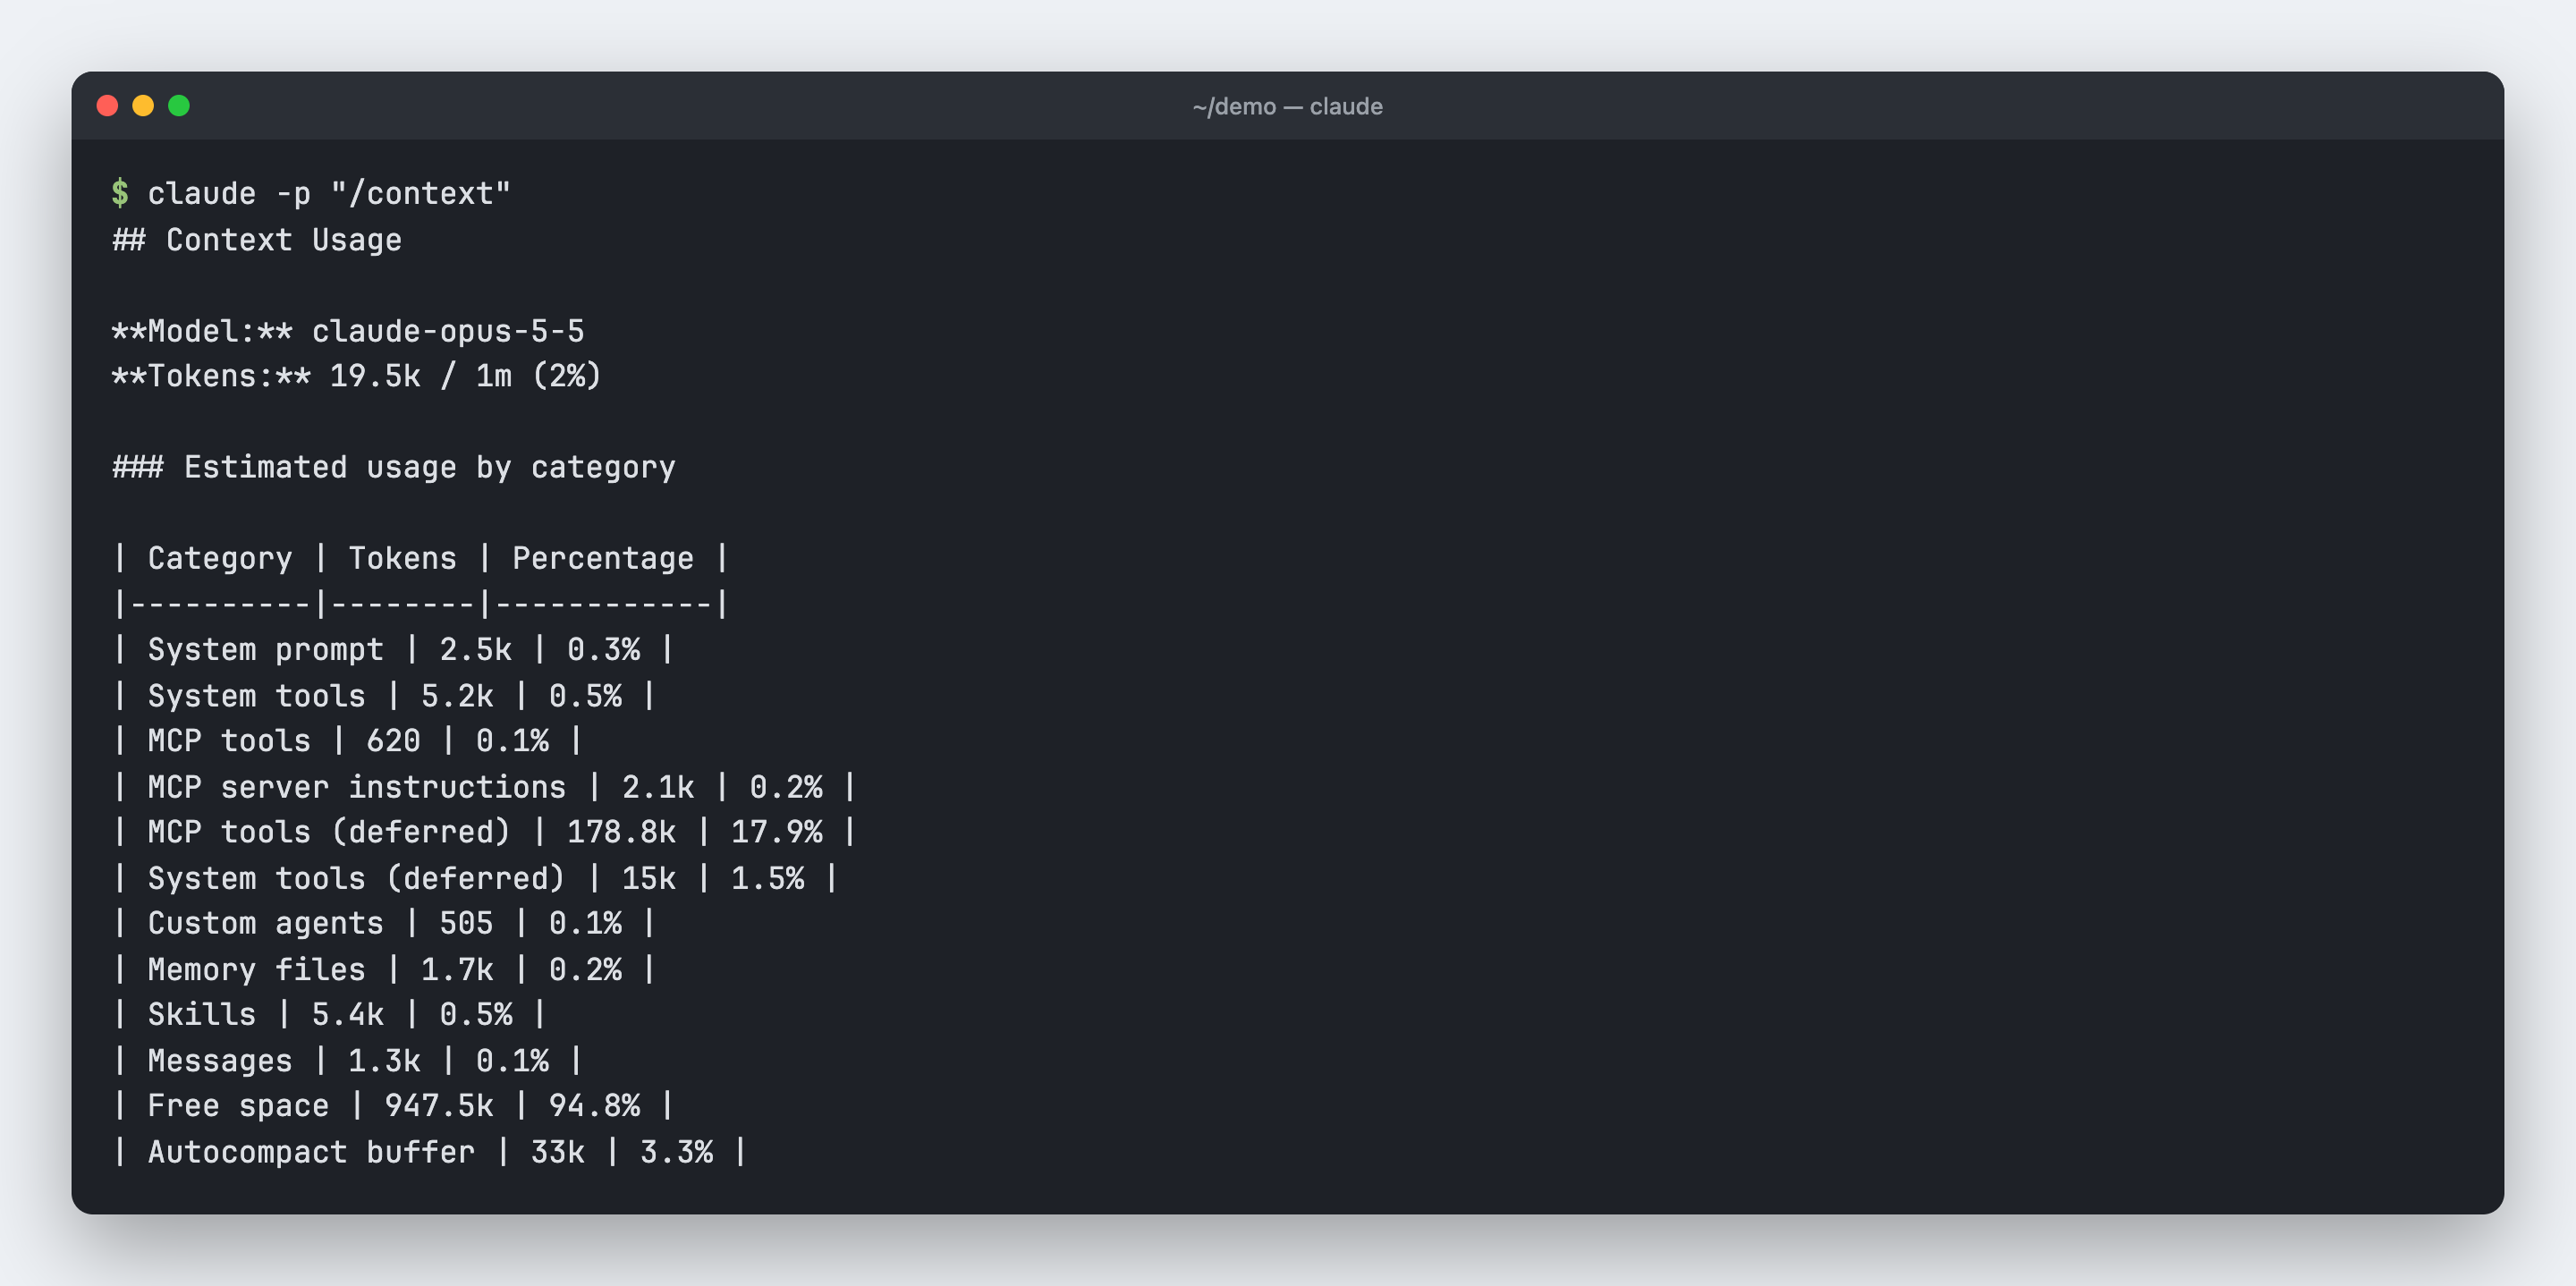
Вот как выглядит окно в свежей сессии Claude Code в пустой папке. Из миллиона токенов занято 19,5 тысячи: системный промпт, инструменты, файлы памяти. Ещё 33 тысячи зарезервированы под автоматическое сжатие.
Задачи памяти я делю на пять уровней. Первые два живут внутри одной сессии, остальные переживают перезапуск.
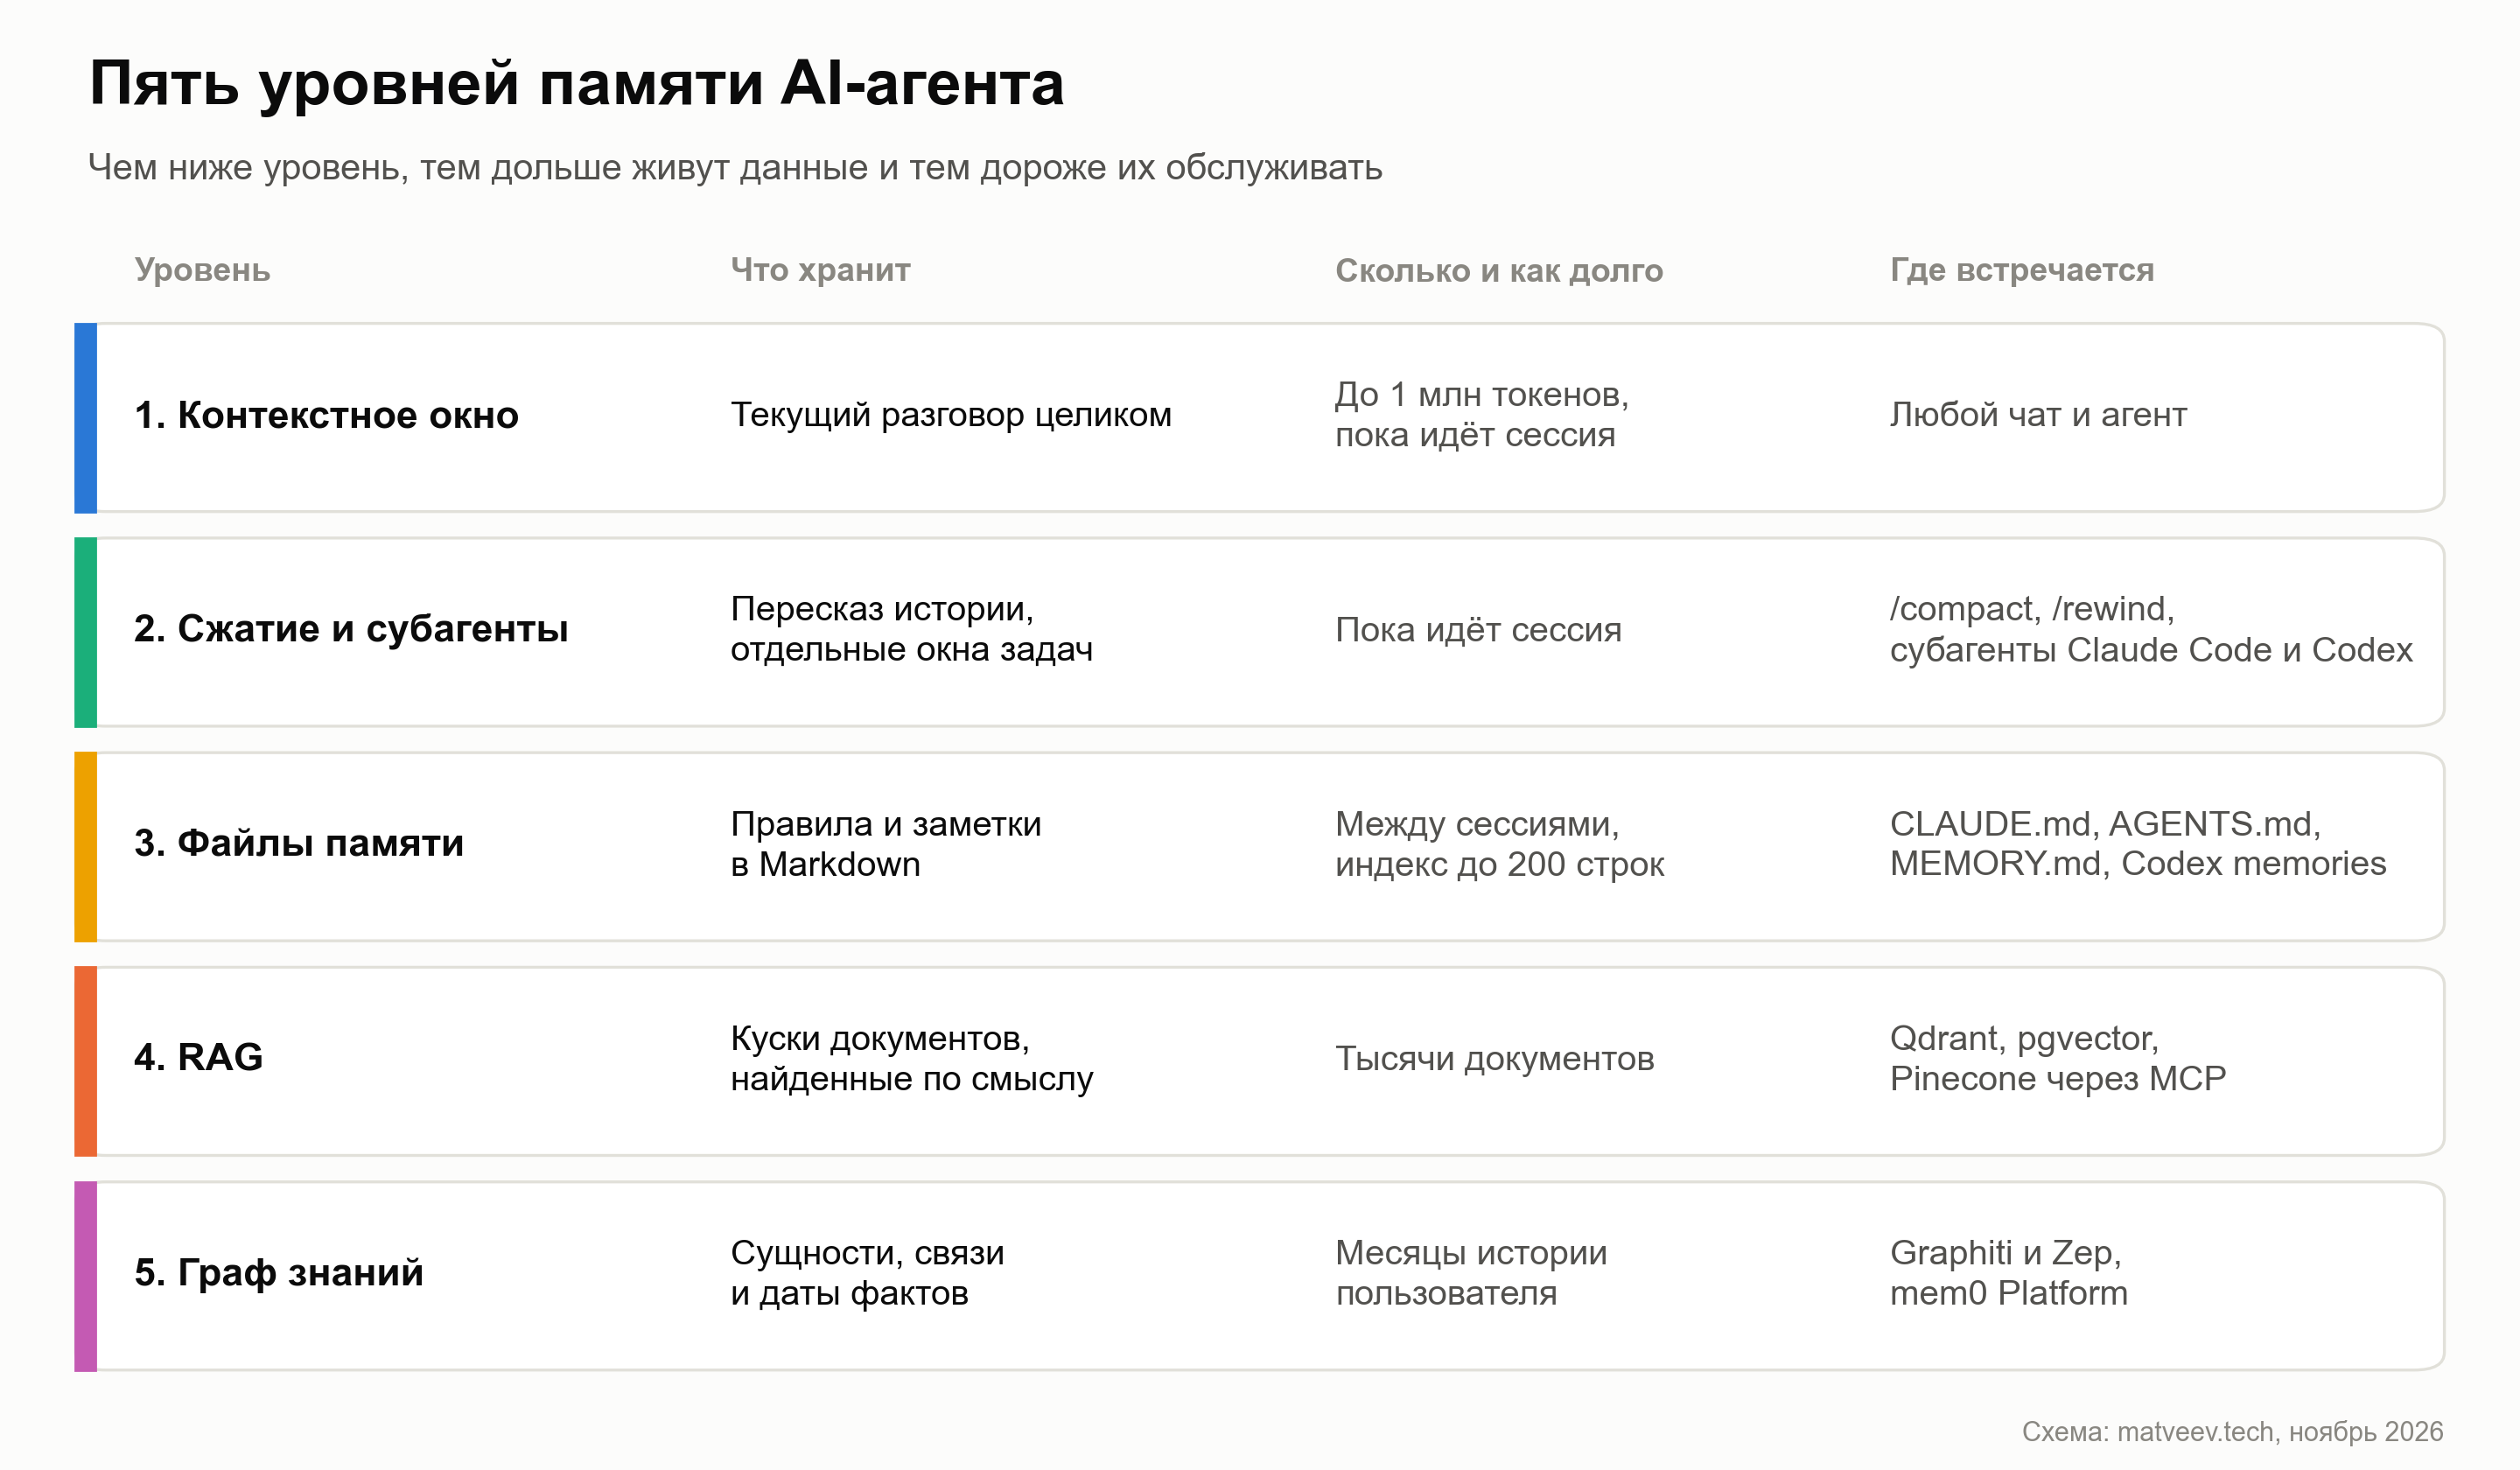
Ниже разберу каждый уровень на примерах из Claude Code, Codex и n8n.
Как работает простая память агента: сжатие, тримминг и откат
Самый простой подход работает с окном напрямую. Ничего не сохраняется на диск, агент просто управляет тем, что лежит в текущем разговоре.
Сжатие (компакт). Когда окно подходит к лимиту, отдельный вызов модели пересказывает историю коротким саммари. В Claude Code это происходит само, а порог можно сдвинуть командой /autocompact 500k. После сжатия Claude Code заново читает корневой CLAUDE.md и до пяти последних файлов, с которыми работал. Всё, что ты сказал только в чате, превращается в пересказ.
Тримминг. Это ещё грубее: агент видит последние N сообщений, остальное выбрасывается. Так работает узел Simple Memory в n8n, где число сообщений задаёт параметр Context Window Length. Быстро и дёшево, но старые сообщения пропадают без шанса вернуть их.
Откат. В Claude Code команда /rewind или двойной Esc открывает список твоих сообщений. Можно вернуть разговор, код или и то и другое к нужной точке. Там же есть пункты «Summarize from here» и «Summarize up to here»: сжать только часть разговора, а остальное оставить как есть (документация Claude Code).
Сжатие работает, но не бесплатно. На длинных сессиях я вижу это сам: после четырёх-пяти компактов от исходной задачи остаётся пара строк, такой «гомеопатический промпт». Исследователи JetBrains в декабре 2025 года сравнили два подхода на задачах SWE-bench. Простое скрытие старых выводов инструментов оказалось не хуже пересказа моделью: с Qwen3-Coder 480B решаемость выросла на 2,6%, а расходы упали на 52% относительно агента без управления контекстом.
Как не доводить окно до сжатия, я разбирал в статье про экономию токенов в Cursor и Claude Code.
Как субагенты делят контекст агента
Когда одного окна мало, можно взять несколько. Субагент это отдельный агент со своим окном, инструментами и системным промптом. Главный агент раздаёт задачи, а детали каждой задачи остаются в окне исполнителя.
Например, при разработке веб-приложения можно завести субагентов для бэкенда, фронтенда и деплоя. Код бэкенда живёт только в окне бэкенд-разработчика. Координатор держит общую картину и получает от исполнителей короткие отчёты.
У субагентов в Claude Code есть своя постоянная память. Её включает поле memory в описании агента, и тогда у него появляется папка с собственным MEMORY.md (документация):
---
name: code-reviewer
description: Ревьюит код по правилам проекта
memory: project
---

Перед ревью проверь свою память на похожие ошибки.
После ревью запиши в память новые паттерны.
Значение project кладёт память в .claude/agent-memory/code-reviewer/, её можно коммитить вместе с проектом. Учти, что память главного разговора в обычный субагент не попадает. Её наследует только форк.
Agent Teams идут дальше: главный агент сам собирает команду и раздаёт задачи. На ноябрь 2026 года функция всё ещё экспериментальная и включается переменной CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1. Подробности в инструкции по Agent Teams в Claude Code, а тот же подход в Codex я разбирал в статье про субагентов в Codex.
Как устроена файловая память AI-агента в Claude Code и Codex
Файловая память это markdown-файлы, которые переживают перезапуск. Агент читает их в начале сессии и дописывает, когда узнаёт что-то полезное. Ни базы данных, ни эмбеддингов.
В Claude Code таких механизмов два. CLAUDE.md пишешь ты: там правила, команды сборки и архитектура. Auto memory пишет сам Claude: твои поправки, предпочтения и контекст, который не вывести из кода.
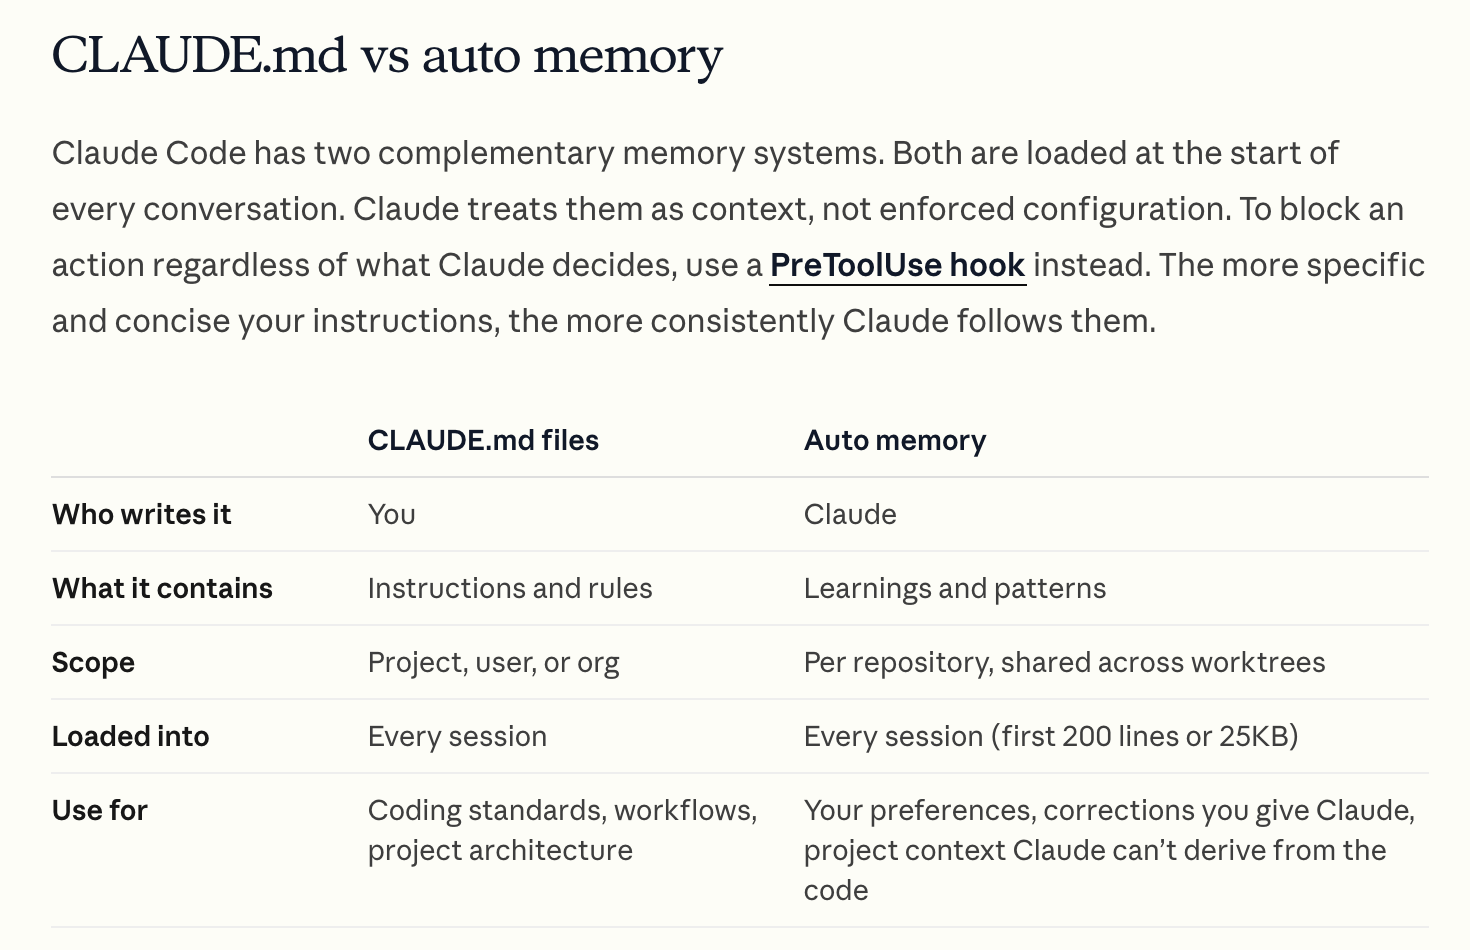
Auto memory включена по умолчанию в локальных сессиях. Она живёт в ~/.claude/projects/<проект>/memory/: файл MEMORY.md служит оглавлением, а каждая заметка лежит отдельным файлом. В начале сессии загружаются первые 200 строк MEMORY.md или 25 КБ, что наступит раньше. Остальные файлы Claude читает по необходимости.
Заметки бывают четырёх типов: user про тебя, feedback про твои поправки, project про текущую работу и reference про внешние ресурсы. Вот как это выглядит в памяти этого блога.
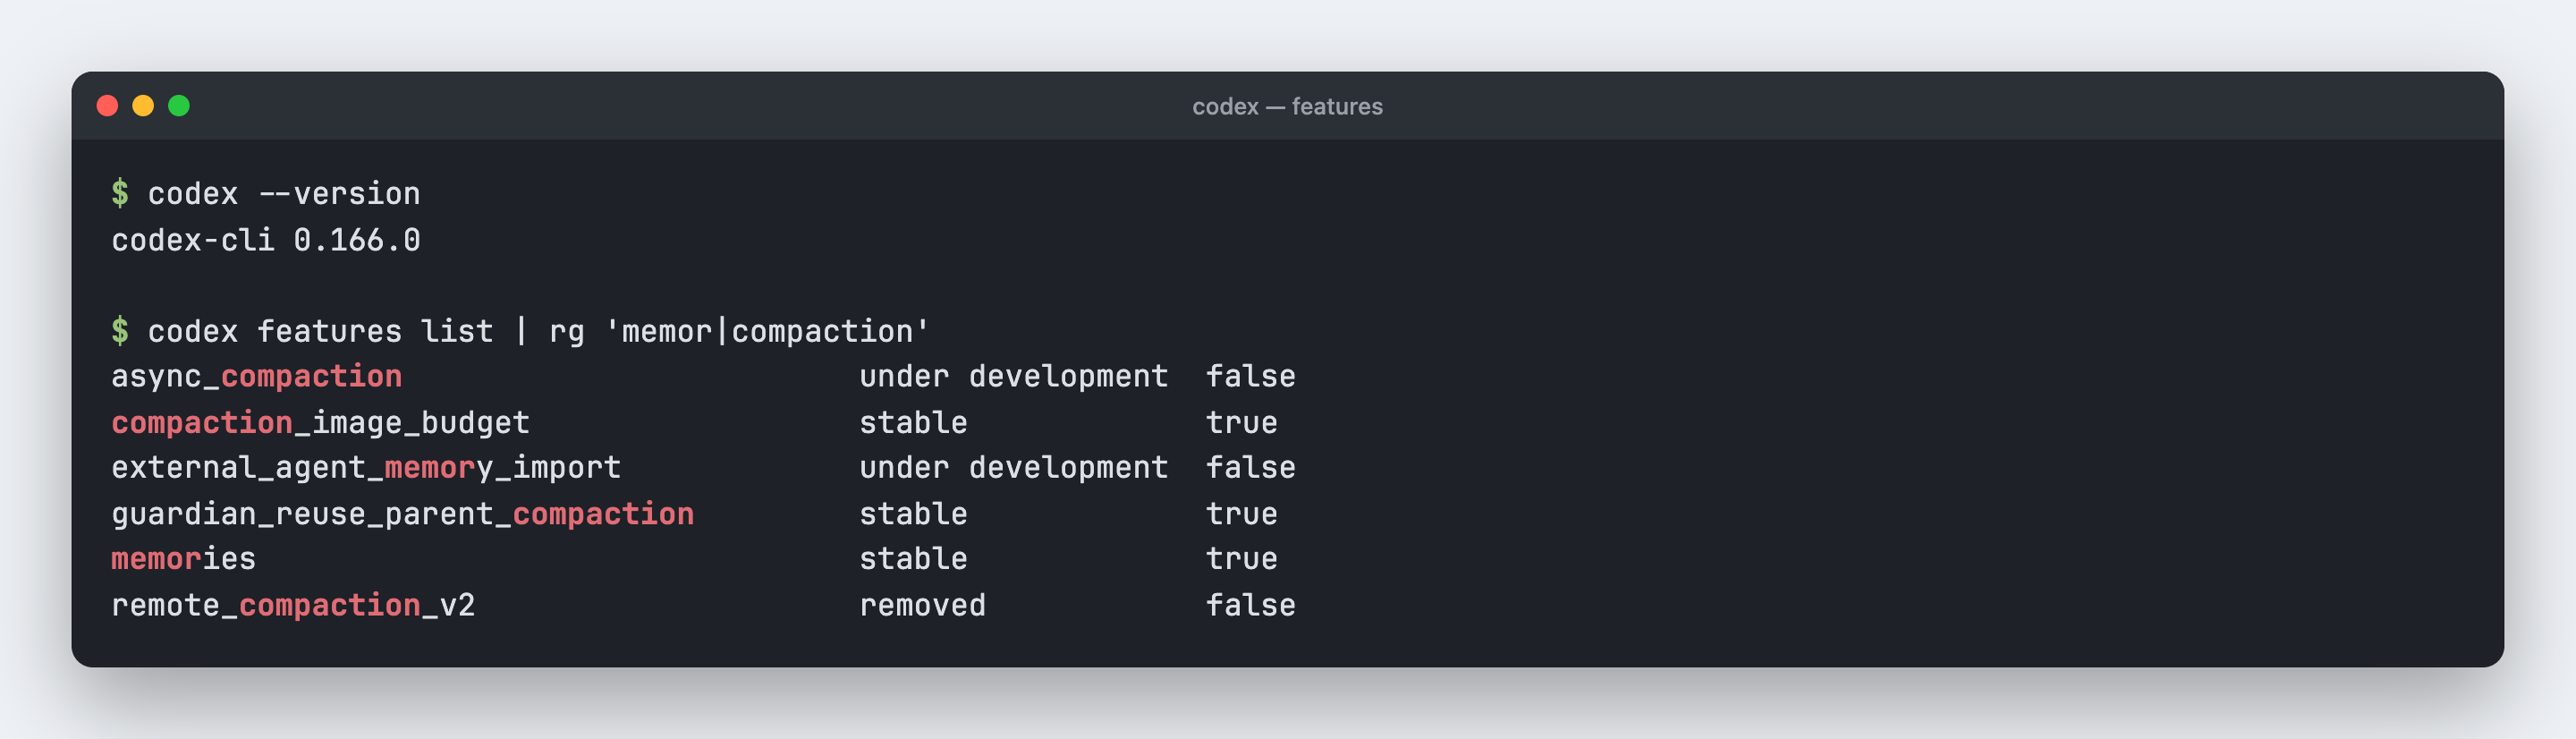
Теперь своя память есть и у Codex. Она выключена по умолчанию и включается в ~/.codex/config.toml:
[features]
memories = true
Codex пишет память в фоне, когда чат какое-то время простаивает, и пропускает короткие сессии. Секреты он вырезает из заметок сам. Командой /memories можно запретить конкретному чату читать память или попадать в неё.
Для своих агентов на API у Anthropic есть memory tool. Это тот же принцип: Claude создаёт, читает и правит файлы в папке памяти, а хранилище реализуешь ты. В ноябре 2026 года инструмент стабилен и работает со всеми актуальными моделями, от Haiku 5.5 до Fable 5.1.
Файлы часто недооценивают, и зря. В августе 2025 года команда Letta проверила агента, который просто складывал историю разговоров в файлы. На бенчмарке LoCoMo он набрал 74% на GPT-4o mini, а специализированный mem0 в своей статье тогда заявлял 68,5%.
Как организовать CLAUDE.md и правила, подробно разобрано в гайде про память Claude Code: auto memory, rules и CLAUDE.md.
Когда AI-агенту нужен RAG
RAG (Retrieval-Augmented Generation), или генерация с поиском, нужен, когда данных слишком много для файлов. Документы режут на куски и кладут в векторную базу. На запрос агент ищет куски, близкие по смыслу, и подкладывает их в окно.
Простой пример. У тебя банковские выписки за несколько лет. Загружаешь их в RAG-хранилище, подключаешь к Claude Code через MCP и спрашиваешь: «На что я тратил деньги в Тбилиси?» Агент вызовет поиск, найдёт нужные страницы выписки и ответит по ним.
Векторные базы вроде Qdrant, pgvector или Pinecone подключаются к агенту через MCP-серверы. Как настроить MCP в Claude, я писал в гайде по MCP-серверам.
У RAG есть предел. Он находит похожие тексты, но не видит связей между ними. На вопрос «как менялись мои предпочтения за год» RAG вернёт разрозненные куски и не выстроит цепочку. В mem0 объясняют разницу на примере: RAG ранжирует только по похожести, а память агента учитывает ещё свежесть и важность факта. Поиск по похожести легко поднимет «любит джаз» выше, чем «аллергия на арахис».
Что такое графовая память агента: mem0, Zep и Letta в 2026 году
Графовая память хранит сущности и связи между ними. Например, «Павел → живёт → Тбилиси» и «Павел → использует → Claude Code». По таким связям можно пройти цепочкой и ответить на вопрос, который RAG не осилит.
mem0
mem0 остаётся одним из самых популярных слоёв памяти для агентов: на 6 ноября 2026 года у репозитория 68,5 тысячи звёзд. Рядом с кодом лежат готовые плагины для Claude Code, Codex, Cursor и Kimi.
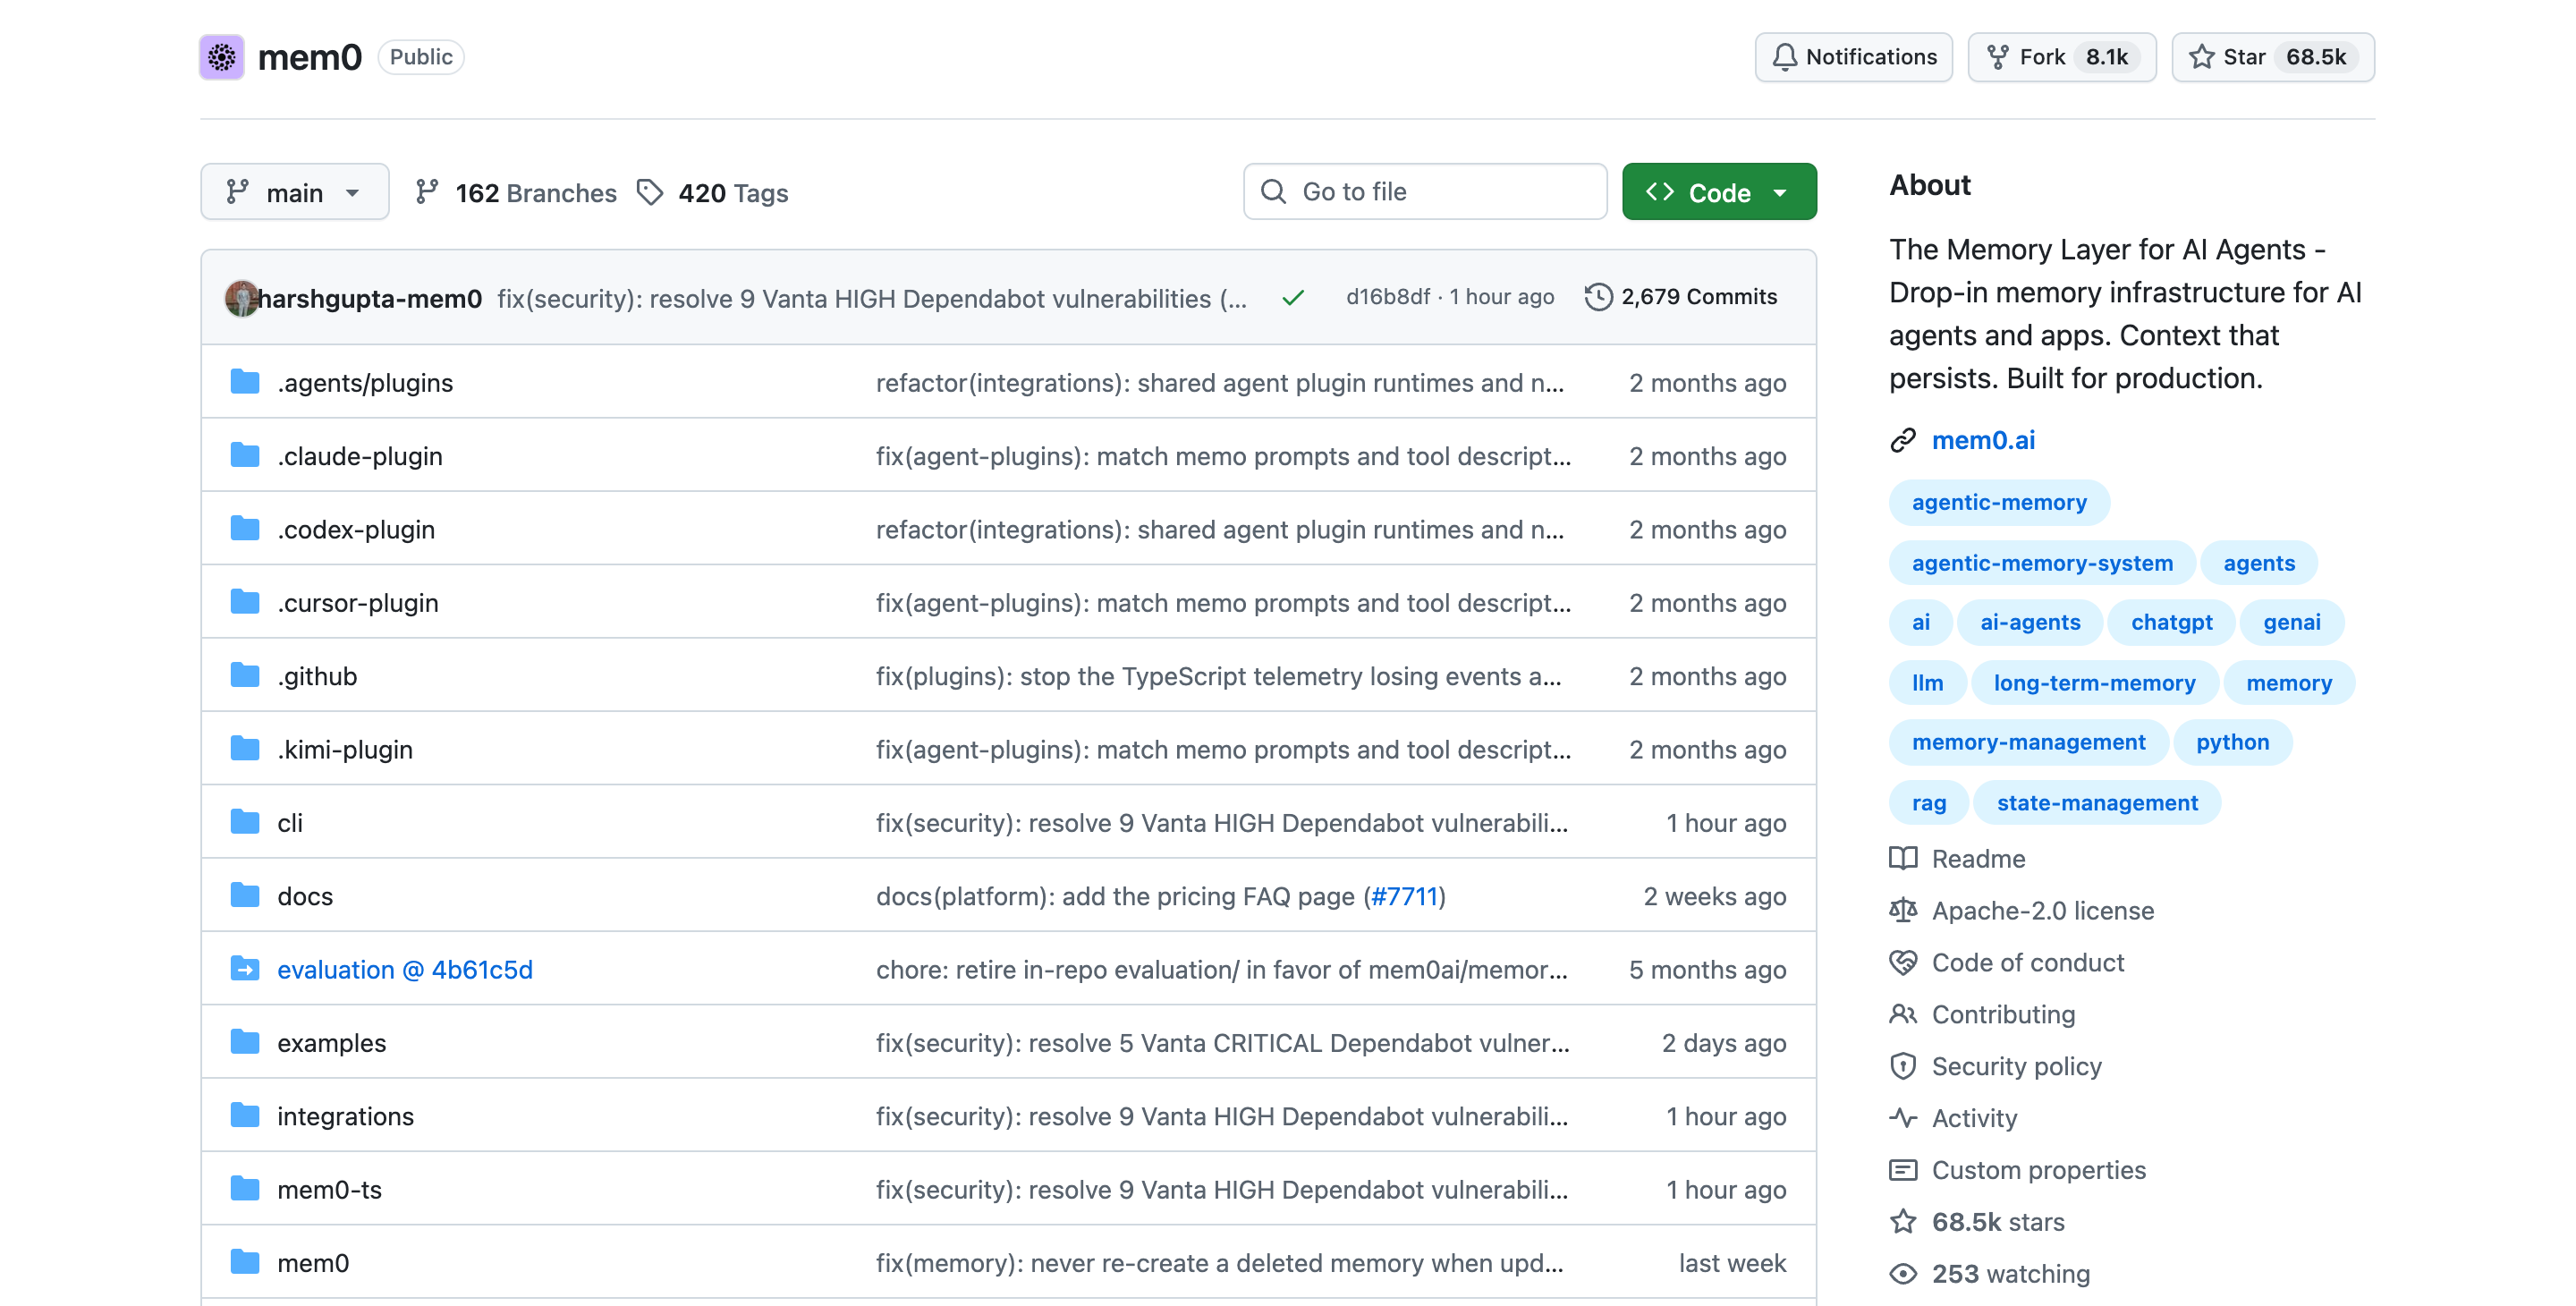
В апреле 2026 года mem0 переписал алгоритм памяти. Новые факты теперь только добавляются, а старые не перезаписываются и не удаляются. Поиск идёт сразу по трём сигналам: смысловая близость, ключевые слова BM25 и совпадение сущностей. По данным mem0, на LoCoMo результат вырос с 71,4 до 92,5 балла, а на LongMemEval с 67,8 до 94,4.
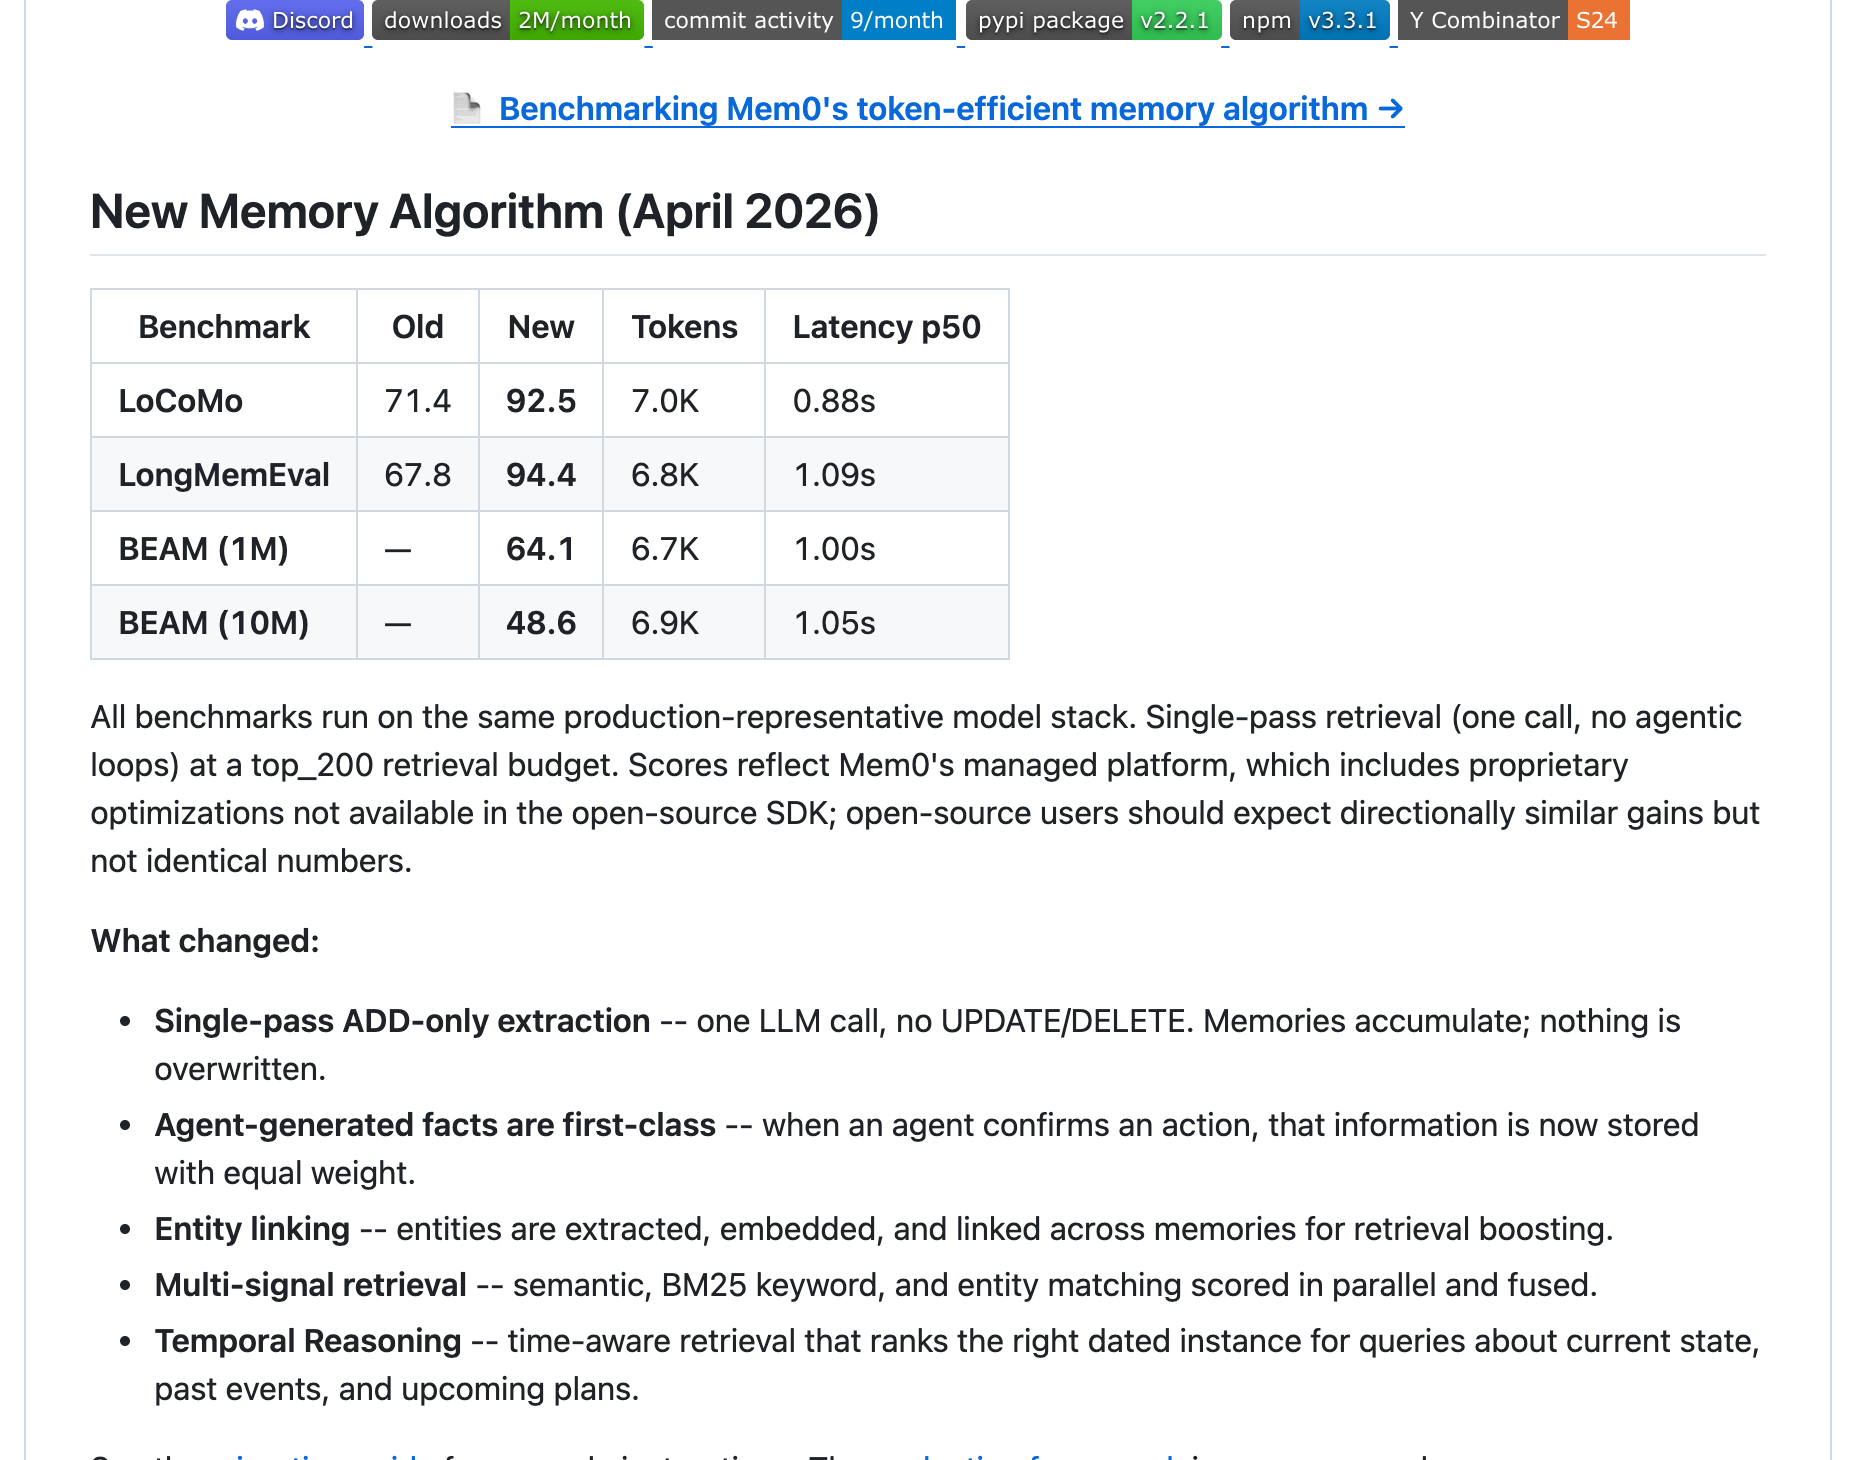
Тут есть важная оговорка. Цифры из README относятся к облачной платформе. Для open-source версии гайд миграции называет 91,6 на LoCoMo и 93,4 на LongMemEval. Это тоже много, но заявленный в README результат на своём сервере ты не получишь.
Главное изменение для тех, кто ставил mem0 ради графов: графовую память из open-source убрали. Параметры enable_graph и graph_store больше не читаются, интеграции с Neo4j нет. Графы остались только в платной платформе mem0, а в бесплатной версии вместо них работает связывание сущностей внутри обычного поиска.
Zep и Graphiti
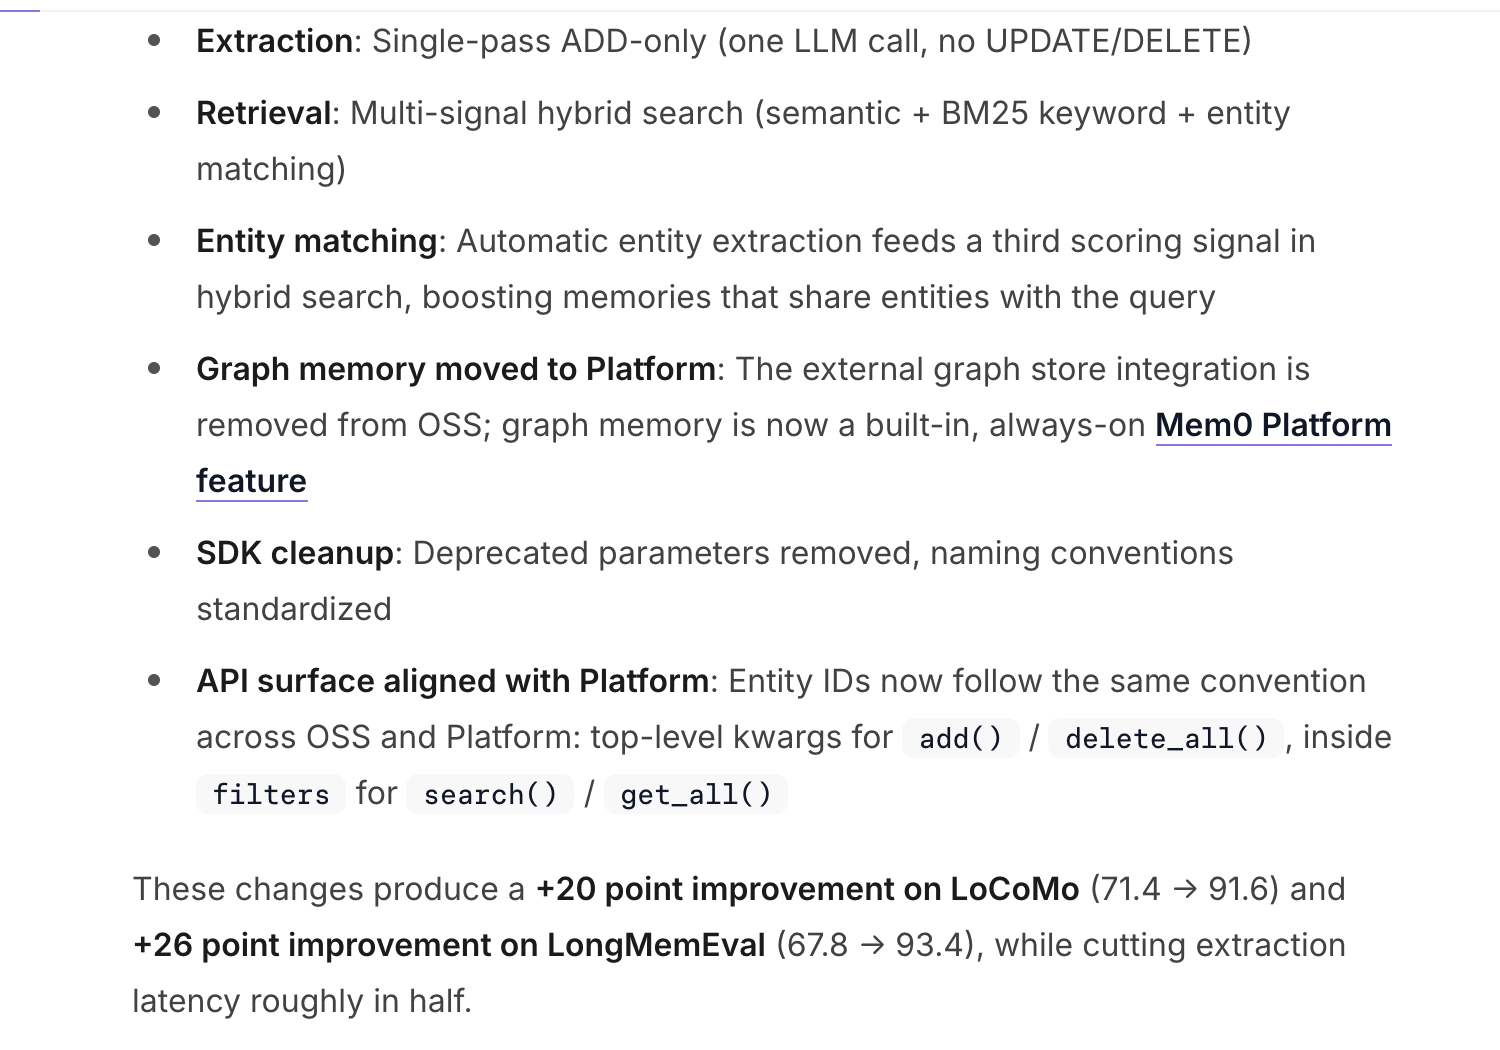
Zep добавляет к графу время. У каждого факта есть окно действия: «Павел жил в Москве» верно до 2023 года, «Павел живёт в Тбилиси» верно сейчас. Агент видит, что изменилось, и не путает старое с новым. Архитектуру Zep описывает статья на arXiv от января 2025 года.
Сам Zep теперь облачный корпоративный сервис. Открытым остался движок Graphiti, на котором Zep построен: 32,6 тысячи звёзд, последний релиз 0.31.2 вышел 20 октября 2026 года. Graphiti подходит, если готов сам поднять графовую базу, LLM и сервис вокруг.
Letta
Letta (раньше MemGPT) дала модели самой управлять своей памятью: что держать под рукой, что убрать в архив, что забыть. Прежний API-сервер Letta V1 ушёл в архив. Активная разработка идёт в Letta Code: это обвязка агента с терминальным интерфейсом, сервером и каналами в Slack и Telegram. Ставится она командой npm install -g @letta-ai/letta-code.

Hindsight и MemPalace
Из новых систем я пользуюсь Hindsight от Vectorize. Агент складывает факты операцией retain, достаёт их через recall, а reflect собирает ответ по всей памяти. Hindsight открыт под MIT, на ноябрь 2026 года у него 59 тысяч звёзд, версия 1.2.0 вышла 3 ноября. Я держу его на своём сервере, к нему подключены Claude Code и Codex.
Ещё одна заметная открытая система, MemPalace, обходится без облачных вызовов. Её я разбирал в обзоре MemPalace.
Какой тип памяти агента выбрать под задачу
Короткое правило: начинай с самого простого уровня и переходи ниже, только когда упрёшься. Вот как я выбираю.
| Задача | Подход | Почему |
|---|---|---|
| Короткий чат-бот, 5–10 сообщений | Тримминг | Просто, дёшево, предсказуемо |
| Кодинг-сессия на пару часов | Сжатие и субагенты | Окно не кончится, детали останутся у исполнителей |
| Проект с правилами и решениями | CLAUDE.md, AGENTS.md и auto memory | Файлы переживают перезапуск, их легко править руками |
| Поиск по сотням документов | RAG через MCP | Эмбеддинги быстро находят нужный кусок |
| Персональный ассистент на месяцы | Graphiti, mem0 Platform, Hindsight | Хранят связи и историю изменений |
| Автономный агент с субагентами | Комбинация уровней | Каждому уровню свой срок жизни данных |
Для кодинга мне почти всегда хватает файлов. В моих проектах связка CLAUDE.md с auto memory закрывает основную часть задач. Агент читает правила, помнит мои поправки и следующую сессию начинает в контексте.
RAG нужен, когда данных правда много: тысячи документов, выписки, логи. Подключил через MCP и забыл.
Графы я бы ставил только туда, где персонализация и есть продукт. Например, ассистент, который месяцами помнит, что ты любишь корейскую историю, но терпеть не можешь музыкальные клипы в рекомендациях. Для остальных проектов это лишний слой: нужно настраивать модель для извлечения фактов, следить за качеством графа и разбираться со связями.
Больше о том, как память сочетается с остальной обвязкой агента, в статье «Agent harness: что это и из чего состоит».
Какие ошибки ломают память AI-агента
Ошибки с памятью агента обычно одни и те же. Вот самые частые.
Правила только в чате. Ты попросил агента не трогать тесты, а через два часа он их переписал. После сжатия просьба из чата превращается в пересказ или теряется. Всё, что должно действовать всегда, клади в CLAUDE.md или AGENTS.md: их Claude Code перечитывает после каждого сжатия.
Раздутое оглавление памяти. Claude Code грузит из MEMORY.md только первые 200 строк. Всё, что ниже, агент в начале сессии не увидит. Если файл растёт, переноси детали в отдельные заметки, а в оглавлении оставляй по строке на заметку.
Секреты в памяти. Codex вырезает секреты из заметок, Claude Code пишет память в обычные файлы. Ключи и пароли в память не попадают только если ты сам за этим следишь. Перед тем как делиться папкой ~/.claude или ~/.codex, просмотри её.
Вера в бенчмарки вендора. mem0 честно пишет, что цифры в README сняты на облаке, а open-source версия даёт чуть меньше. Сверяй, на какой конфигурации и модели получен результат, и проверяй на своих данных.
Факты без дат. Пользователь переехал, сменил стек, передумал. Если память не знает, когда записан факт, агент выдаст устаревшее. Новый алгоритм mem0 ничего не перезаписывает, поэтому старые и новые факты лежат рядом, и всё решает ранжирование по времени. В Graphiti у каждого факта есть окно действия.
Графы ради графов. Графовая база добавляет LLM-вызовы на каждое сообщение и требует присмотра. Если агенту хватает файлов, граф только усложнит отладку.
FAQ
Чем RAG отличается от графовой памяти? RAG ищет похожие куски текста через эмбеддинги, как поиск по смыслу. Графовая память хранит сущности и связи между ними, иногда с датами. RAG отвечает на вопрос «что похоже», граф на вопрос «как связано и что изменилось». Для базы знаний и документов хватает RAG.
Можно ли пользоваться mem0 бесплатно? Да. Open-source версия mem0 распространяется под Apache 2.0, её можно поднять на своём сервере. Понадобится LLM для извлечения фактов и векторное хранилище, например Qdrant. Графовая память с версии 3 есть только в платной платформе mem0.
Как включить память в Codex? Память Codex выключена по умолчанию. Включи её в настройках приложения или добавь в ~/.codex/config.toml секцию [features] со строкой memories = true. Команда /memories управляет памятью для отдельного чата.
Как отключить auto memory в Claude Code? Открой /memory в сессии и переключи auto memory: настройка сохранится в ~/.claude/settings.json. Для одного проекта поставь "autoMemoryEnabled": false в .claude/settings.json проекта. Вместе с ней отключится и память субагентов.
Куда движется память AI-агентов
Изменения 2026 года складываются в одну линию. Файловая память встраивается в сами кодинг-агенты: в Claude Code auto memory включена по умолчанию, в Codex 0.166.0 memories стала стабильной функцией. А графы уходят в облако: mem0 оставил их только в платной платформе, Zep стал корпоративным сервисом, открытым остался движок Graphiti.
Думаю, через год граф на своём сервере будут держать в основном те, у кого персонализация и есть продукт. Остальным хватит файлов агента или облачного сервиса памяти. Проверить прогноз просто: если mem0 вернёт графы в open-source или появится открытый граф с готовым плагином для Claude Code и Codex, я ошибся.
Больше про агентов, MCP и автоматизацию в разделе «Агенты и автоматизация».
Читайте также
- CLAUDE.md: как написать инструкции для Claude Code: что класть в файл правил, чтобы агент их выполнял
- Как сэкономить токены на MCP с Tool Search в Claude Code: почему инструменты MCP съедают окно и как отложить их загрузку
- Мультиагенты OpenAI Codex: как разделить работу между агентами в Codex
- Паттерны воркфлоу AI-агентов: цепочки, маршрутизация и оркестрация по гайду Anthropic


