Память AI-агентов: почему хранить всё подряд не работает
За полтора месяца мои агенты записали в общую память 78 809 фактов. Разбираю на своей системе, что хранить, где, как доставать и почему складывать всё подряд не работает.
· обновлено · 12 мин
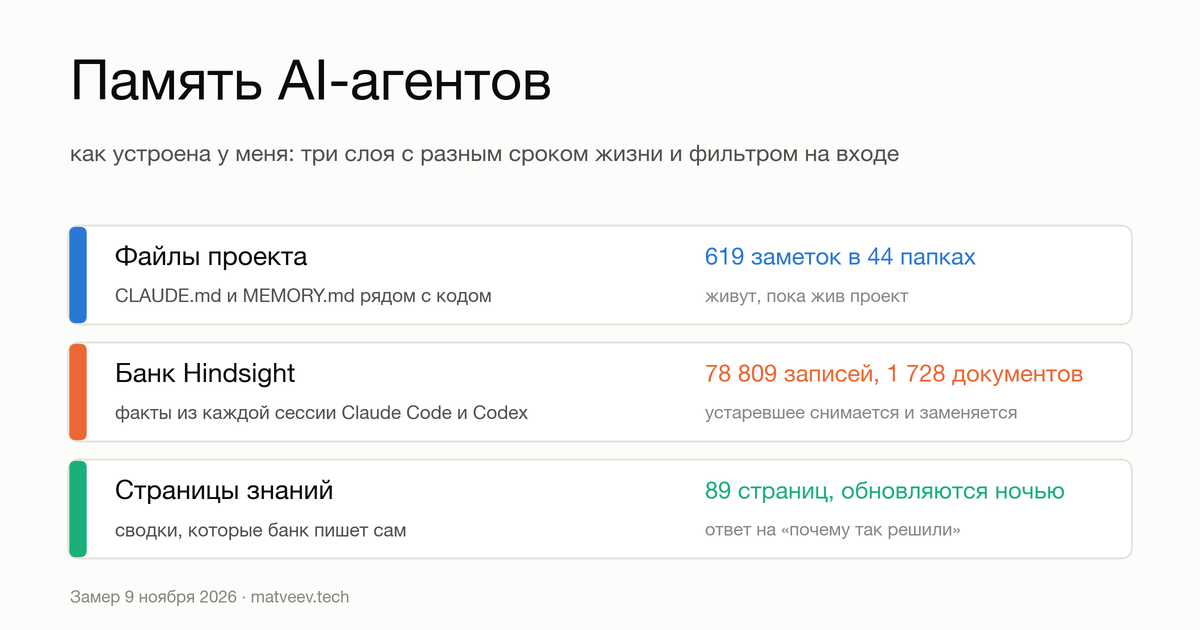
С 28 сентября мои агенты записали в общую память 78 809 записей (замер по API 9 ноября 2026). Память AI-агентов у меня это три слоя с разным сроком жизни и фильтром на входе: файлы рядом с кодом, банк фактов Hindsight и страницы знаний, которые банк пишет сам. Складывать всё подряд не работает: первая система на этом и сломалась.
В январе я пересказал здесь чужой разбор о памяти по образцу человеческой: фильтр на входе, консолидация, забывание. Тезис был правильный, но доказательств у меня тогда не было. За десять месяцев я построил такую память дважды. Первая система с июня по сентябрь упиралась в оперативную память сервера, и я её заморозил. Вторая работает с конца сентября на Claude Code и Codex. Ниже разбираю на ней, что сохраняется, где лежит, как агент это достаёт, как память исправляется и что ломалось. Обзор самих инструментов (RAG, mem0, Graphiti, Letta) вынесен в отдельную статью про память AI-агентов: контекст, RAG, графы и mem0.
Что мои агенты запоминают и где это лежит
Коротко: правила и ловушки проекта лежат в файлах рядом с кодом, факты из каждой сессии уходят в общий банк на моём сервере, а сводки по проектам банк собирает сам. У каждого слоя свой срок жизни и своя цена.
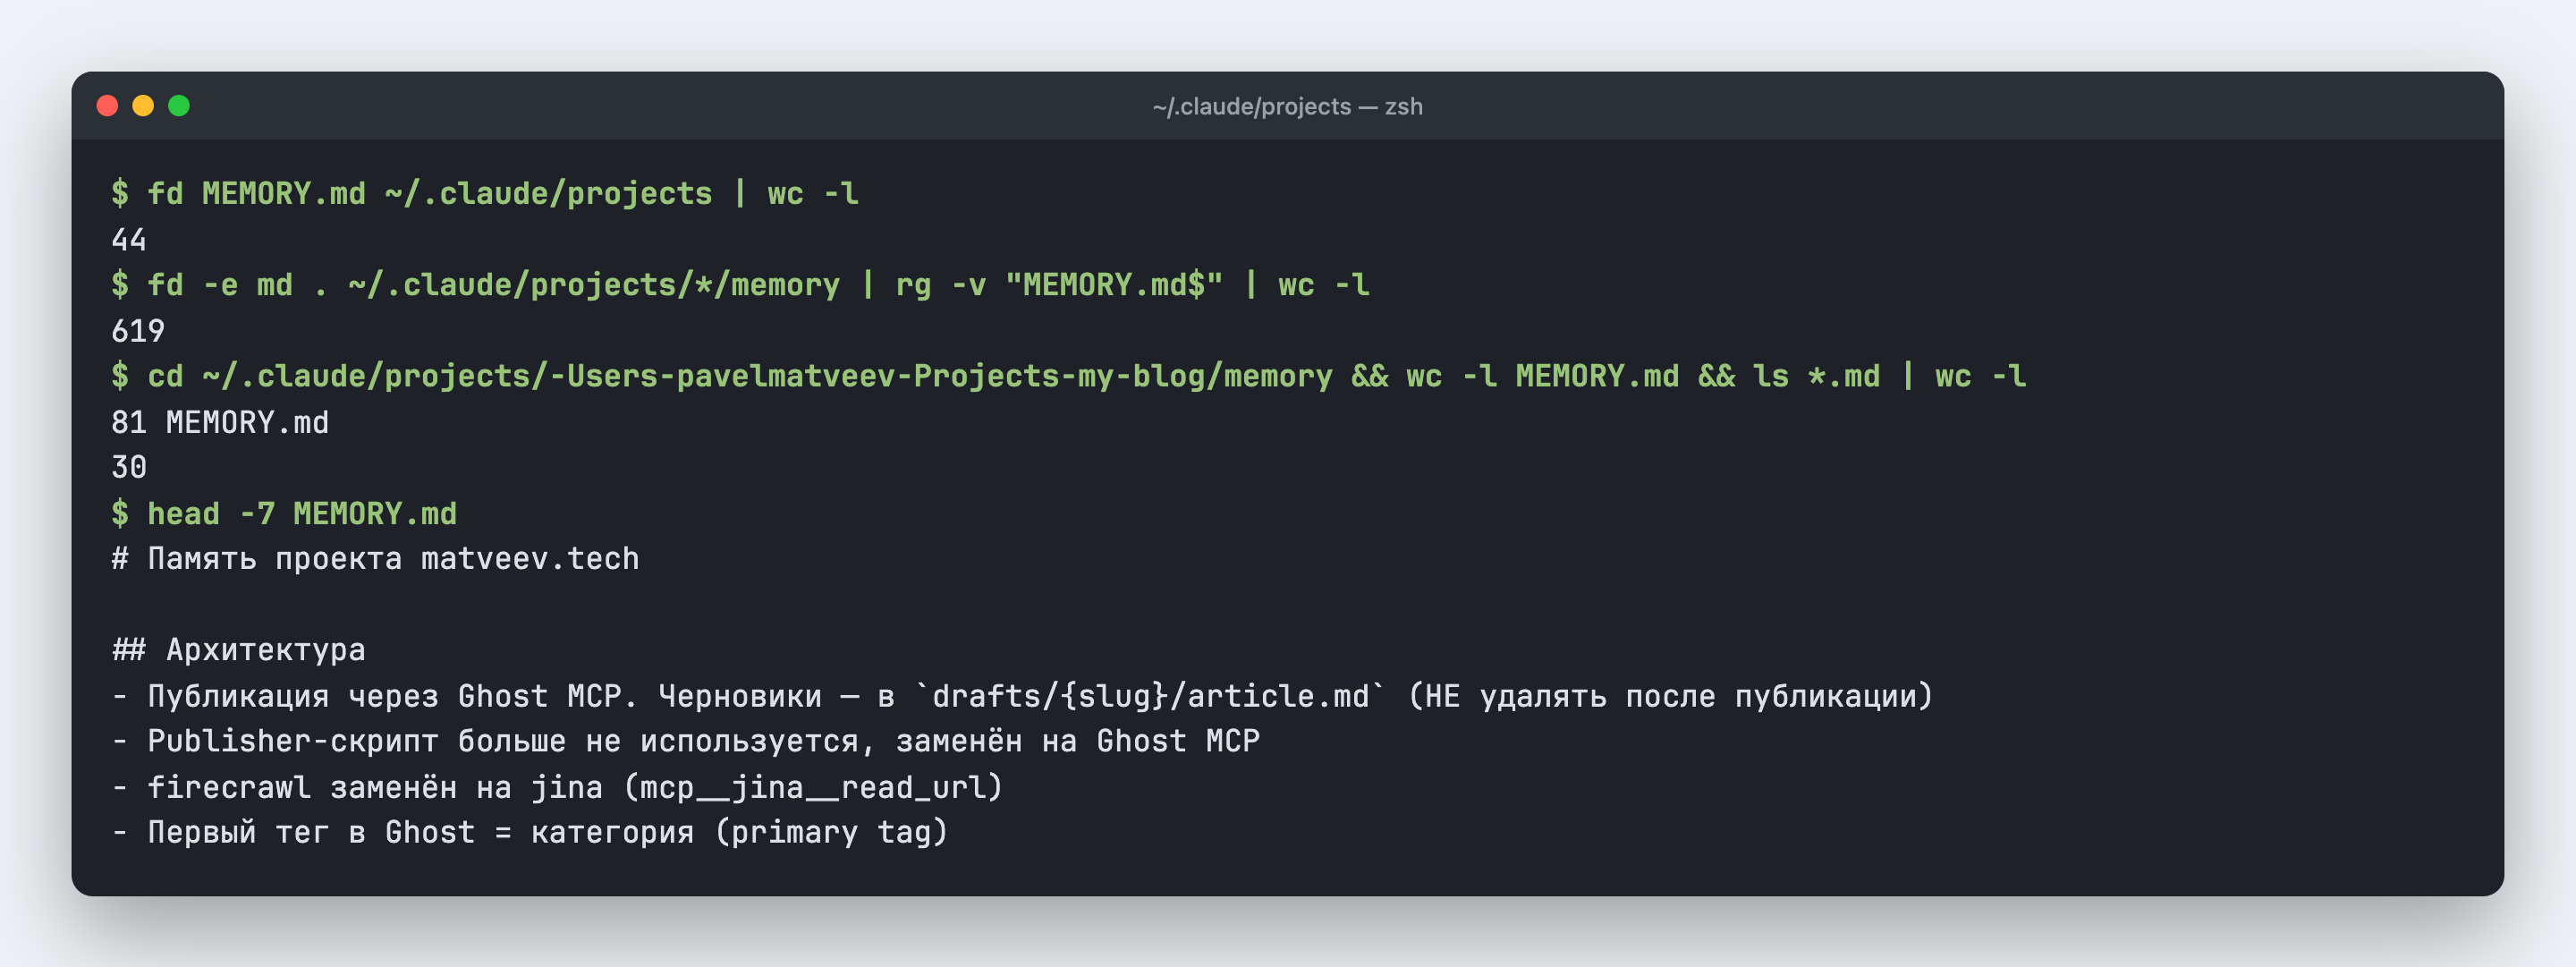
Файлы проекта. Claude Code ведёт для каждого проекта папку памяти ~/.claude/projects/<проект>/memory/: файл MEMORY.md служит оглавлением, каждая заметка лежит отдельным файлом. В сессию загружаются первые 200 строк оглавления, остальное агент читает по необходимости (документация Claude Code). На 9 ноября у меня 44 такие папки и 619 заметок. У этого блога 29 заметок и оглавление на 81 строку: как публиковать в Ghost, где лежат шаблоны блоков, какие правки я просил не повторять. Сюда попадает то, что не вывести из кода: ловушки инфраструктуры и мои поправки агенту. Как устроены эти файлы, я разбирал в гайде про память Claude Code, а что класть в сам файл правил, в статье про CLAUDE.md.
Банк фактов. Всё, что происходит в сессиях Claude Code и Codex, уходит в Hindsight, открытую систему памяти от Vectorize под лицензией MIT. Я держу её на своей виртуалке, данные лежат в Postgres с pgvector. Банк один на все проекты, называется pavel, проект помечается тегом. Внутри на 9 ноября 78 809 записей трёх видов: 21 292 факта о мире (что где лежит, какие версии), 28 267 фактов-опыта (что делали агенты и чем кончилось) и 29 279 наблюдений, которые сервер собрал из фактов. Сырые сессии хранятся как документы, их 1 728.
Страницы знаний. Это сводки, которые банк пишет сам по наблюдениям: карта компонентов, ключевые решения с причинами, соглашения, по странице на каждую крупную задачу. Их 89, обновляются ночью по расписанию. На момент замера 85 из 89 стояли с пометкой «ждёт обновления»: с прошлой ночи в банк уже записали новое. Vectorize описывает страницы как проекцию памяти: удалишь страницу, и она соберётся заново из наблюдений. У меня их никто не правит руками, и за полтора месяца ни одна не потерялась.
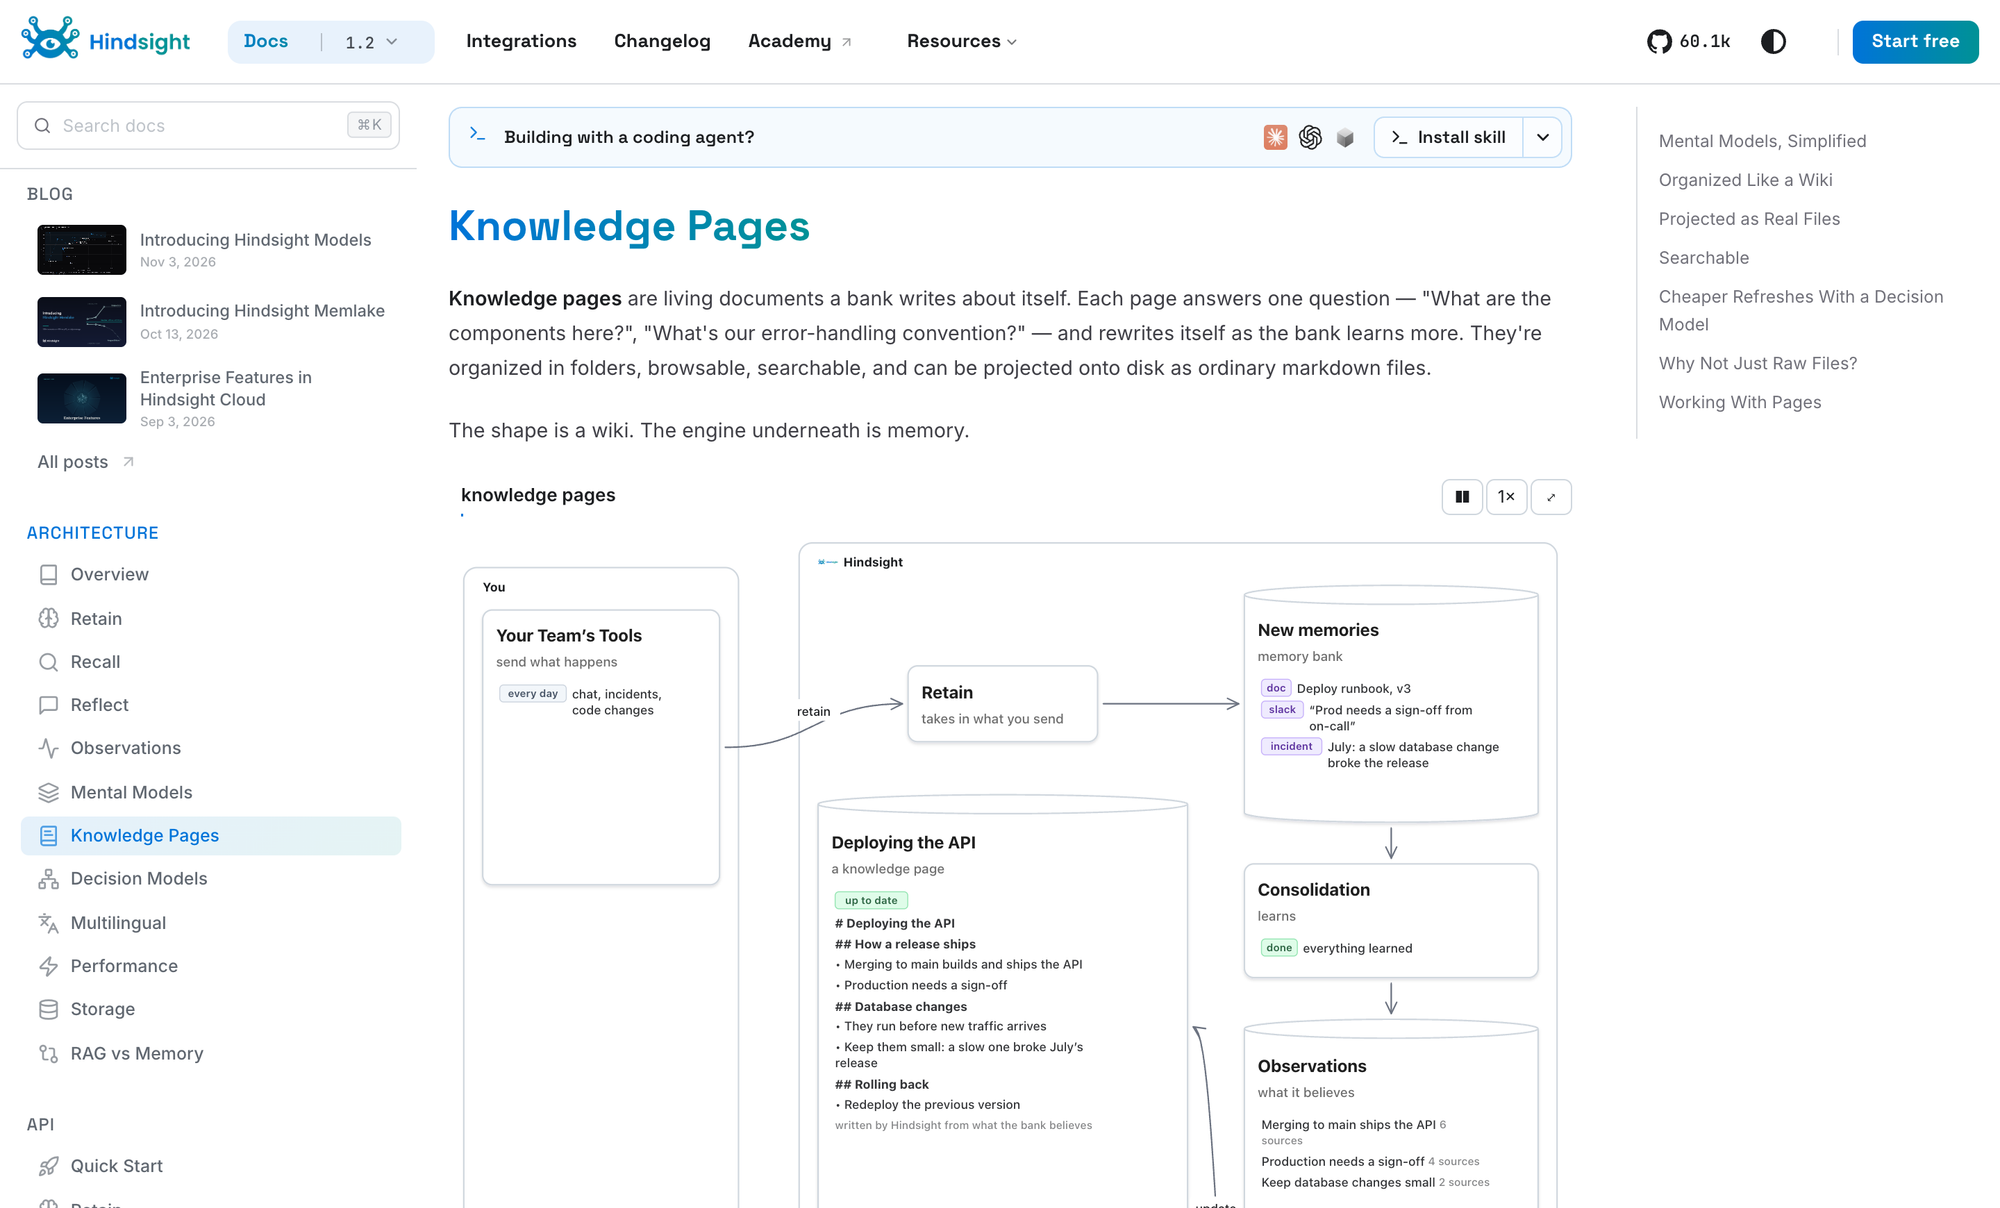
Бытовая аналогия такая. Файлы это стикеры на мониторе, банк это блокнот, куда записано всё за день, а страницы знаний это чистовик, который переписываешь по блокноту раз в неделю. Стикер читаешь мгновенно, блокнот надо листать, а чистовик отвечает на вопрос «как мы к этому пришли».
Как память попадает в агента во время сессии
Агент не ходит в память сам по себе. За него это делают хуки плагина hindsight-coding-agents и два MCP-сервера, которые я подключил к Claude Code и Codex. Путь факта за одну сессию выглядит так.
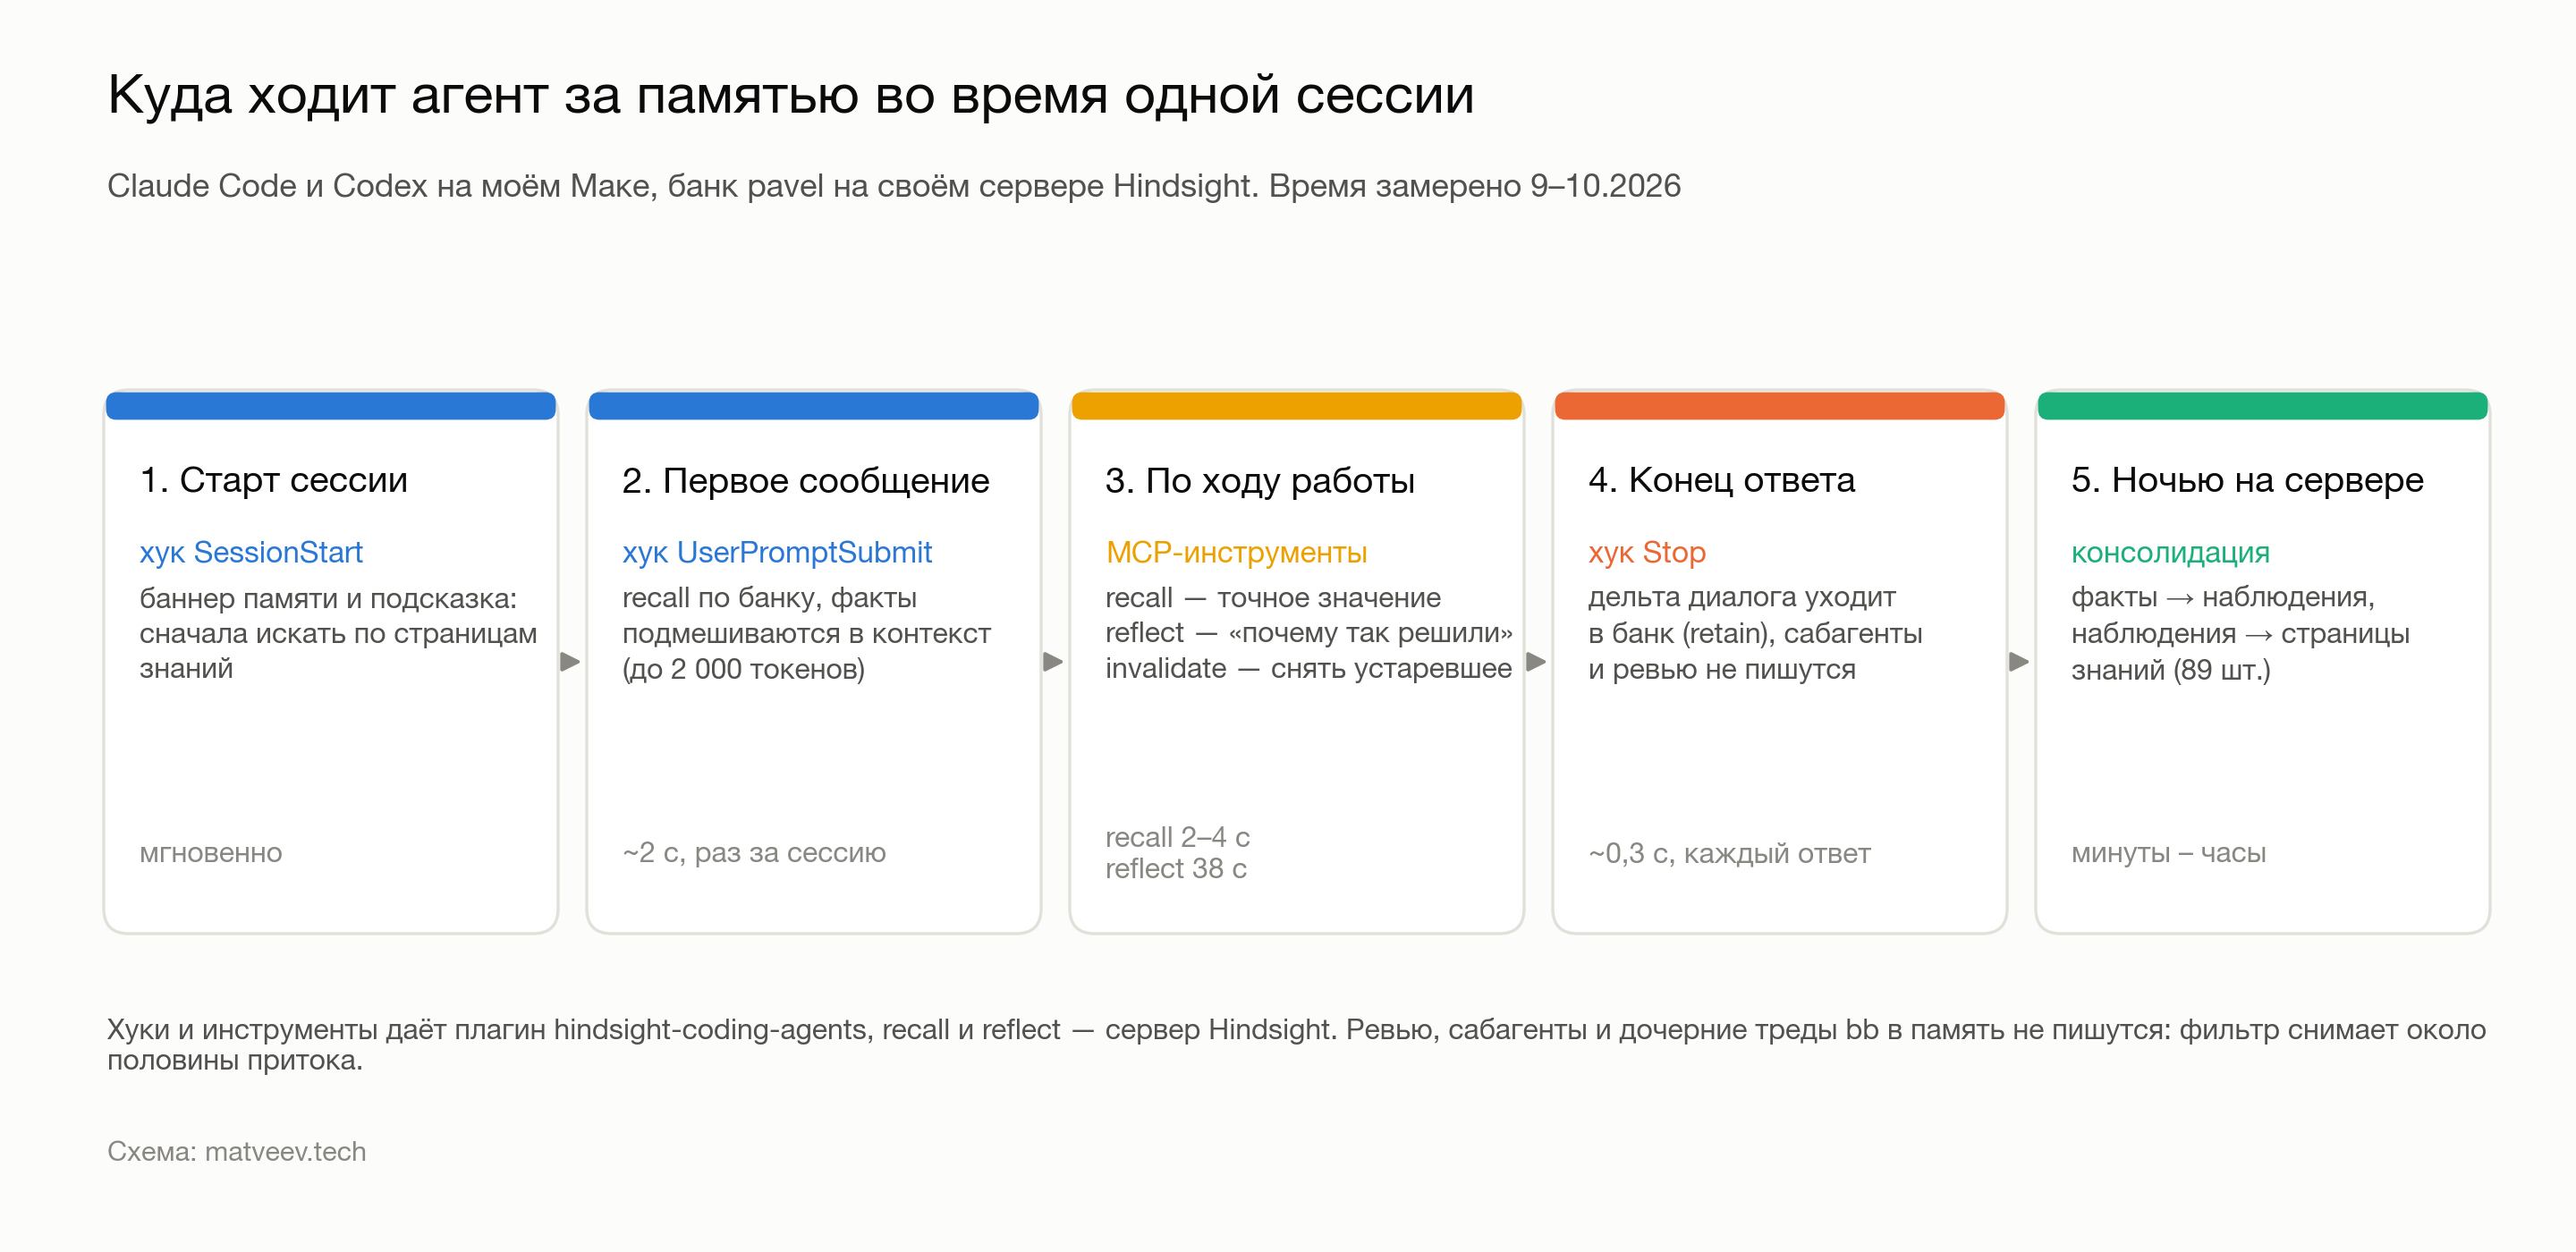
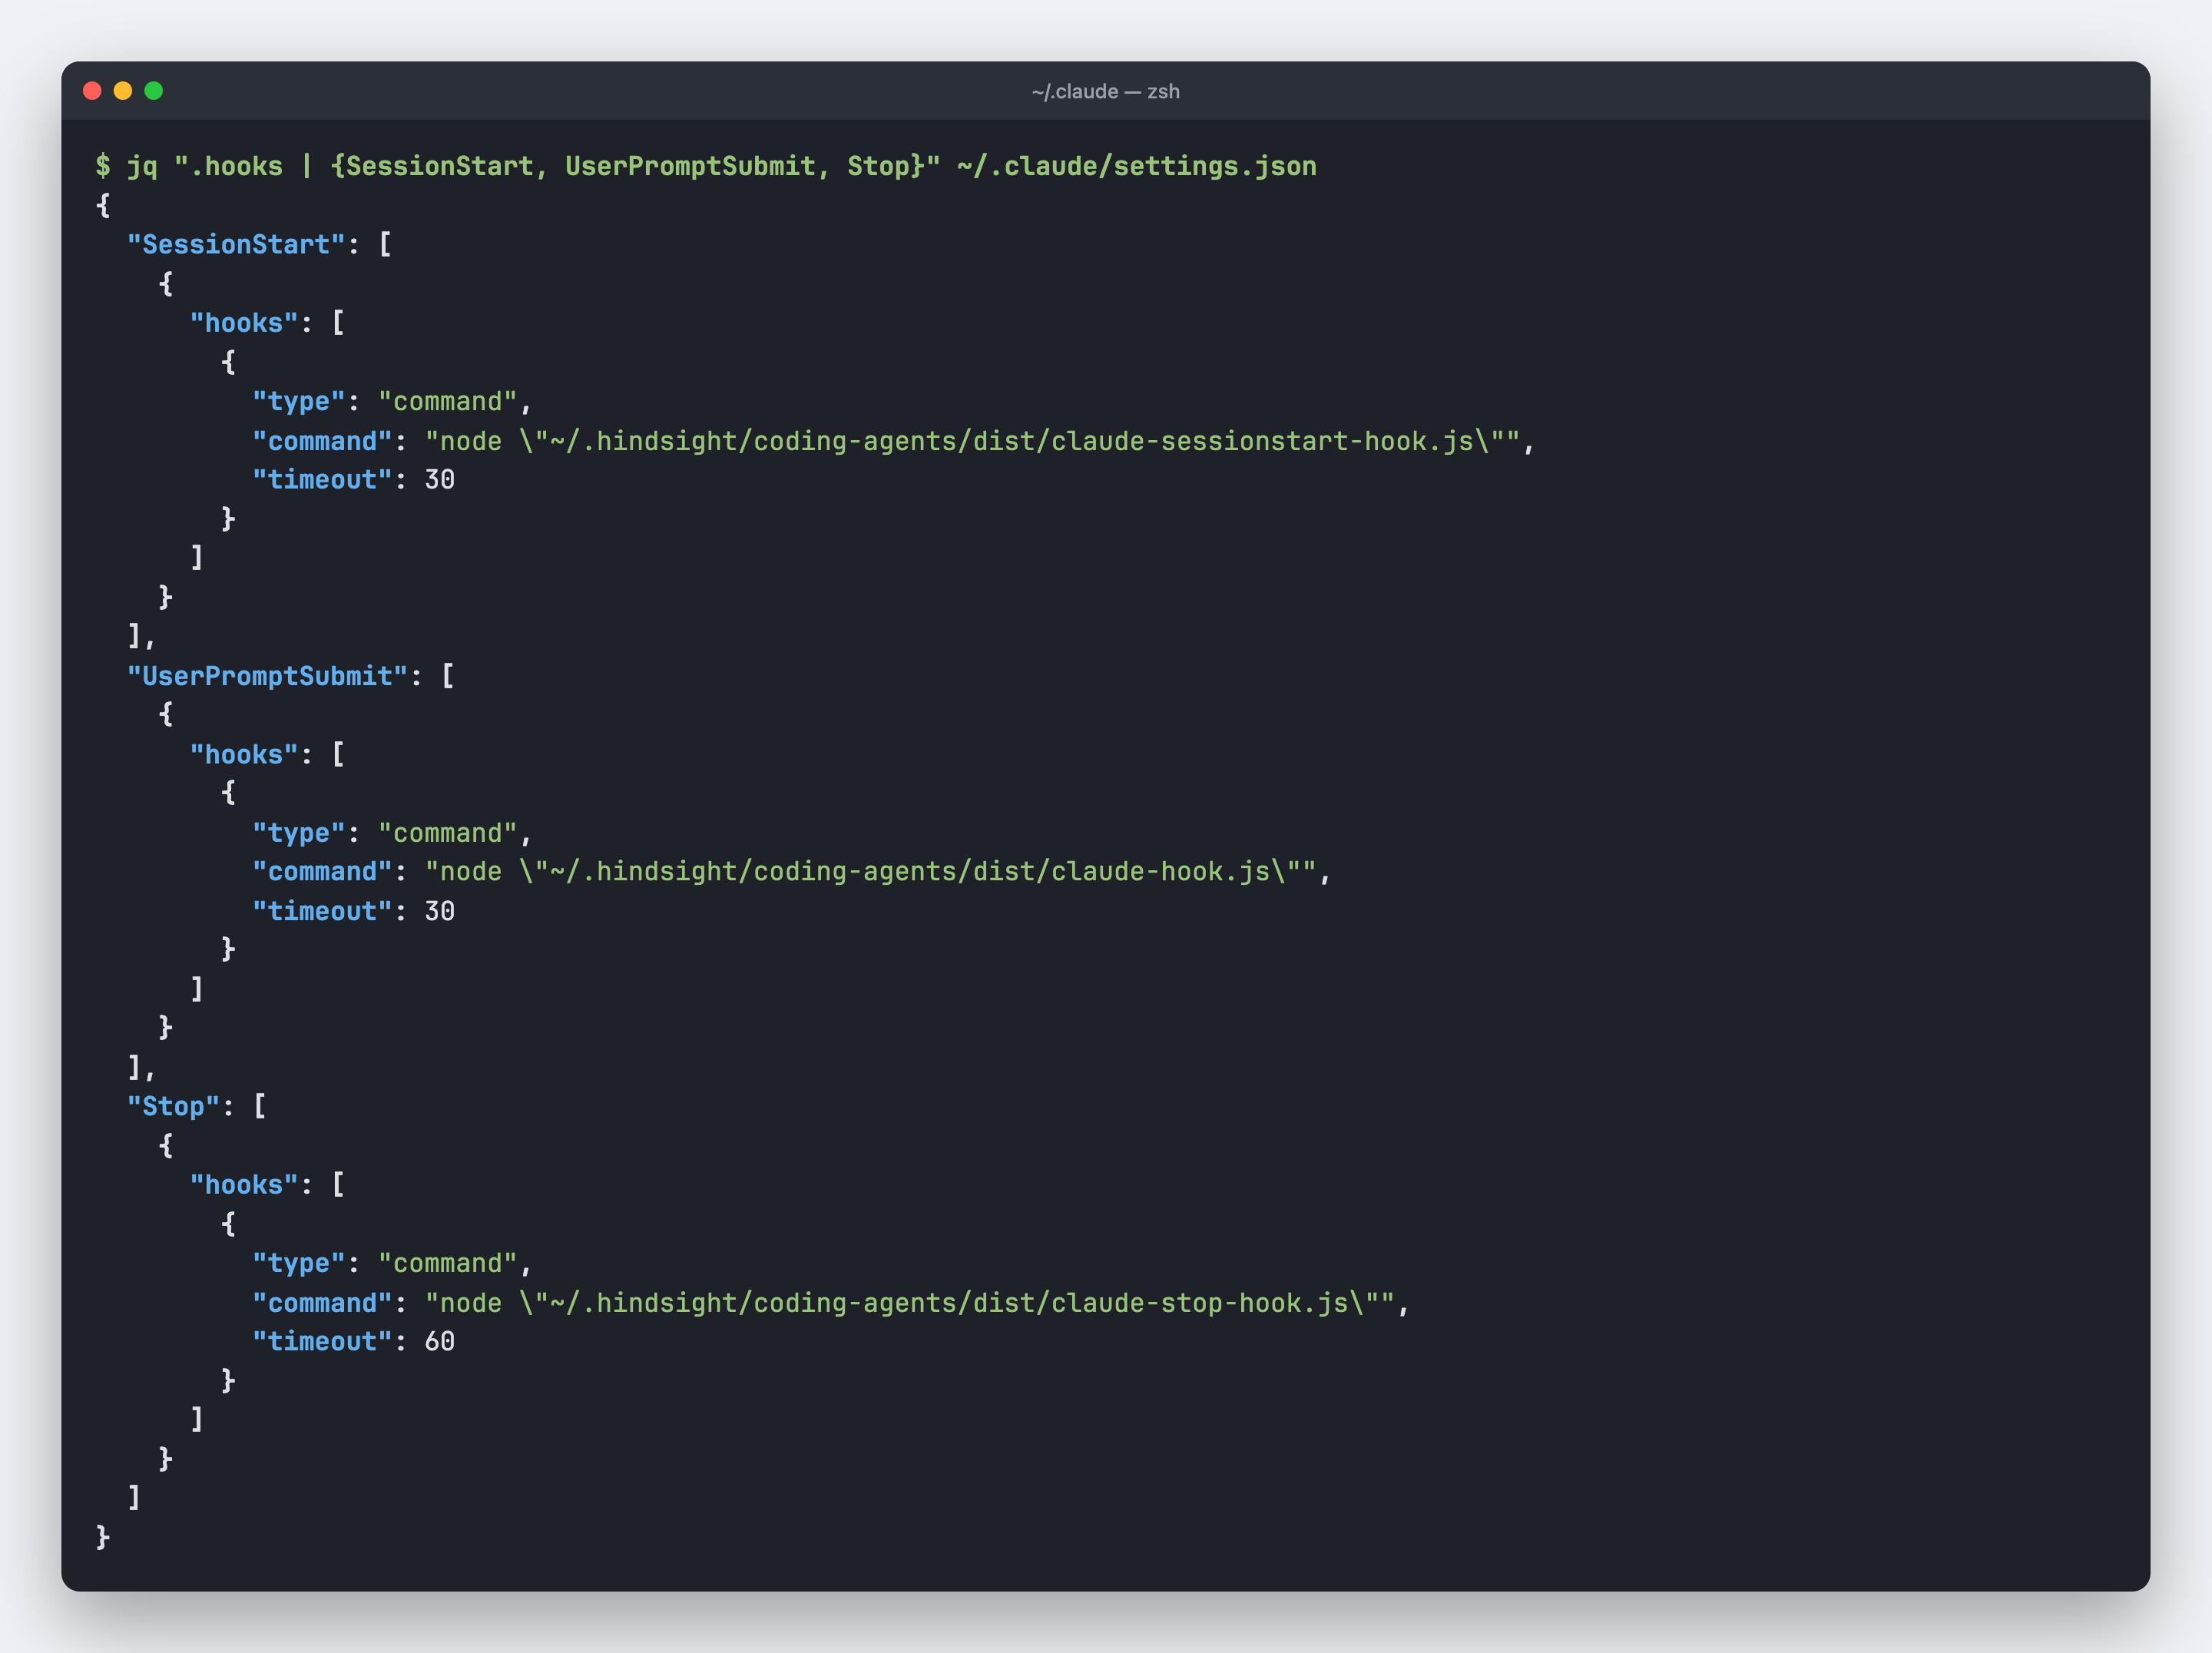
Хуки стоят в ~/.claude/settings.json для Claude Code и в ~/.codex/hooks.json для Codex, по три на агента. SessionStart выводит баннер памяти и напоминает агенту: сначала ищи по страницам знаний, reflect зови только если их мало. UserPromptSubmit на первом сообщении делает recall по банку и подмешивает найденное в контекст, у меня это до 2 000 токенов. Stop после каждого ответа отправляет в банк дельту диалога.
Вот как это выглядело в сессии, где я писал эту статью. На первое сообщение хук подмешал 18 фактов: адрес черновика соседней статьи о памяти, решение снять с неё тег AI, правило сохранять копии статей со слогом -refresh. Два факта повторяли друг друга, ещё два были про другую статью. Полезных вышло примерно две трети, и это обычный результат для подмешивания без фильтра по проекту.
Дальше агент работает с памятью сам, через MCP. В ~/.claude/CLAUDE.md у меня правило: точное значение и текущее состояние спрашивай у recall, «почему так решили» у reflect, а устаревший факт снимай через invalidate_memory. Как подключать такие серверы, я писал в гайде по MCP для Claude. Разница в цене вызова большая, я замерил её 9 ноября на полном банке.
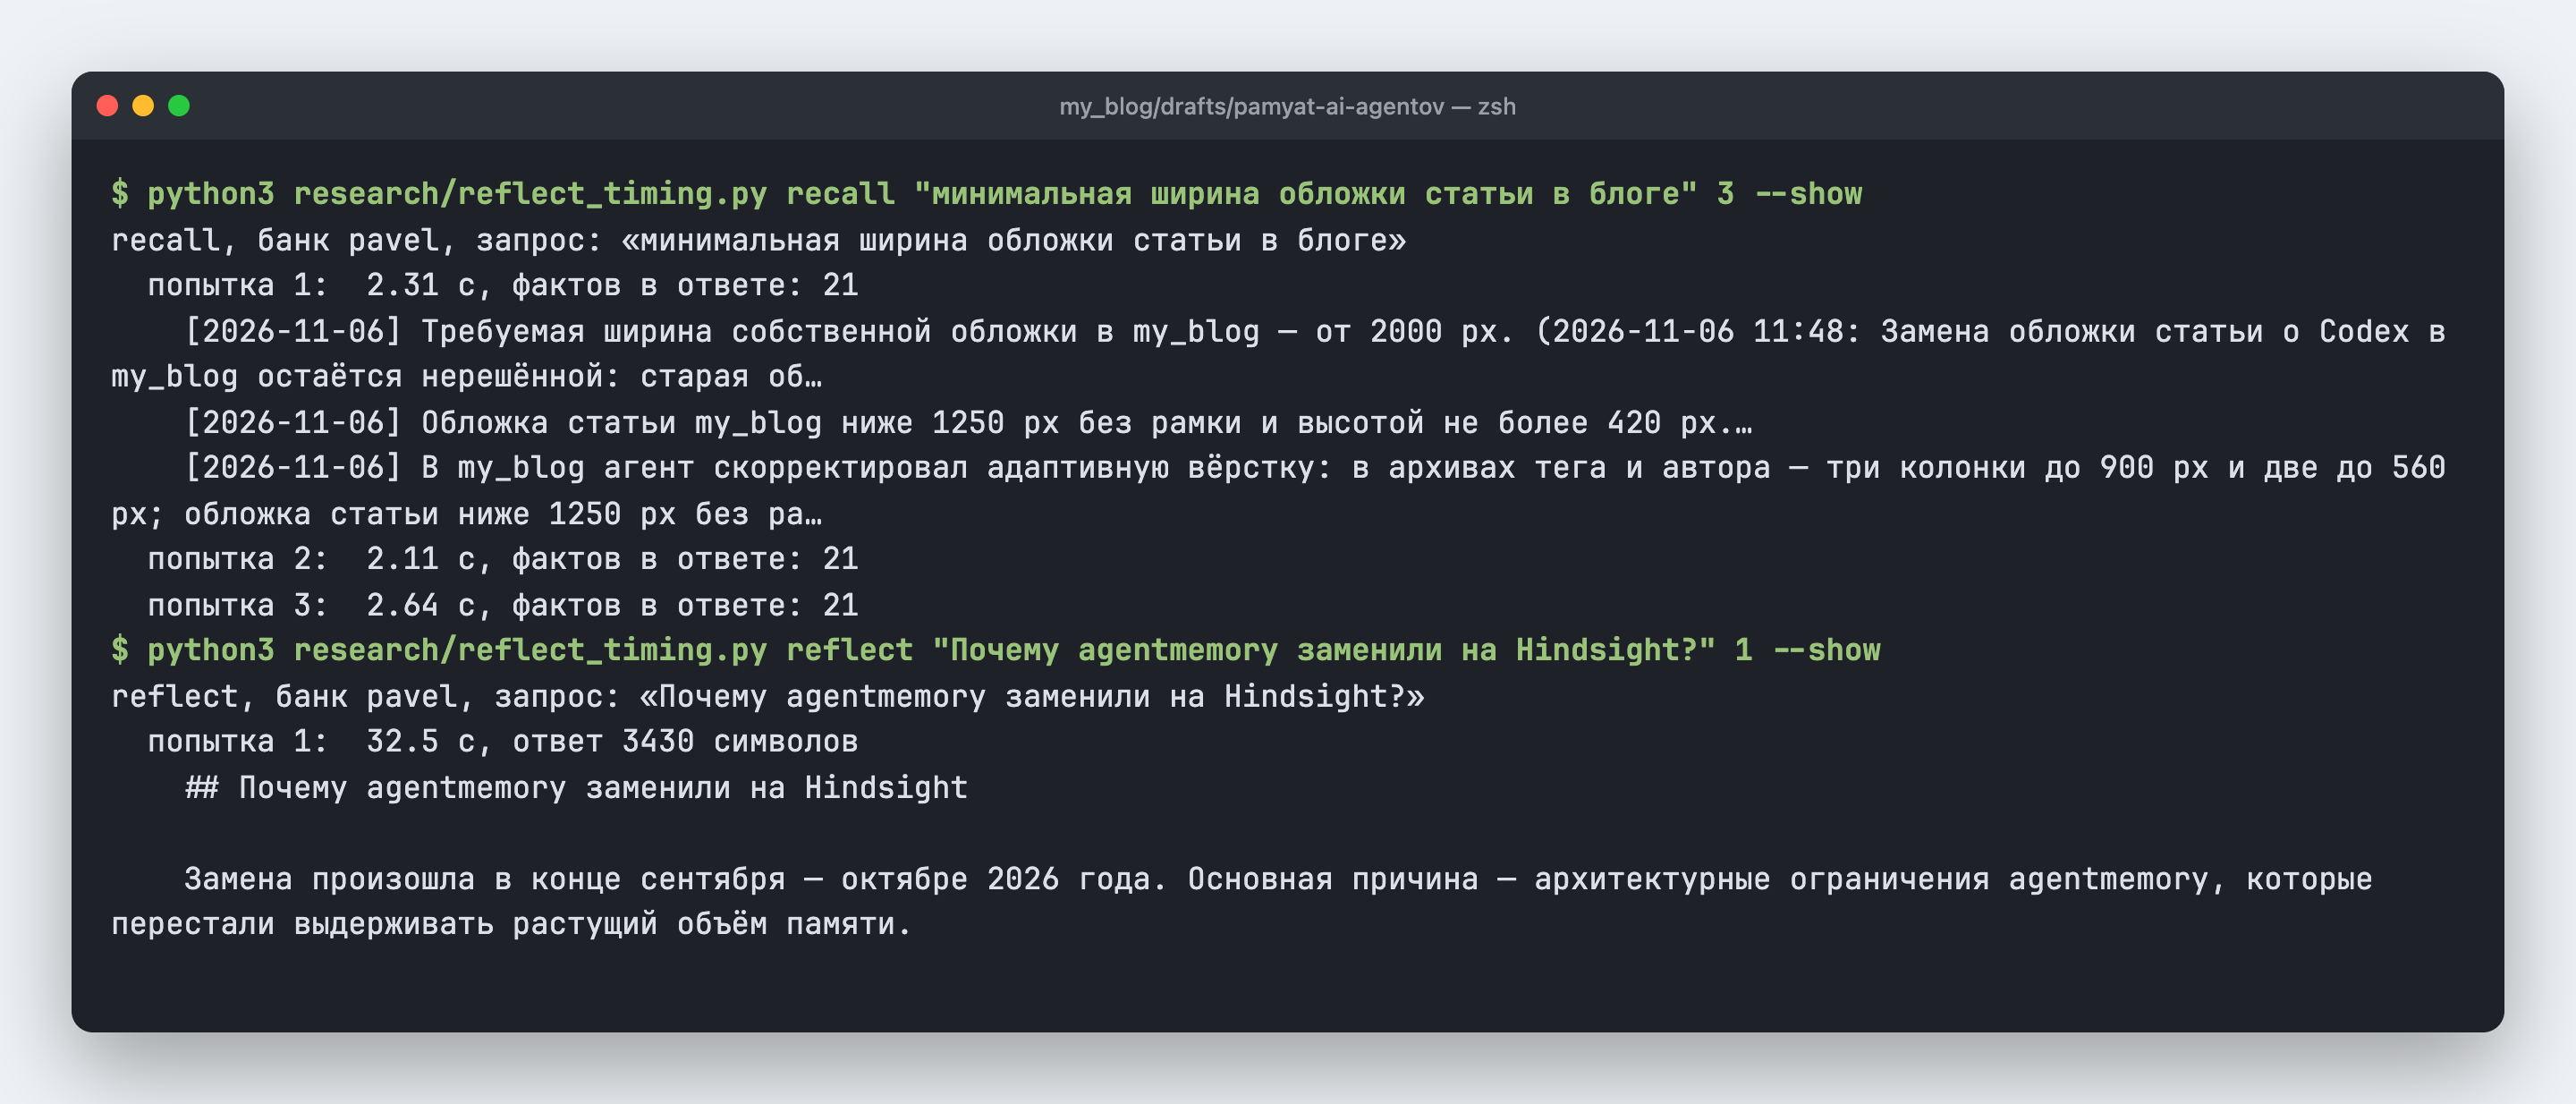
Recall через REST занял 2,1–2,6 секунды, через MCP-сервер 3,5–4 секунды: накладные расходы протокола. Reflect с лёгким бюджетом ответил за 32–38 секунд. Плагин зовёт reflect с полным бюджетом, и в конце сентября такой вызов на моём банке занимал около 100 секунд, поэтому в хук я его не пускаю: подмешивание идёт через recall.
| Операция | Что даёт | Время у меня, 9.11.2026 | Когда зову |
|---|---|---|---|
| Подмешивание хуком | до 2 000 токенов фактов по первому сообщению | ~2 с, раз за сессию | само, на старте |
| recall | список фактов с датами по запросу | 2–4 с | точное значение, статус задачи |
| reflect | связный ответ по всей памяти | 32–38 с с лёгким бюджетом, ~100 с с полным | «почему так решили» |
| invalidate_memory | помечает факт устаревшим, обратимо | мгновенно | факт разошёлся с реальностью |
Что сломалось за год и почему первая система не выжила
Первой общей памятью у меня был agentmemory, открытый проект на движке iii (30 тыс. звёзд на 9 ноября 2026). Он подкупал тем, что ставился одной командой и не требовал базы данных: весь стор, индексы и граф живут в оперативной памяти процесса. Это же оказалось его пределом.
Август 2026: память сервера. 11 августа контейнер занял 12,4 из 15,6 ГБ виртуалки и сработал критический алерт. К 23 августа база выросла до 4,2 ГиБ: около 3 ГБ занимал индекс BM25 из 1 501 шарда, ещё 900 МБ граф. Сервис падал по OOM несколько раз, Docker его не поднимал, ещё в июле пришлось ставить autoheal.
23 сентября: предел формата. Файл рёбер графа дорос до 1 ГиБ, предела формата хранения. Движок не мог его сохранить и каждые пять секунд заново сериализовал весь граф. 96% объёма графа занимали списки идентификаторов наблюдений, у одного узла их было 59 012. Рядом лежали 2,9 ГБ брошенных поколений индекса от прерванных сохранений. Движок падал по 10–15 раз в час.
24 сентября: диск. Запись на диск доходила до 198 ГБ в сутки, почти половина всей записи на хосте. Движок переписывал файл каждого изменённого скоупа целиком раз в пять секунд, а извлечение графа запускалось на каждый конец сессии, 278 раз в сутки по полгигабайта. Я выключил извлечение графа, запись упала, но индекс в памяти никуда не делся.
30 сентября: время в чате. Последней каплей стала скорость. Синхронные хуки agentmemory добавляли около 1,5 секунды к каждому ответу и 0,2–0,5 секунды к каждому вызову инструмента. При медиане в семь вызовов на ход это три секунды, в тяжёлом ходе с тридцатью вызовами 8–15 секунд ожидания. 30 сентября я заморозил agentmemory, 12 октября остановил контейнер: им уже никто не пользовался, но он каждые несколько минут запускал консолидацию через LLM и держал 8,7 ГБ памяти.
Мораль у истории простая. Память агентов растёт быстрее, чем кажется: у меня за три месяца набралось около 3 000 сессий и 222 тысячи наблюдений. Хранилище, которое держит всё это в оперативной памяти и переписывает файлы целиком, на таком объёме перестаёт работать. Hindsight живёт в Postgres, и этот класс проблем ушёл.
Почему память AI-агентов нельзя наполнять всем подряд
Смена хранилища не отменила главную проблему: в память пишется каждая сессия. Тестовые прогоны и ревью, сабагенты, которые разбирают один файл и исчезают, дочерние треды, где агент просто выполняет поручение. Весь этот поток извлекается в факты, консолидируется и потом всплывает в recall.
Замер притока за две недели, с 14 по 28 октября 2026, дал 16 358 фактов, около 1 170 в сутки. Потом я прогнал по ним фильтр, который отличает живую работу от служебных сессий. Вышло, что 51% фактов пришли из ревью через codex exec, дочерних тредов bb и вызовов Codex по поручению Claude. С 28 октября плагин такие сессии не пишет, и приток упал примерно до 530 фактов в сутки.
HINDSIGHT_RETAIN_SESSIONS=false claude: хук Stop её не запишет, а подмешивание на старте останется.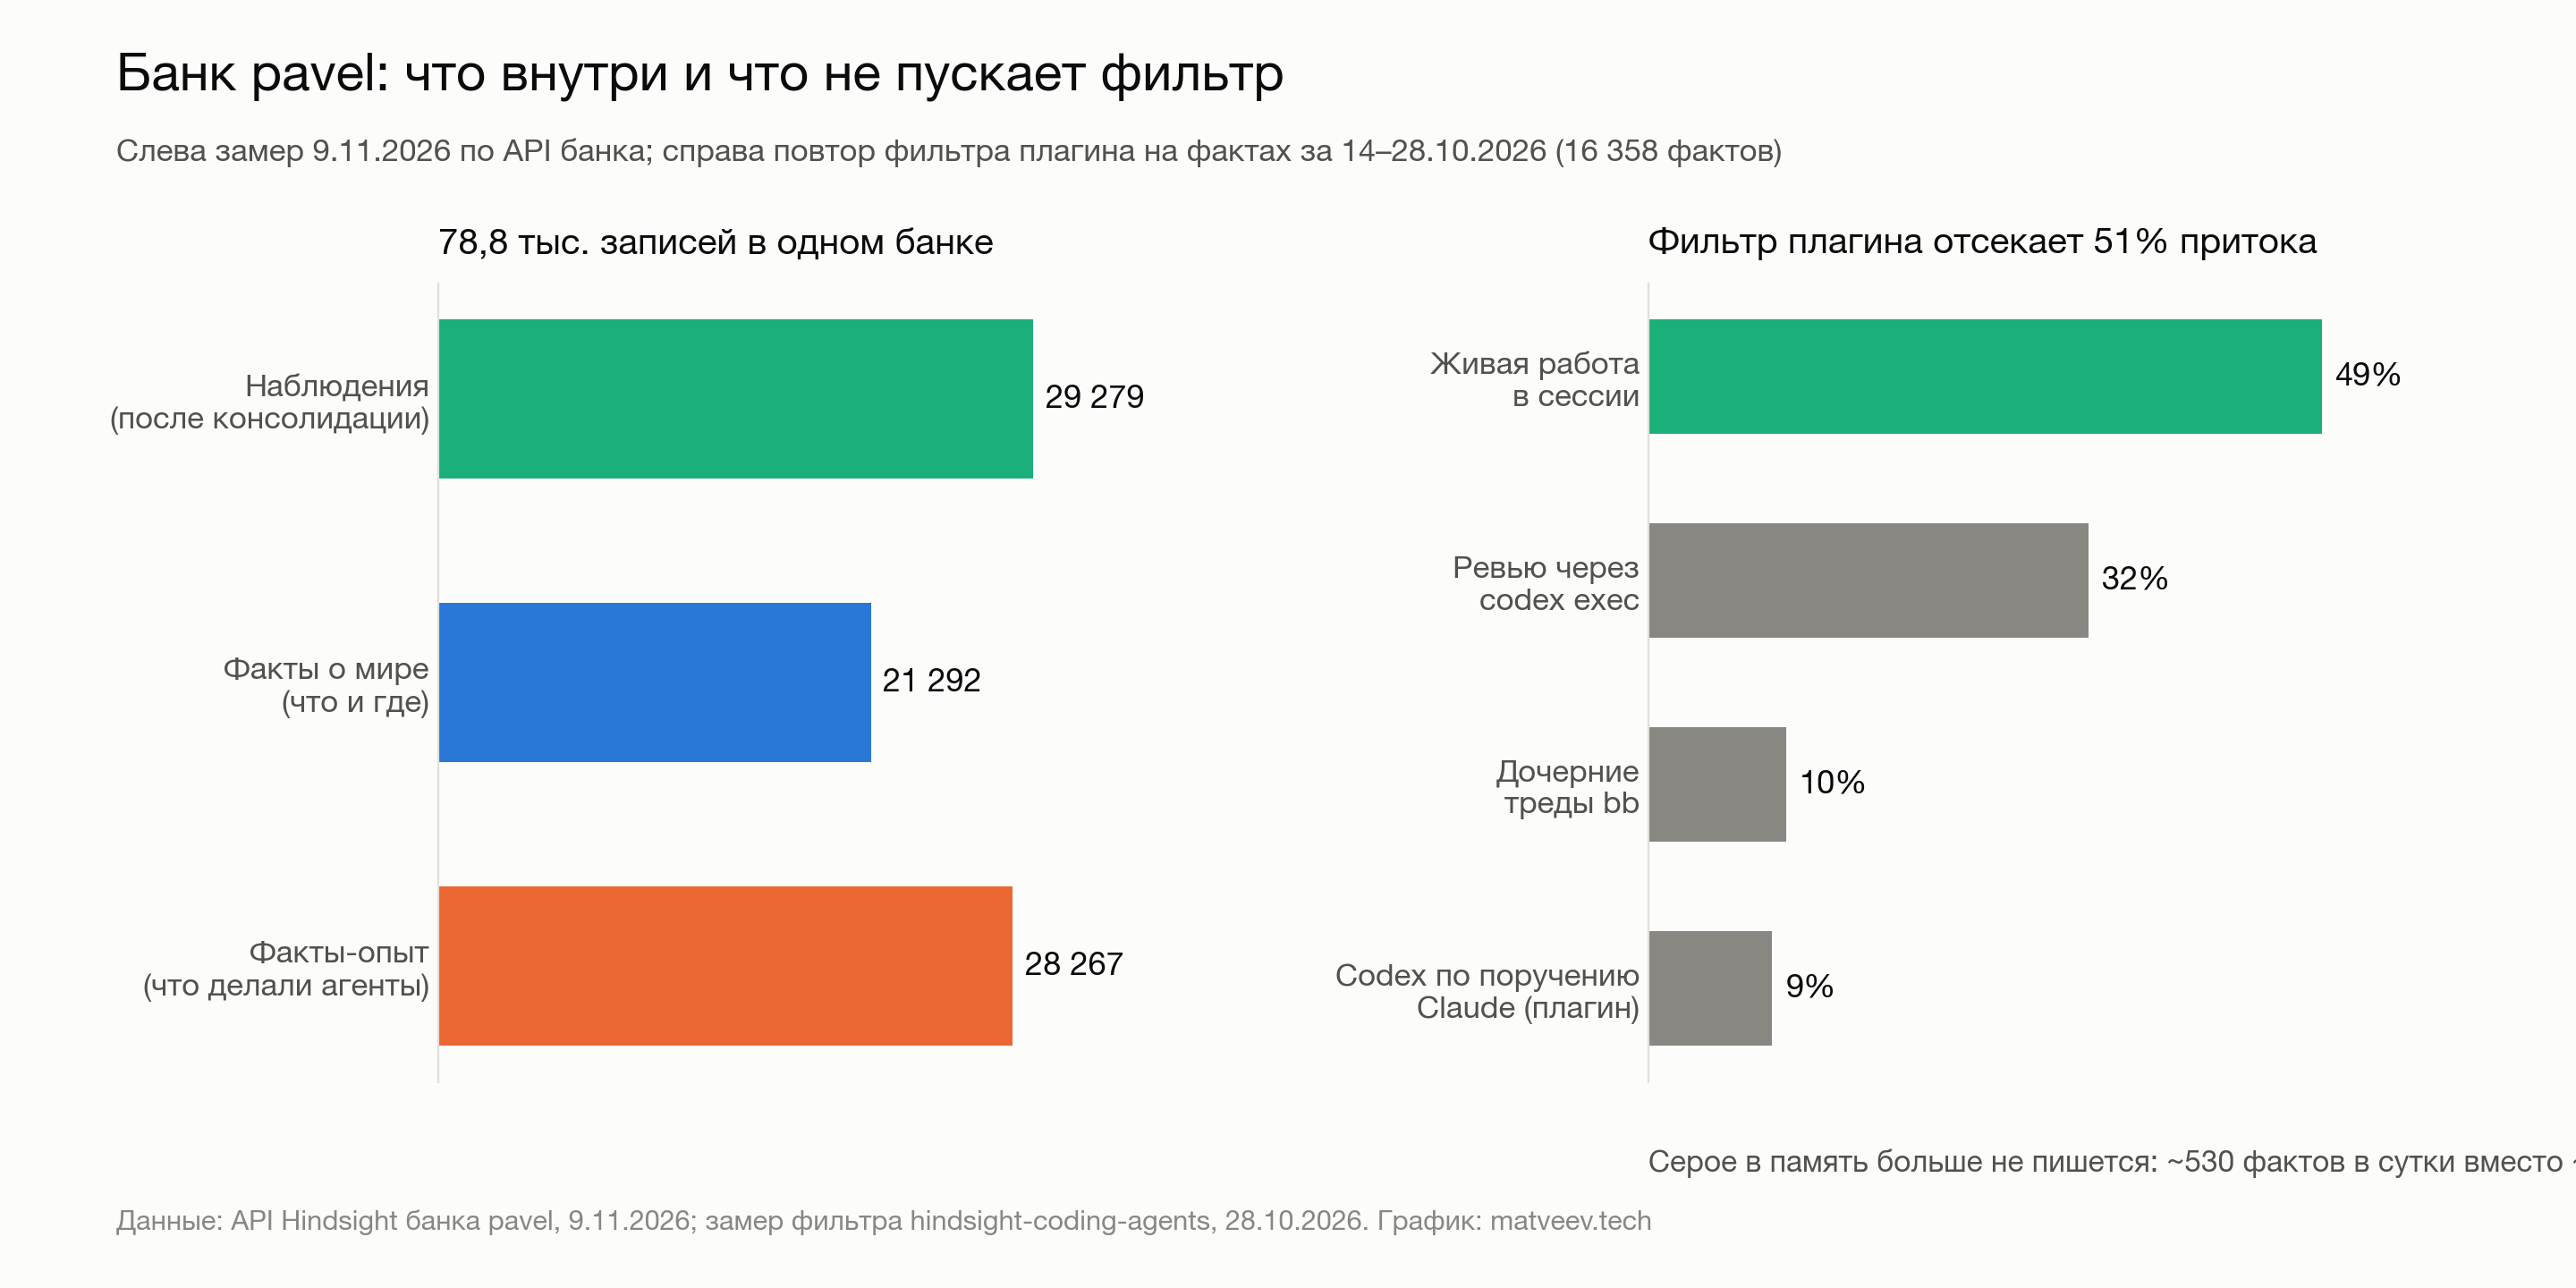
Второй фильтр стоит на входе в сам банк. У банка есть миссия извлечения, текст, по которому модель решает, что считать фактом. В моей миссии четыре вида фактов: решения с причинами и отвергнутыми вариантами, инфраструктура (хосты, пути, версии, где что запущено), инциденты с уроками и предпочтения людей. Отдельно сказано, чего не извлекать: сиюминутный вывод команд, списки файлов, промежуточные шаги без итога. Значения секретов не сохраняются, только место, где секрет лежит.
Без таких фильтров recall превращается в шум. Пример с кадра выше: на вопрос про минимальную ширину обложки первый факт отвечает точно («от 2000 px»), а второй и третий уже про адаптивную вёрстку архивов. И это при узком запросе. Замер 24 октября показал цену подмешивания: первый ход Claude Code стоил 65,3 тыс. входных токенов, из них около 3,8 тыс. добавляла подборка из памяти, и часть заметок была не про этот проект. Я оставил как есть: попадания в цель перевешивают промахи, но это компромисс. Как считать такие расходы, я разбирал в статье про экономию токенов в Cursor и Claude Code.
Как память исправляется и забывает
Самое ценное в этой схеме то, что память умеет меняться. У меня работают четыре механизма.
Консолидация. После каждой записи сервер в фоне сводит новые факты в наблюдения: одно устойчивое утверждение вместо десятка пересказов, со ссылками на исходные факты (как это устроено). В миссии наблюдений у меня записано: более свежий факт о том же предмете отменяет старый, с пометкой, что изменилось и когда. Проверка 30 сентября показала границу: пока исправление («порт сменился») не прошло консолидацию, recall ставит старый факт выше нового. После консолидации, это минуты, первым идёт наблюдение с актуальным значением.
Директива свежести. У банка одна директива: к каждому факту в ответе указывать дату, а если факту больше 30 дней или он описывает изменчивое состояние, предупреждать, что он мог устареть. Поэтому recall у меня отдаёт факты с датами, как на кадре выше, а в CLAUDE.md записано правило: память это подсказка, состояние задач, веток и деплоев перепроверяй по репозиторию и серверам.
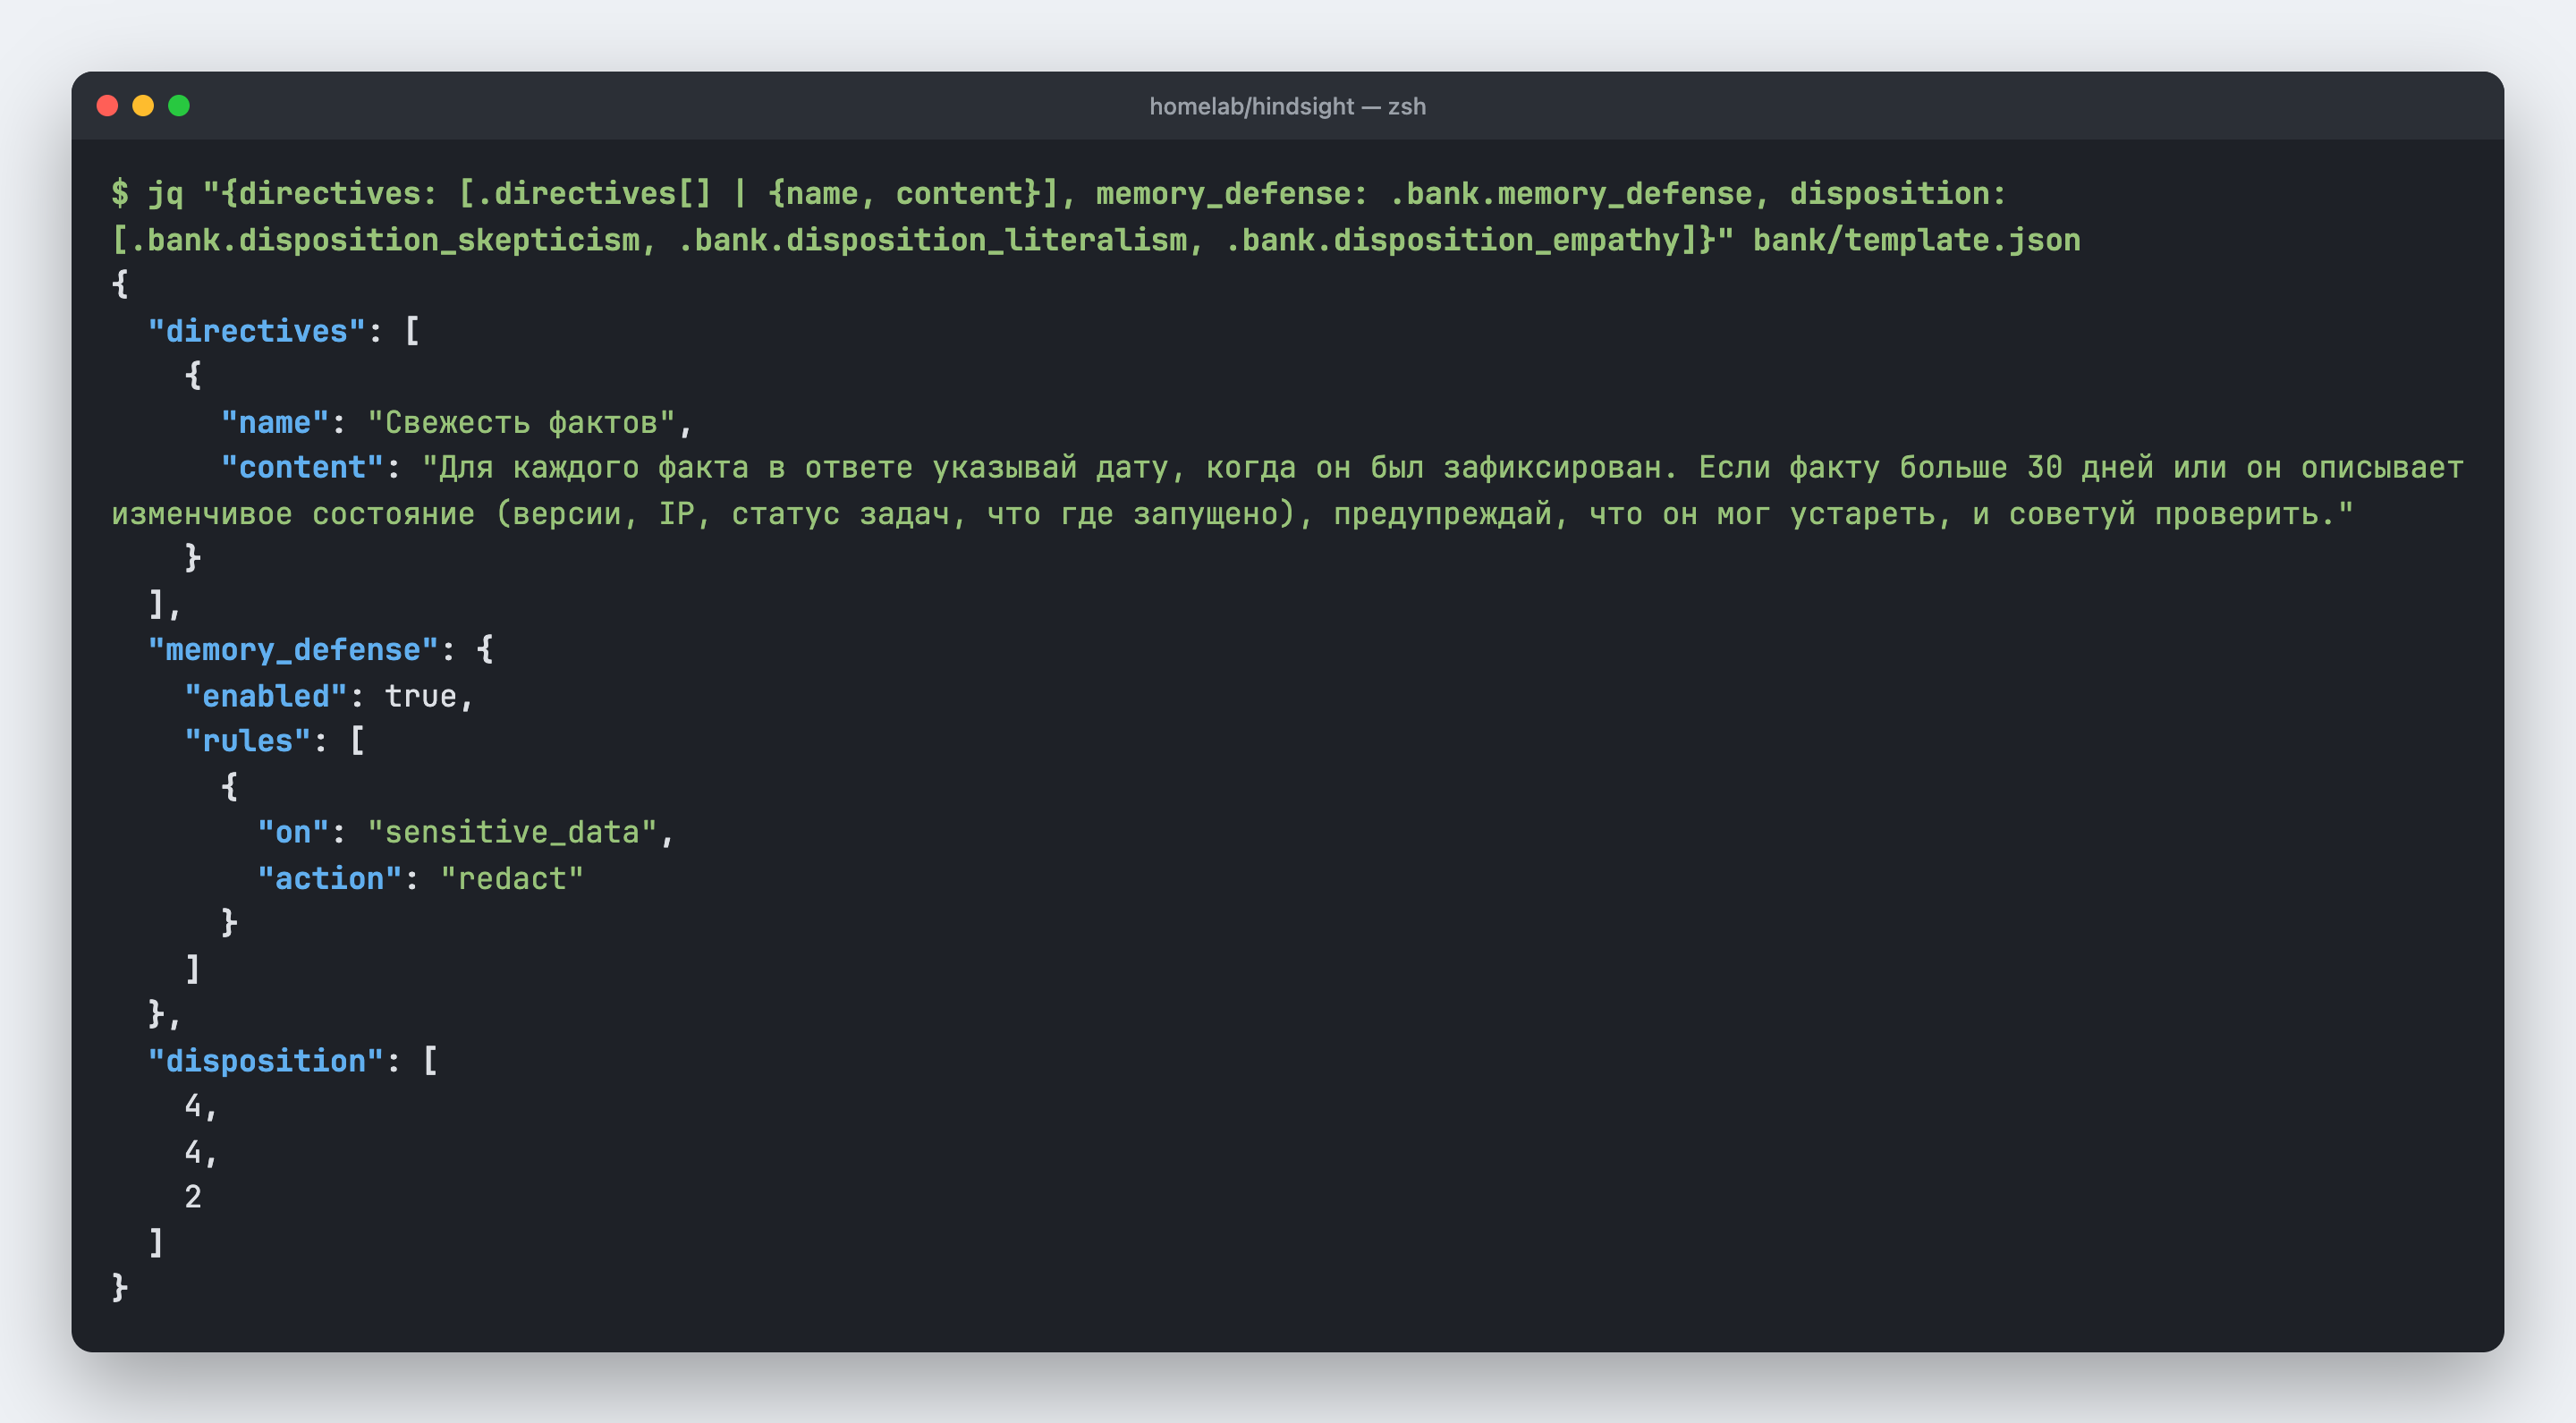
Снятие и исправление. Факт, который разошёлся с реальностью, агент помечает через invalidate_memory с причиной, и это обратимо. Для сложных случаев плагин предлагает документ-поправку: что память утверждала, что верно сейчас и чем проверено. Новый документ перевешивает старый при поиске. 24 октября я добавил к этому своё правило: устаревшее заменять новым. Пометка «устарело» рядом со старым текстом не спасает: пометки копятся, а агент всё равно читает старый текст.
Маскирование секретов. Memory Defense проверяет каждый retain по 45 шаблонам (ключи OpenAI и Anthropic, токены GitHub, строки подключения к базам) и заменяет совпадения на маркер до записи (документация). Приёмка 28 сентября нашла щель: ключ без известного префикса проходит мимо шаблонов, а исходный текст асинхронной задачи лежит в очереди в открытом виде. У меня хранение таких задач урезано до суток, минимум, который позволяет настройка, а секреты надо маскировать ещё на стороне клиента.
На чём крутится память и сколько она стоит
Hindsight ничего не делает без моделей: одна извлекает факты, другая сводит их в наблюдения, третья отвечает на reflect. Я подбирал их слепыми сравнениями и почти везде ушёл на подписки вместо API.
| Роль | Модель | Как платится | Почему так |
|---|---|---|---|
| Извлечение фактов (retain) | gpt-6.1-sol, низкое усилие | подписка ChatGPT через Codex | в слепом тесте 28.09 точность 4,9 из 5 против 4,5 у glm-5.3-flash; модели z.ai резали расширения в путях |
| Консолидация | grok-4.7-build-fast, запасная glm-5.3-flash | подписка SuperGrok | по качеству на уровне flash и в 2–3 раза быстрее; Sonnet 5.5 через API съела $30 за первые часы |
| Reflect | glm-5.3 без размышления | подписка z.ai | с размышлением медиана 130 с и таймаут у каждого пятого запроса, без него 57 с |
| Эмбеддинги и реранк | baai/bge-m3, cohere/rerank-v3.5 | OpenRouter | единственная статья расходов по API |
Цифры в таблице из моих замеров 28–30 сентября и 28 октября 2026. Про цену консолидации скажу отдельно. По токенам за две недели октября Sonnet 5.5 обошлась бы в $250–330 в месяц уже после фильтров, около $0,013 на факт. Для личной памяти это много, поэтому консолидация ушла на подписочный Grok, а в запасе стоит бесплатный flash. Если зависеть от подписок и облачных моделей не хочется совсем, есть другой класс систем: память, которая работает локально и без вызовов LLM.
Железа это требует немного. Сервер Hindsight у меня это виртуалка на 2 vCPU и 4 ГБ памяти, база в общем Postgres. Перенос истории из agentmemory 28–29 сентября занял 4,6 часа извлечения (6 164 вызова Sol, 17,6 млн входных токенов) и 18,5 часа консолидации в одну очередь. Недельное окно подписки Codex за это время выросло с 31 до 45%. База после переноса весила 1,3 ГБ.
У подписок есть обратная сторона. 6 ноября OpenAI отозвал OAuth-вход, через который Hindsight ходит в Codex, и извлечение фактов встало, пока вход не восстановили: поиск по записанному работал, новые сессии в факты не превращались. Для личной памяти это терпимо. Для командной я бы ставил запасного провайдера на извлечение, как уже стоит на консолидации.
Одна память на несколько агентов и на команду
Один банк хорошо работает, пока им пользуюсь я один. Как только появляются автономные агенты и другие люди, встаёт вопрос доступа.
У агентов моего продукта CopyFast своя память: отдельный экземпляр Hindsight с банком copyfast, без доступа к банку pavel. Причина техническая: в открытой версии один API-ключ открывает все банки экземпляра, и агент на сервере с этим ключом читал бы мою личную память. 8–9 октября я развернул второй экземпляр и перенёс туда 895 документов по проекту, из банка pavel при этом ничего не удалялось.
В ноябре ту же схему я поставил команде разработки на стороне: банк на каждый продукт плюс общий инфраструктурный, плагин выбирает банк по имени репозитория через карту, у каждого человека свой ключ. Серверное расширение проверяет ключ, разрешённые банки и ставит на факты тег с логином. Штатный ключ раздавать нельзя по той же причине: он открыл бы все банки сразу.
В компании мы делаем вторую версию корпоративного агента, память будет на уровнях сотрудника, отдела и компании, пилот планируется на части пользователей. Думаю, уровни и решают: личное остаётся у человека, командное видит команда, а общее для компании пишется редко и проверяется людьми. Память в такой схеме это часть обвязки агента, такая же, как инструменты, права и песочница.
Что сделать сегодня
Если у тебя Claude Code, открой оглавление памяти текущего проекта и посчитай строки: wc -l ~/.claude/projects/*/memory/MEMORY.md. Всё, что ниже двухсотой строки, агент на старте не видит. Разнеси детали по заметкам и оставь в оглавлении по строке на каждую, с датой.
Если нужна общая память для нескольких агентов, не начинай с облака. Hindsight поднимается одной командой Docker из README проекта, а плагин для Claude Code и Codex ставится так:
npx @vectorize-io/hindsight-coding-agents install claude-code codex
До первого retain задай банку миссию извлечения и включи Memory Defense. Потом неделю смотри, что попадает в банк, и режь приток раньше, чем наращивать хранилище. Больше про агентов, их обвязку и автоматизацию в разделе «Агенты и автоматизация».
Читайте также
- Память AI-агентов: контекст, RAG, графы и mem0: обзор инструментов памяти, карта вариантов вместо одного кейса
- Claude Import Memory: как перенести память из ChatGPT: что умеет перенос памяти между чатами
- Hermes Agent: автономный AI-агент от Nous Research: агент для сервера, который помнит сессии и дописывает себе навыки
- Субагенты в Codex: настраиваем AI-команду: как делить работу между агентами и не плодить лишние сессии
- 8 уровней агентного инжиниринга: где память стоит среди остальных частей агентной системы


